生成式 AI 中枢与应用集成
项目 |
内容 |
|---|---|
官方仓库 |
SAP-samples/ai-core-samples、SAP AI Core / Generative AI Hub 文档 |
业务场景 |
把 LLM 接入业务应用:提示模板、文档 grounding、向量检索、模型评估 |
技术栈 |
SAP AI Core、Generative AI Hub、Orchestration Service、SAP Cloud SDK for AI、SAP HANA Vector Engine |
对应课程 |
|
对应路径 |
第 8 条、第 9 条 |
为什么值得做:企业场景里难的不是调用模型,而是 grounding——让模型基于你自己的数据作答。 这个领域变化很快,所以本案例只列稳定的入口和做法。
动手要点:
先把一次最小的 Orchestration Service 调用跑通,再加提示模板。
做 grounding 时,先跟着
AIG00里的文档 grounding 单元动手,不要一上来就做向量检索。
本页内容抓取自官方仓库 SAP-samples/ai-core-samples,共收录 25 篇官方文档(README 与 docs)。原仓库内容版权归 SAP SE,遵循其许可证。
ai-core-samples
本仓库收录示例 notebook 与工作流模板,帮助读者快速动手体验 SAP AI Core。
免责声明:教程与 notebook 中都是示例代码,仅用于赋能培训,不适用于生产环境。
这些示例 notebook 与工作流模板演示了如何把简单的业务 ML 用例产品化到 SAP AI Core 上。 整体思路是「即插即用」,但在使用 notebook 与工作流模板之前,必须先满足一些前置条件。
前置条件:
请先完成下面链接中列出的教程 https://developers.sap.com/group.ai-core-get-started-basics.html
在使用模板之前,请先准备一个 SAP AI Core 实例。你也可以使用 SAP AI Core 免费版(free-tier)来运行示例 notebook
请确保你拥有一个具备读写权限的 GitHub 账号
请确保你可以访问类似 AWS 的对象存储,并且已经创建好占位目录结构
请确保你可以访问 DockerHub 或 Docker,用于构建镜像
内容结构
示例 notebook 与工作流模板(yaml 文件)都放在 Tutorial 目录下。 Tutorial 目录包含 2 个主目录。 1.Create Your First Machine Learning Project using SAP AI core 该教程我们已经在 developers.sap.com 上创建过(https://developers.sap.com/group.ai-core-get-started-basics.html) 教程被拆分为 6 个部分,每个部分都建立了子目录,各部分的 notebook 与模板放在对应的子目录中。
许可证
Copyright (c) 2022 SAP SE or an SAP affiliate company. All rights reserved. 本项目依据 Apache Software License version 2.0 授权,除非在 LICENSE 文件中另有说明。
许可证
Copyright (c) 2022 SAP SE or an SAP affiliate company. All rights reserved. 本项目依据 Apache Software License version 2.0 授权,除非在 LICENSE 文件中另有说明。
AI core
本目录收录示例 notebook 与工作流模板,帮助读者快速动手体验 SAP AI Core。
免责声明:教程与 notebook 中都是示例代码,仅用于赋能培训,不适用于生产环境。
这些示例 notebook 与工作流模板演示了如何把简单的业务 ML 用例产品化到 SAP AI Core 上。整体思路是「即插即用」,但在使用 notebook 与工作流模板之前,必须先满足一些前置条件。
内容结构
本目录分为 2 个子类:
当前收录的教程有:
README
这些是示例模板,用于展示工作流中特定 annotation/修改项的用法
README
从 SAP AI Core 入门,学习基础知识,创建你的第一个 AI 工作流,并把机器学习代码迁移到生产云环境。
使用 Computer Vision Package 与 SAP AI Core 创建目标检测项目
把 computer vision package 集成到 SAP AI Core,创建一个 AI 工作流来训练目标检测模型,再部署该模型用于电表读数识别。
时长:1 小时 45 分钟
级别:高级
标签:人工智能、SAP AI Launchpad、教程、机器学习、SAP AI Core、高级
本教程由 3 个部分组成:
1. 为 SAP AI Core 搭建 Computer Vision Package
完成 Python 环境准备,安装 computer vision package 及其依赖(如 PyTorch 与 Detectron2)。安装 SAP AI Core SDK,以便用 Python 与 SAP AI Core 交互。2. 使用 Computer Vision Package 训练电表读数 AI 模型
使用集成在 SAP AI Core 中的 computer vision package,训练一个读取电表的 AI 模型。3. 使用 Computer Vision Package 部署电表读数 AI 模型
在 SAP AI Core 中部署目标检测模型,用于电表读数识别。
AIW Cloud Connector 演示
本示例演示如何在 AI-Workbench 中使用 Connectivity 服务,与外部系统或本地(on-premise)系统建立通信。
构建 Docker 镜像
要构建 docker 镜像,请先确认已通过 docker login aiwdemos.common.repositories.cloud.sap 登录仓库。然后用下面的命令构建并推送镜像。注意推送正确的版本。
cd images

docker build . -f Dockerfile -t aiwdemos.common.repositories.cloud.sap/aiw-cc-demo:0.1

docker push aiwdemos.common.repositories.cloud.sap/aiw-cc-demo:0.1
演示
请查看 notebook demo.ipynb。
免责声明
该脚本只把 ServingTemplate 的 predictor spec 从 KFServing v1alpha2 更新为 KServe v1beta1 spec,不做其他任何修改。建议不要未经内部验证、未评估质量与 IT 标准就把模板直接用于生产环境。
请注意:
除脚本本身外,不涉及任何文件上传。
该脚本不会把用户系统中的其他文件作为输入。
除重新生成 AI Core 已有的 .yaml 文件外,该脚本不生成任何其他格式的文件。
强烈建议不要修改该脚本,也不要把它复用于 SAP 建议之外的其他场景。
该脚本仅用于指导与开发,其所有权与责任不在 SAP 管辖范围内。
上述脚本应生成输出文件 test.mod.yaml,并使用 v1beta1 spec
修补 ServingTemplate
该脚本把 ServingTemplate 的 apiVersion kubeflow.org/v1alpha2 修补为 kserve.io/v1beta1
准备工作
执行一次以下操作,并使用 python3 虚拟环境:
创建 python3 虚拟环境
$ ./setup.sh
venv: 20220810_0935_env
Collecting ruamel.yaml
  Using cached ruamel.yaml-0.17.21-py3-none-any.whl (109 kB)
Collecting ruamel.yaml.clib>=0.2.6
  Using cached ruamel.yaml.clib-0.2.6-cp310-cp310-macosx_10_9_universal2.whl (149 kB)
Installing collected packages: ruamel.yaml.clib, ruamel.yaml
Successfully installed ruamel.yaml-0.17.21 ruamel.yaml.clib-0.2.6
WARNING: You are using pip version 22.0.4; however, version 22.2.2 is available.
You should consider upgrading via the '/Users/i564554/scripts/20220810_0935_env/bin/python3 -m pip install --upgrade pip' command.

usage: ./setup.sh [python3 env location]

    This script will setup the python3 venv.
    If is not specify a directory will be create for you.

Usage steps after setup.

    1. source 20220810_0935_env/bin/activate

    2. python3 v1alpha2_to_v1beta1.py --help
完成设置
$ source 20220810_0935_env/bin/activate
对 yaml 执行迁移
$ python3 v1alpha2_to_v1beta1.py ./test.yaml

# Above script should create output file names test.mod.yaml with v1beta1 spec
帮助信息
$ python3 v1alpha2_to_v1beta1.py --help
usage: v1alpha2_to_v1beta1.py [-h] [-i | -t] yaml_filename

positional arguments:
  yaml_filename  ServingTemplate Yaml

  options:
    -h, --help     show this help message and exit
    -i             Inplace yaml update
    -t, --test     Test the yaml file need modification
迁移 yaml 时的错误码
代码 |
说明 |
|---|---|
0 |
ServingTemplate 的 apiVersion 不是 |
1 |
ServingTemplate 的 kind 不是 |
2 |
ServingTemplate 的 |
3 |
ServingTemplate 的 |
4 |
ServingTemplate 缺少 |
6 |
ServingTemplate 缺少 |
7 |
ServingTemplate 使用 v1beta1 spec,但缺少 |
8 |
ServingTemplate 使用 v1beta1 spec,未定义 predictor 内容 |
9 |
ServingTemplate 使用 v1beta1 spec,未定义 predictor 内容 |
9.1 |
ServingTemplate 使用 v1beta1 spec,找不到 imagePullSecrets |
10 |
ServingTemplate 使用 v1beta1 spec,未定义 predictor 内容 |
11 |
ServingTemplate 使用 v1alpha2 spec,但缺少 |
12 |
ServingTemplate 使用 v1alpha2 spec,未定义 predictor 内容 |
13 |
ServingTemplate 使用 v1alpha2 spec,未定义 predictor 内容 |
14 |
ServingTemplate 使用 v1alpha2 spec,未定义 predictor 内容 |
15 |
ServingTemplate 使用 v1alpha2 spec,找不到 |
Business AI week
前置条件
具备 SAP Extended Plan 的 AI Core 与 AI Launchpad 访问权限
已启用向量存储(Vector store)的 HANA 数据库
培训期间需要向用户提供 HANA 凭据(每位培训用户使用独立账号)、AI Core 凭据与 Reddit 凭据
利用 RAG embedding 增强开发者支持
Bob 是 XYZ 公司的一名内容开发者。他的团队维护一个能简化公司内外软件开发流程的 node 库,并为该库编写了专门的文档。但使用该库的开发者经常遇到问题并联系 Bob。为了让工作轻松些,Bob 决定在这个用例中使用生成式 AI。
Bob 使用 Generative AI Hub SDK 为他的库搭建了一个帮助门户。他希望通过集成 RAG(Retrieval-Augmented Generation)embedding 来提升帮助门户的效果,让开发者针对 node 库的提问能得到更贴合上下文的回答。
工作流 1
在 AI core 上配置 LLM
Bob 在 AI-Core 工作区中进入 ML Operations -> Scenarios。
他确认 foundation-models 场景存在。
Bob 进入 ML Operations -> Configurations,新建一个 configuration:
为其取一个合适的名字。
选择 foundation-models 场景。
选择版本与 executable ID。
他设置输入参数,指定模型名称与版本。
Bob 检查并创建该 configuration。
模型部署:
Bob 为配置好的模型创建 deployment,把时长设置为 standard。
部署状态变为 RUNNING 后,他确认模型可用。
模型集成:
Bob 通过运行 pip3 install generative-ai-hub-sdk 安装 Generative AI Hub SDK。
他用存放在本地目录中的 AI core 密钥配置该 SDK。
Bob 通过 pip3 install notebook 安装 Jupyter Notebook。
他使用命令 python3 -m notebook 打开一个 Jupyter Notebook 实例。
请使用系统环境文件(system landscape file)中给出的 AI Launchpad 链接。请使用分配给你的用户名(例如 sysops-generic-userXX@sap.com)
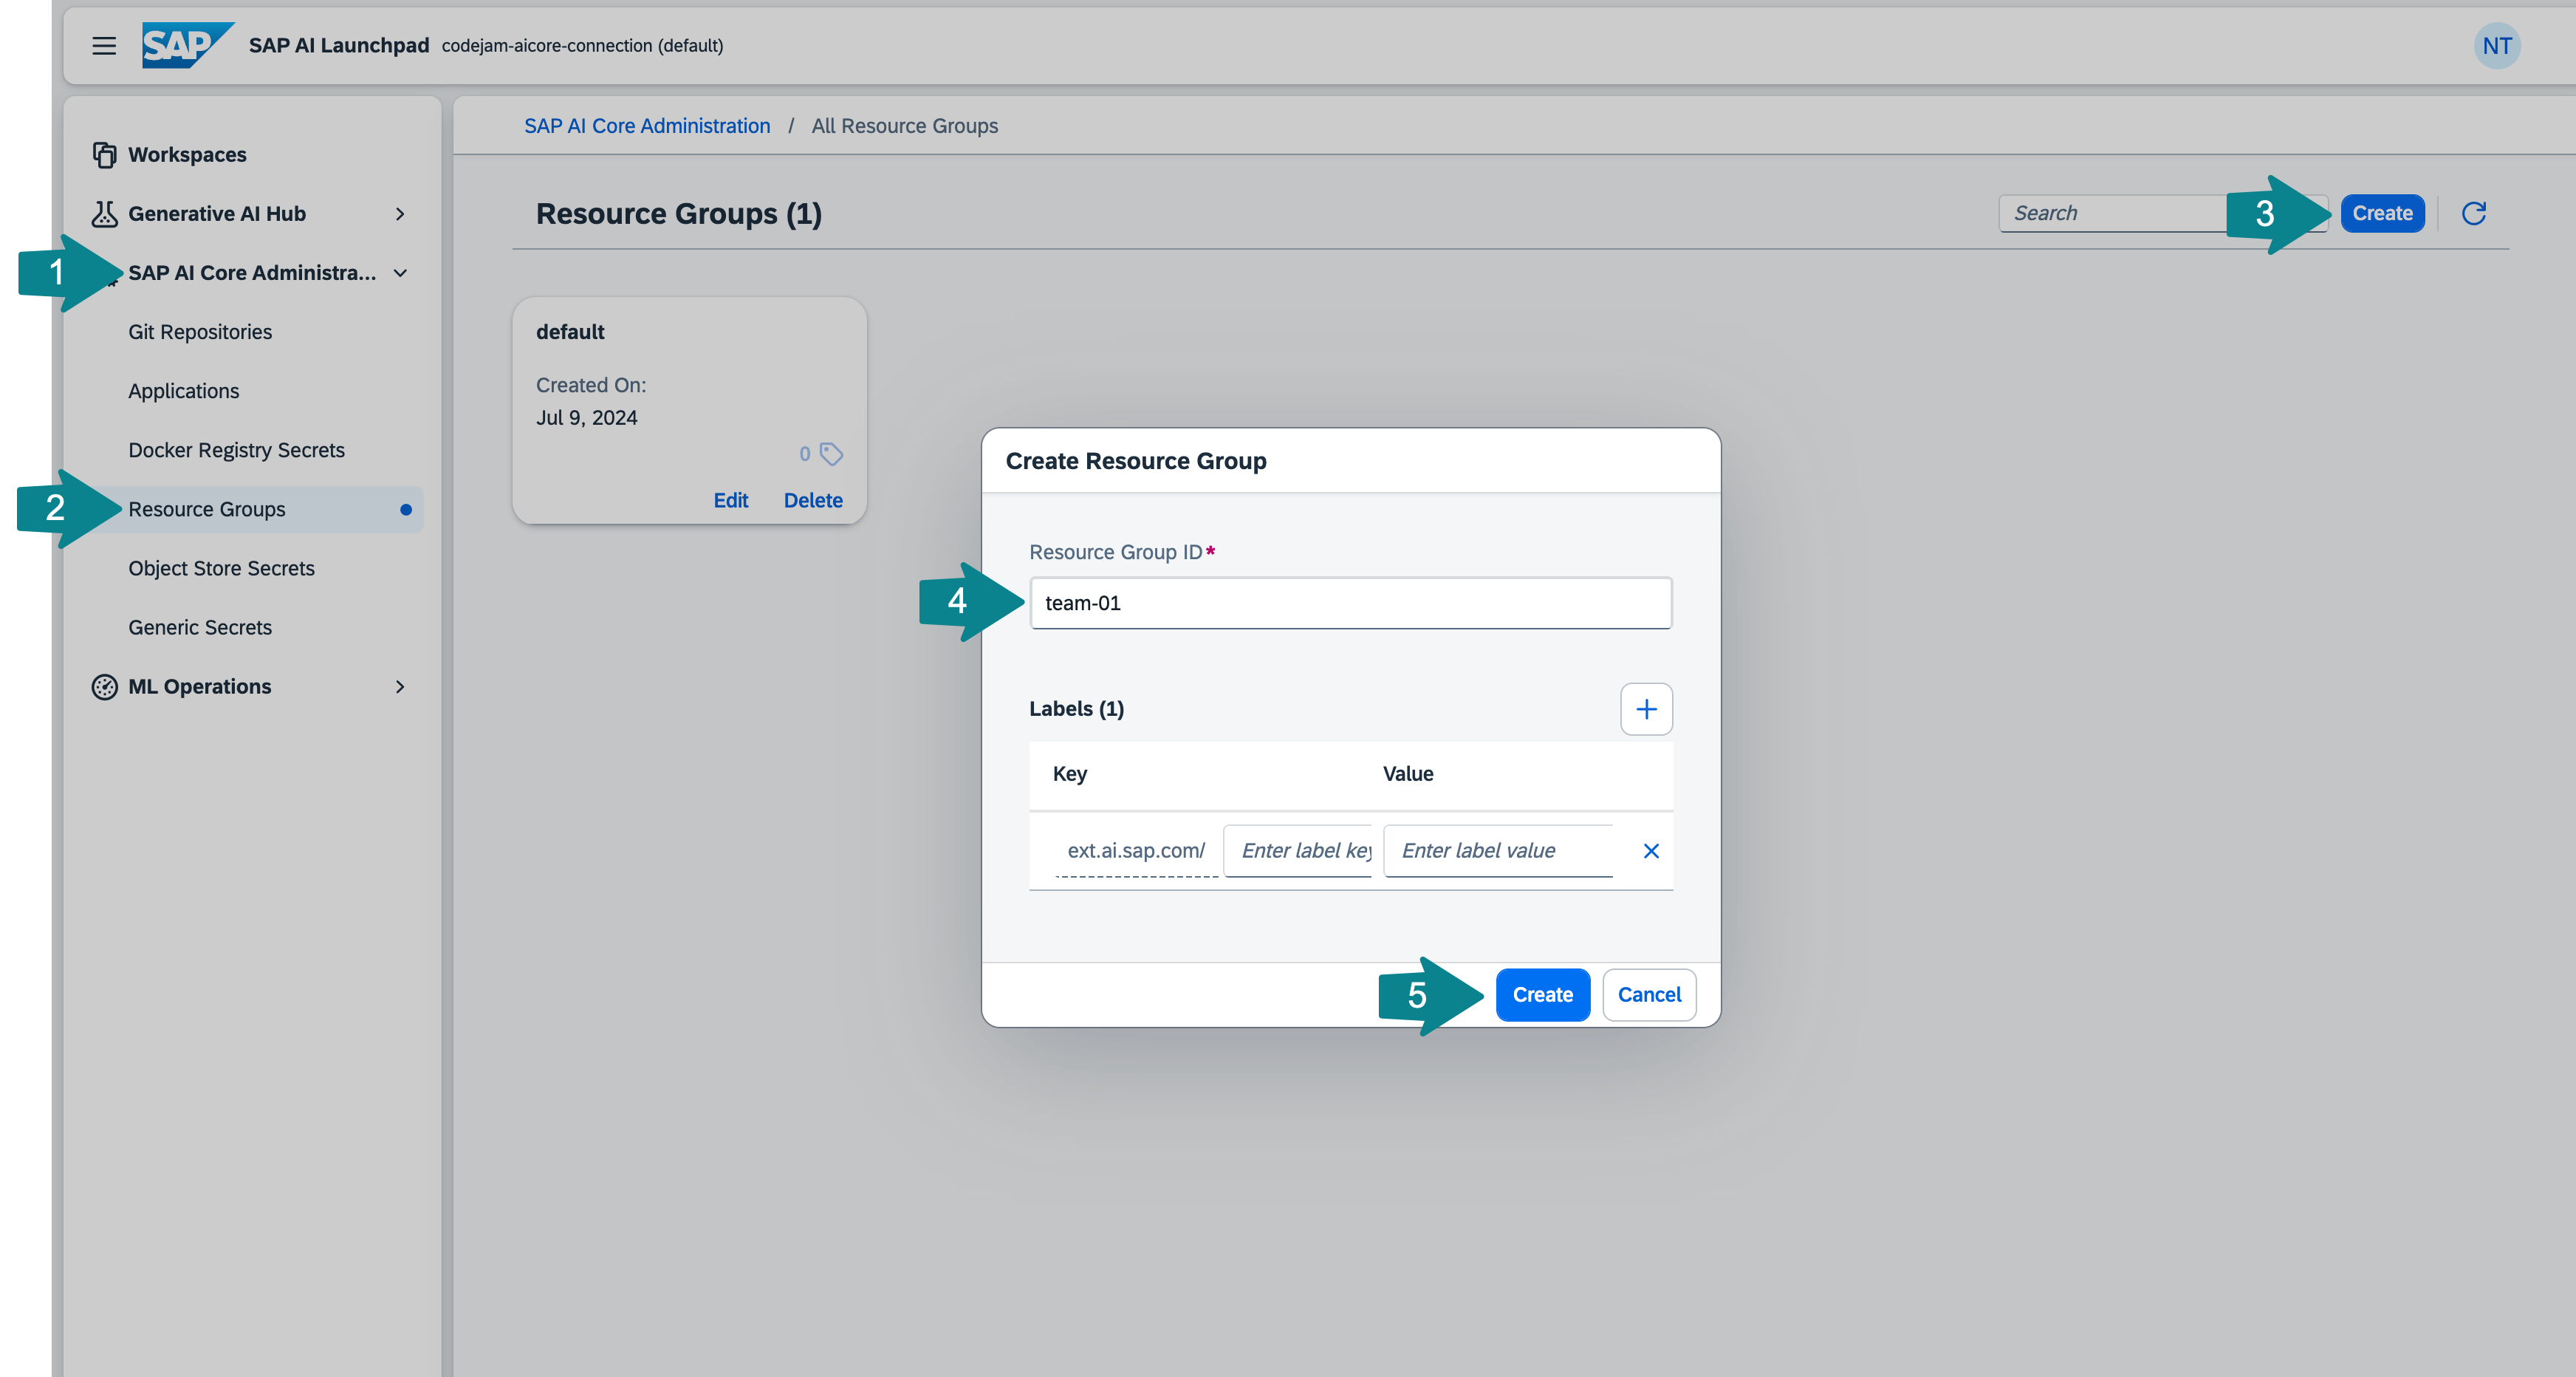
在你的 SAP AI Launchpad 实例中,创建属于你自己的 resource group。进入 SAP AI Core Administration -> Resource Groups,点击 Create。
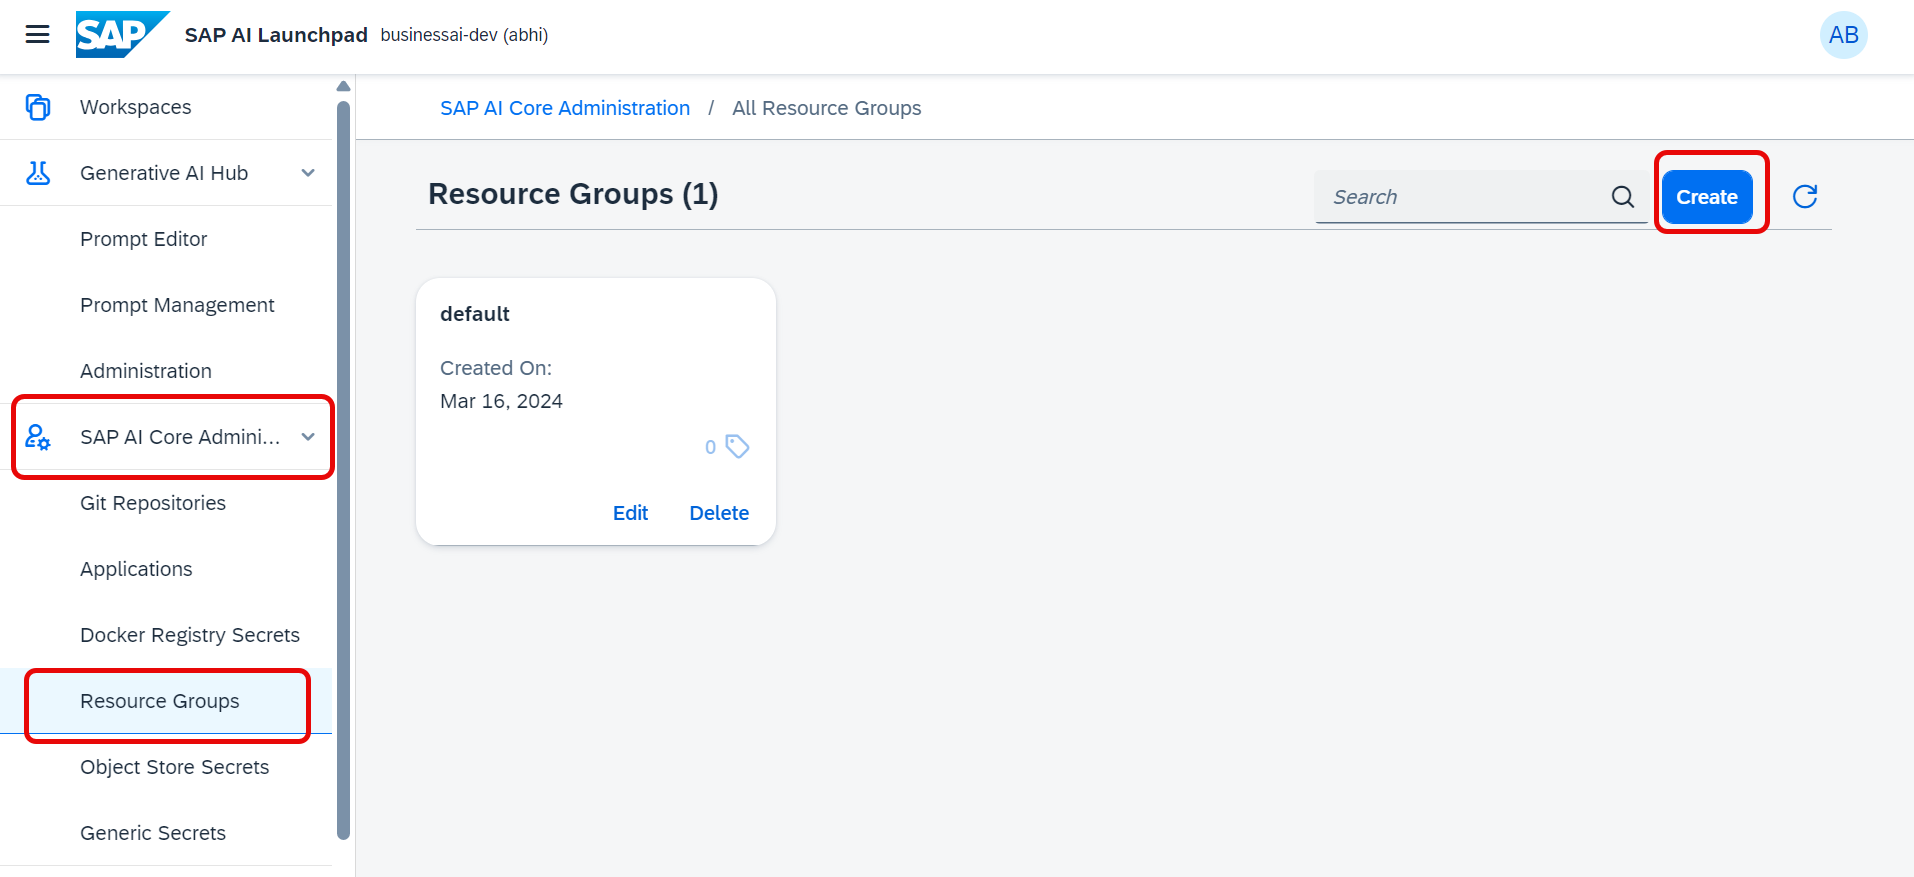
resource group 的名称与你在 launchpad 中的用户名保持一致。不要创建名为 default 的 resource group。下面截图里用的是 default resource group,但做练习时你必须使用自己的 resource group。
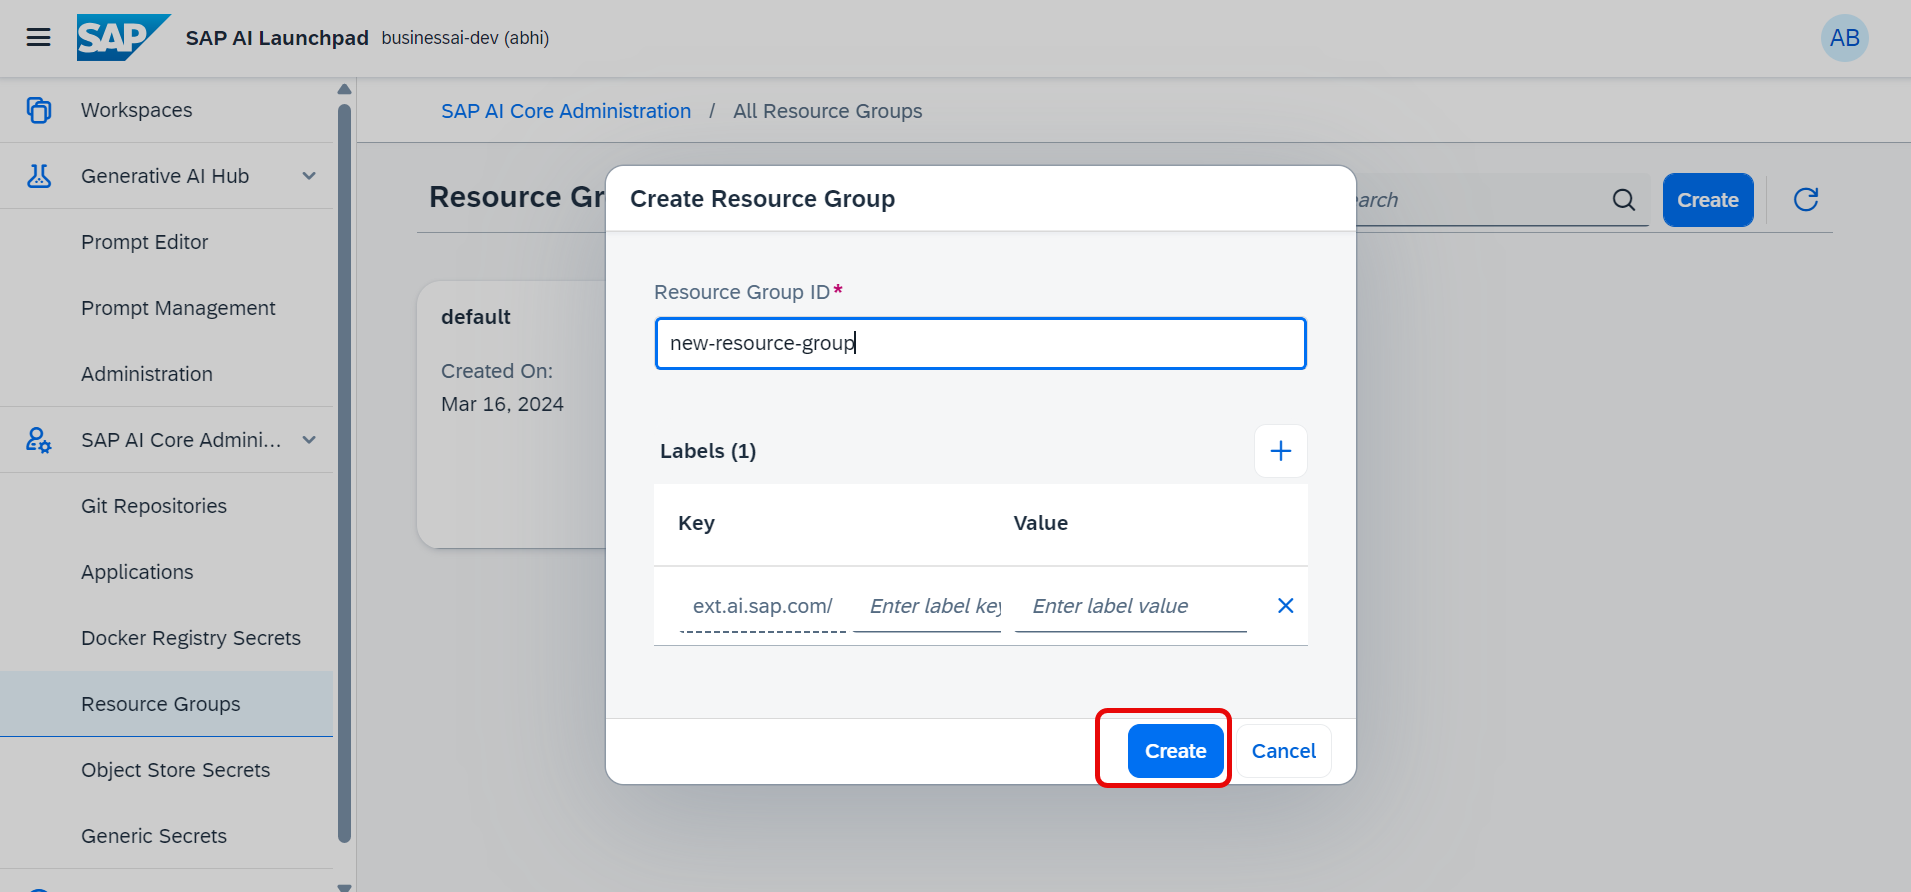
现在通过 Workspaces -> your_resource_group 进入你的 resource group。
如果看不到,刷新浏览器即可显示你的 resource group。
进入 ML Operations -> Scenarios,检查你的 AI-Core 工作区中是否存在 foundation-models 场景。

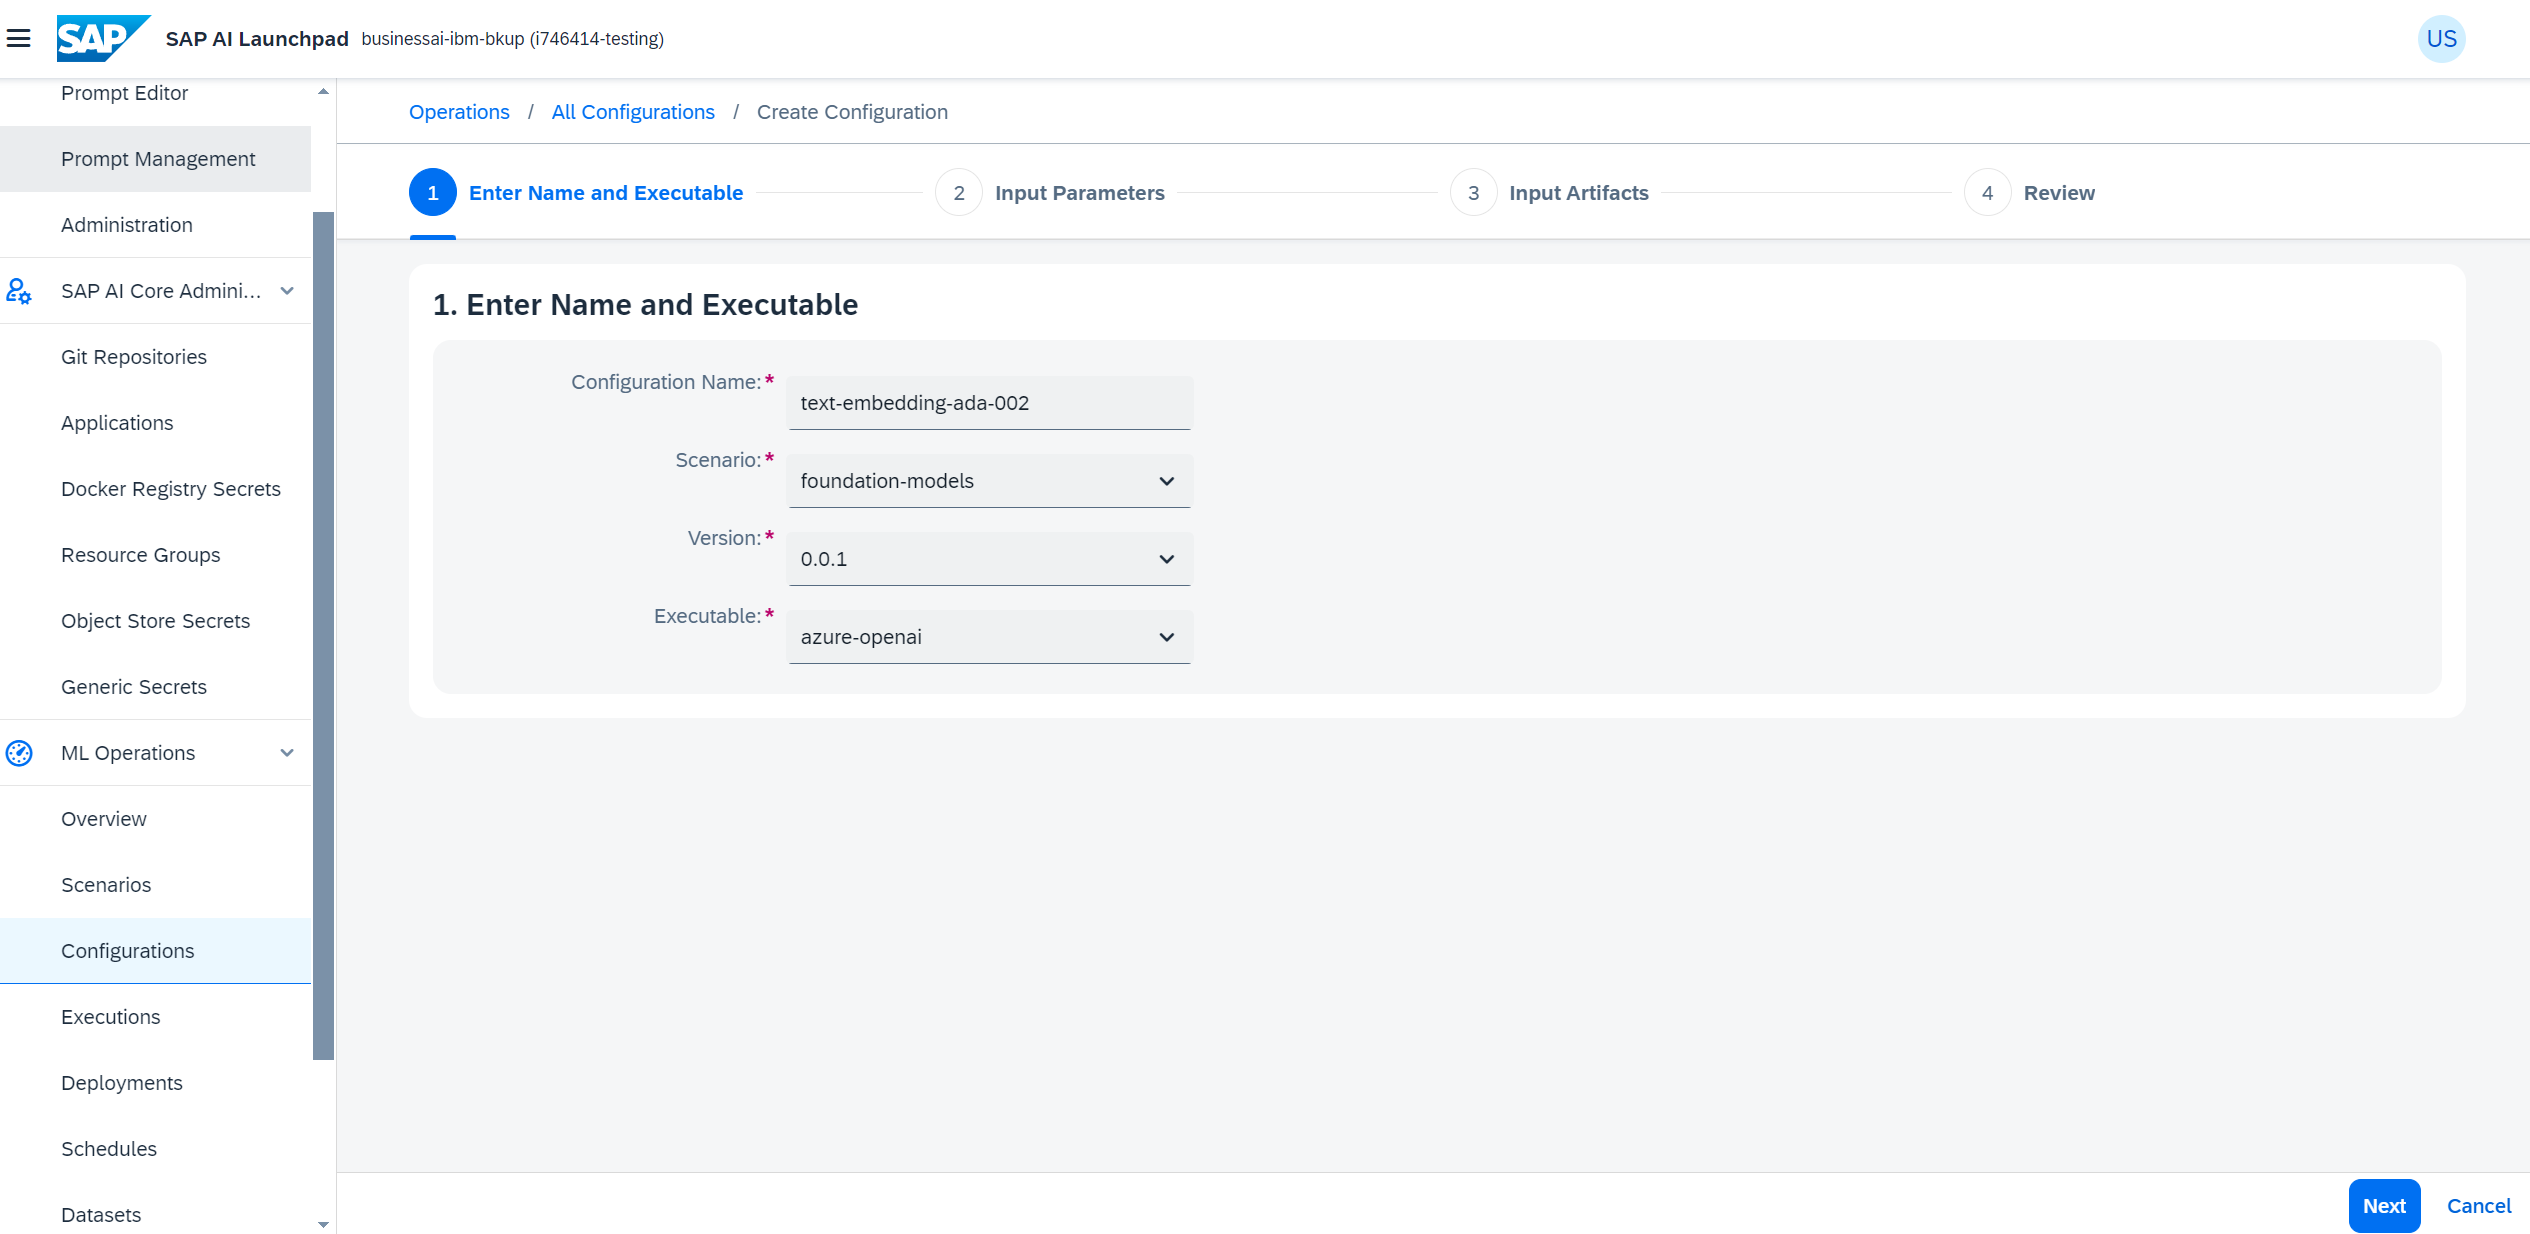
进入 ML Operations -> Configurations,点击 Create 按钮

为 configuration 取一个名字。
选择 foundation-models 场景。
选择版本。
选择 Executable ID。

在输入参数(input parameters)中填写你要使用的模型名称与版本。

这里创建一个针对 text-embedding-ada-002 模型的 configuration。
以下是目前可用的模型:

依次点击 Next -> Review -> Create 完成 configuration 创建。
你可以通过创建虚拟 LLM deployment 让 LLM 可供使用。每个模型与模型版本只需要创建一次。
configuration 创建完成后,点击 Create Deployment。

把时长设置为 standard,然后点击 Review 按钮。

创建 deployment 后,等待当前状态变为 RUNNING。

deployment 运行起来后,你就可以在 Generative AI Hub 中访问这些模型了。
试用模型
Prompt Editor
在 AI Launchpad 中进入 Generative AI Hub。在 prompt editor 中,你可以查询自己的 prompt 并保存回答。

在 Prompt Editor 页面为你的 prompt 取一个名字。你还可以选择性地填写 collection name。名称与 collection 名称在 prompt management 中会很有用。

向下滚动并点击箭头,选择 Model 与参数。

点击这里选择你想要的模型。
你也可以在这里设置附加参数。

Frequency Penalty 取值范围为 -2.0 到 2.0。正值会依据新 token 在当前文本中已出现的频率对其进行惩罚,从而降低模型逐字重复同一行的可能性。
Presence Penalty 取值范围为 -2.0 到 2.0。正值会依据新 token 是否已在当前文本中出现过对其进行惩罚,从而提高模型谈论新话题的可能性。
Max-Tokens 允许生成的回答使用的最大 token 数。
Temperature 采样温度,取值范围为 0 到 2。值越高输出越随机,值越低输出越聚焦、越确定。
选择模型并设置参数后,在 prompt 字段中输入 prompt,点击 Run 按钮得到输出。点击 Save 按钮即可保存回答。

如果想开始一个新的 prompt,点击 Create New 按钮。

点击 Select 按钮可以打开之前保存过的 prompt。

选择 prompt,点击 Select 打开它。

Prompt Management
在 Generative AI Hub 中,你可以在 Prompt Management 页面管理 prompt。进入 Generative AI Hub -> Prompt Management,点击某个 prompt 即可进入其详情页。

在左侧窗格中可以看到该 prompt 的不同版本。选中某个新版本后,页面会显示该版本的详情。
点击 Open in Prompt Editor,在 prompt editor 中打开所选 prompt。
点击 Delete 按钮可以删除 prompt。

AI launchpad 在此部署的 foundation models 后续会在工作坊练习中通过 generative-ai-hub-sdk 用于 grounding。通过 AI Launchpad 做 grounding 的支持会在后续版本中提供。因此请继续按下面的步骤操作
在 Generative AI Hub 中使用 HANA 向量检索做检索增强生成
Bob 用 Python 代码调用 SDK 为查询生成回答。
他格式化查询并调用 Generative AI Hub SDK 获取回答。
实现 RAG embedding:
Bob 把 node 库文档准备成 CSV 格式,每一行代表一个主题。
他连接 HANA 向量存储实例,并创建一张表来保存文档数据。
Bob 向表中写入数据,并创建 REAL_VECTOR 列来保存 embedding。
他使用 Generative AI Hub SDK 定义一个函数,为 prompt 生成 embedding,并用这些 embedding 做相似度检索。
增强查询回答:
Bob 定义一个 prompt 模板,为查询提供上下文。
他修改该函数,基于 prompt 模板查询 LLM(大语言模型)。
Bob 用与 node 库相关的具体查询测试模型回答,确认它能基于 embedding 给出贴合上下文的回答。
检索增强生成通过给 prompt 补充更多上下文,来优化大语言模型的输出。
在本工作坊中,我们使用一份 graph 文档 为模型补充上下文,从而优化模型。从 github 下载该文件并保存到本地。
本工作坊使用 python 完成,因此请确保你已在本地安装了 python。
安装 Python(如果已有 Python 与 Jupyter Notebook,可跳过)
按下面步骤逐步安装 Python 与 Jupyter notebook
1. 检查是否已安装
打开终端或 cmd,输入:
python3 --version
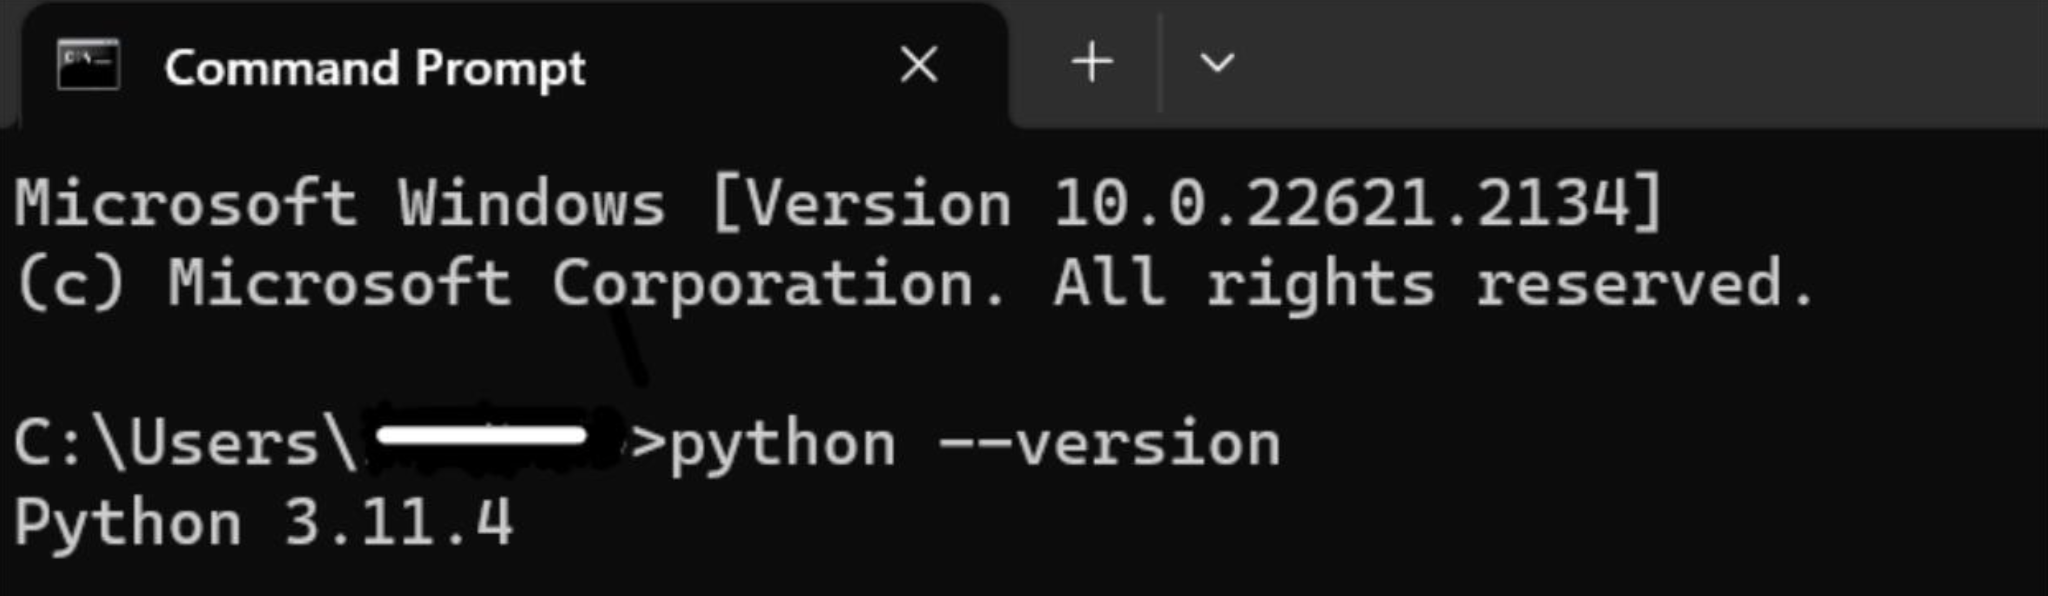
请注意,如果你的版本低于 3.10,需要升级。
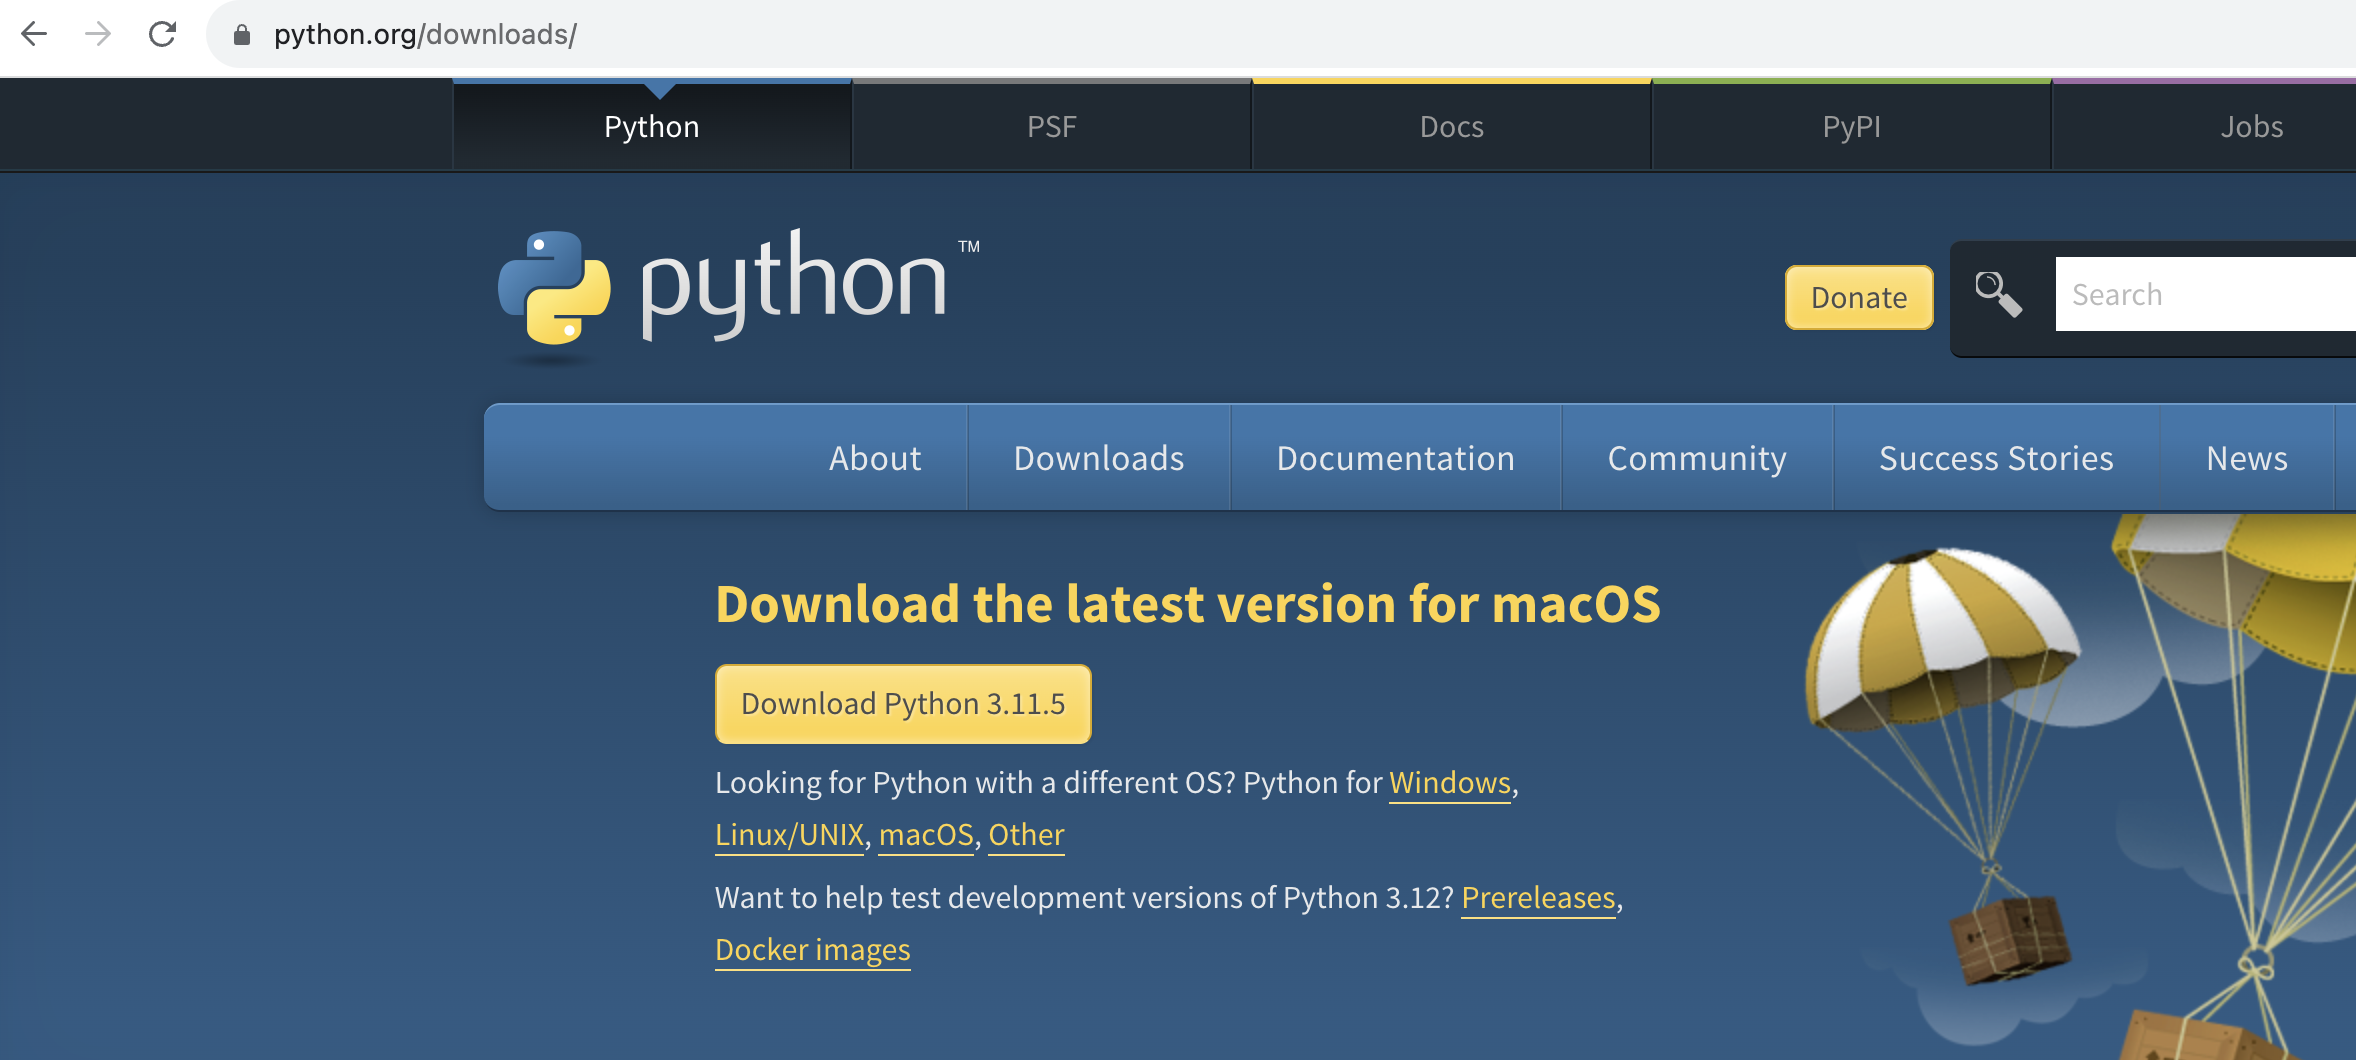
2. 下载安装程序
访问 Python 官方网站,下载适用于 Windows 或 Mac 的最新版本 Python。
3. 运行安装程序
启动安装程序。
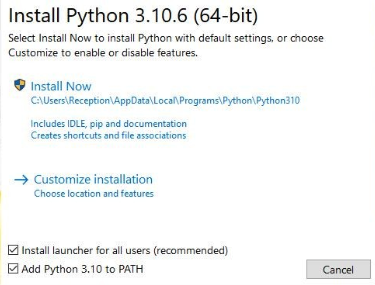
确保勾选「Add Python PATH」。这样从命令行运行 Python 会更方便。
选择「Customize installation」(推荐开发者使用)或「Install Now」(典型设置)。
选择「Customize installation」,确保勾选「pip」与「tcl/tk」进行安装。
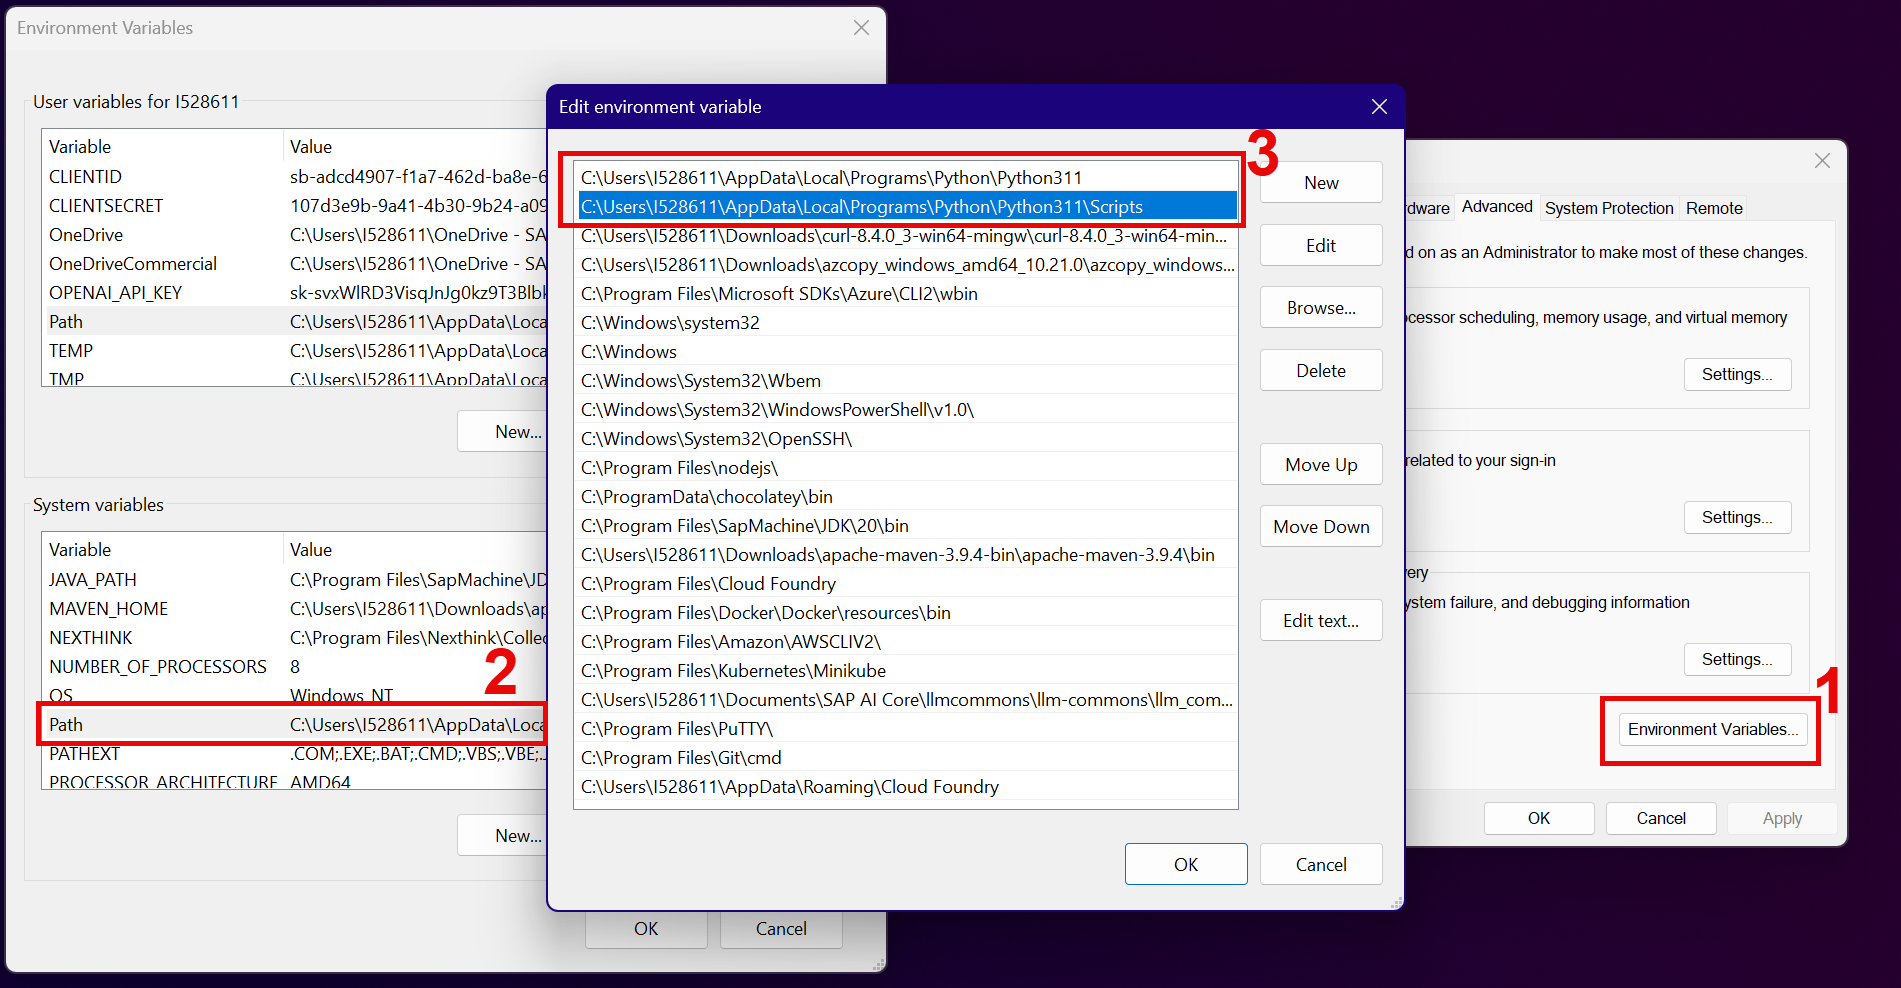
Python 安装完成后,按截图确认 python 与 pip 的 PATH 变量设置正确(仅 Windows)
4. 验证安装
打开 cmd 或终端,输入:
python --version
请注意,如果你的版本低于 3.10,需要升级。
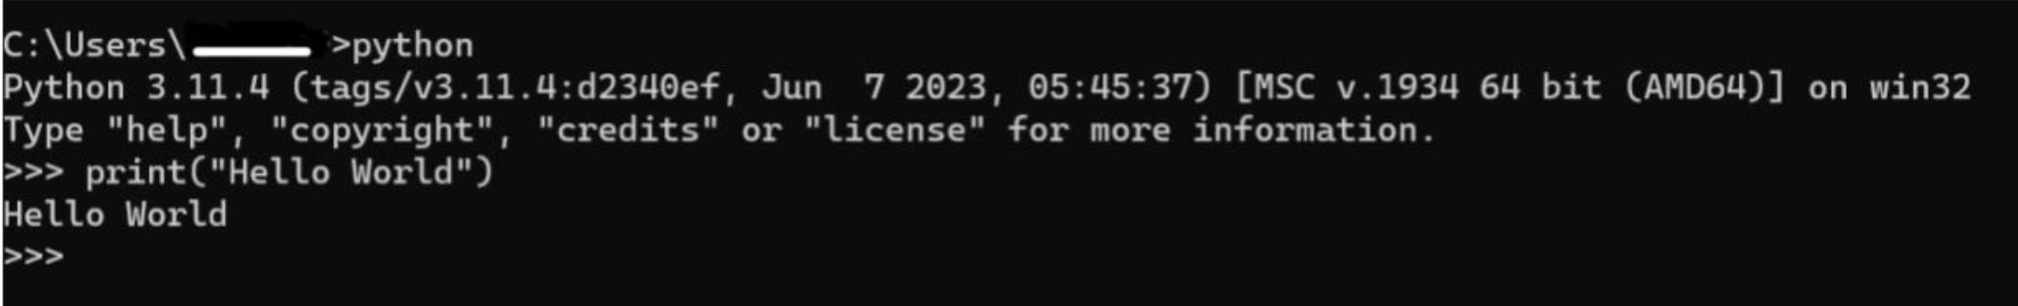
5. 用 hello world 进一步验证
用一个基础的 Python「Hello World」例子再次确认安装是否成功:(在 cmd 或终端中输入)
print("Hello, World!")
6. **安装 Jupyter 或 JupyterLab(两者任选其一即可)
pip3 install jupyter
或
pip3 install jupyterlab
7. 打开 cmd 或终端并运行:
pip3 install generative-ai-hub-sdk
以上命令成功后,请在 cmd 或终端中再运行下面的命令。这样可以确保你安装了运行练习所需的全部库。
pip3 install langchain openai docarray panel jupyter_bokeh redlines tiktoken wikipedia DateTime presidio_anonymizer hana-ml pandas presidio_analyzer
8. 配置 LLM 实例密钥
你需要配置 proxy 模块才能使用大语言模型。
推荐通过配置文件把 AI core 凭据设置为环境变量。该文件的默认路径是 ~/.aicore/config.json。
打开记事本,把下面 json 中的值替换为你从 BTP 下载的 AI core Service key,按 Ctrl + S(mac 上为 Command + O)保存文件。屏幕会弹出对话框,在其中定位到 ~/.aicore/ 目录,把文件保存为 config.json
如果你使用 mac,可能无法直接创建 .aicore 文件夹。这种情况下,用下面的命令创建该文件夹
mkdir ~/.aicore/
现在用下面的命令在 nano 中打开 config.json 文件。
nano ~/.aicore/config.json
在 Windows 上,你可以在终端的用户目录下按下面的结构创建同一个文件夹
现在把下面的 json 脚本粘贴到 config.json 文件中。或者从 Json 文件 下载示例 json
{
  "AICORE_AUTH_URL": "https://* * * .authentication.sap.hana.ondemand.com",
  "AICORE_CLIENT_ID": "* * * ",
  "AICORE_CLIENT_SECRET": "* * * ",
  "AICORE_RESOURCE_GROUP": "* * * ",
  "AICORE_BASE_URL": "https://api.ai.* * *.cfapps.sap.hana.ondemand.com/v2"
}
请把上面的值更新为前面环境文档中提供给你的 AI core Service key。
为 gen-ai-hub-sdk 设置环境变量的另一种 config.json 方式
你可以把这段代码作为 Jupyter notebook 中的第一段代码运行,参考第 9 步了解如何启动/运行 Jupyter Notebook
import os

# please enter the Credentials from your AI core landscape.
env_vars = {
    'AICORE_AUTH_URL' : '<auth_url>',
    'AICORE_CLIENT_ID' : '<client_id>',
    'AICORE_CLIENT_SECRET' : '<client_secret>',
    'AICORE_BASE_URL' : '<api_url>/v2',
    'AICORE_RESOURCE_GROUP' : '<resource_group>',
}

# Set the environment variables using `os.environ`.
for key, value in env_vars.items():
    os.environ[key] = value
9. 打开 Jupyter notebook
输入命令(如果你使用 jupyter)
jupyter notebook
或
输入下面的命令(如果你使用 jupyter lab)
jupyter lab
在 jupyter notebook 中新建一个 notebook,复制下面的代码片段。
要上传 csv 文件,点击 jupyter notebook 中的上传按钮,选择你下载的 csv 文件(GRAPH_DOCU_2503.csv)。
把文档加载到 data 变量中。
import csv

data = []
with open('GRAPH_DOCU_2503.csv', encoding='utf-8') as csvfile:
    csv_reader = csv.reader(csvfile)
    for row in csv_reader:
        try:
            data.append(row)
        except:
            print(row)
现在可以创建到 HANA Vector 存储的连接。把地址、端口号、用户名与密码替换为你凭据中的值。
import hdbcli
from hdbcli import dbapi

cc = dbapi.connect(
    address='<address>',
    port='<port-number>',
    user='<user>',
    password='<password>',
    encrypt=True
    )
HANA 凭据请参考环境文档。
现在我们已经建立了到 HANA 向量存储的连接。该连接会帮助我们在后续步骤中操作向量存储。
HANA 向量存储以表的形式保存数据。要保存我们的数据,可以在 HANA 向量存储中创建一张表。
把 TABLENAME 替换为你自己起的名字。注意:表名只能使用大写字母和数字
# Create a table
cursor = cc.cursor()
sql_command = '''CREATE TABLE TABLENAME(ID1 BIGINT, ID2 BIGINT, L1 NVARCHAR(3), L2 NVARCHAR(3), L3 NVARCHAR(3), FILENAME NVARCHAR(100), HEADER1 NVARCHAR(5000), HEADER2 NVARCHAR(5000), TEXT NCLOB, VECTOR_STR REAL_VECTOR);'''
cursor.execute(sql_command)
cursor.close()
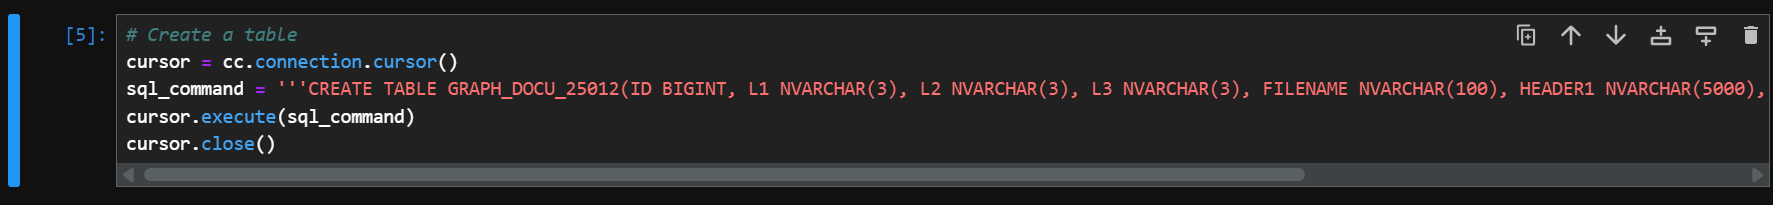
在这个 SQL 命令中,我们创建了一张名为 'GRAPH_DOCU_2503' 的表。你可以起任意名字,但要保证整个过程中使用同一个表名。另外请记住,不能用同一个名字创建多张表。
表创建好后,就可以向表中写入数据了。
把 TABLENAME 替换为你的表名。
cursor = cc.cursor()
sql_insert = 'INSERT INTO TABLENAME(ID1, ID2, L1, L2, L3, FILENAME, HEADER1, HEADER2, TEXT, VECTOR_STR) VALUES (?,?,?,?,?,?,?,?,?,TO_REAL_VECTOR(?))'
cursor.executemany(sql_insert,data[1:])
embedding 是文本数据的向量表示,包含了文本的语义信息。定义一个 get_embedding() 函数,使用 text-embedding-ada-002 模型从文本数据生成 embedding。该函数将用来为用户的 prompt 生成 embedding。
在此之前,请确保你已经在 SAP AI Launchpad 中为 text-embedding-ada-002 创建了 deployment。
# Get embeddings
from gen_ai_hub.proxy.native.openai import embeddings

def get_embedding(input, model="text-embedding-ada-002") -> str:
    response = embeddings.create(
      model_name=model,
      input=input
    )
    return response.data[0].embedding
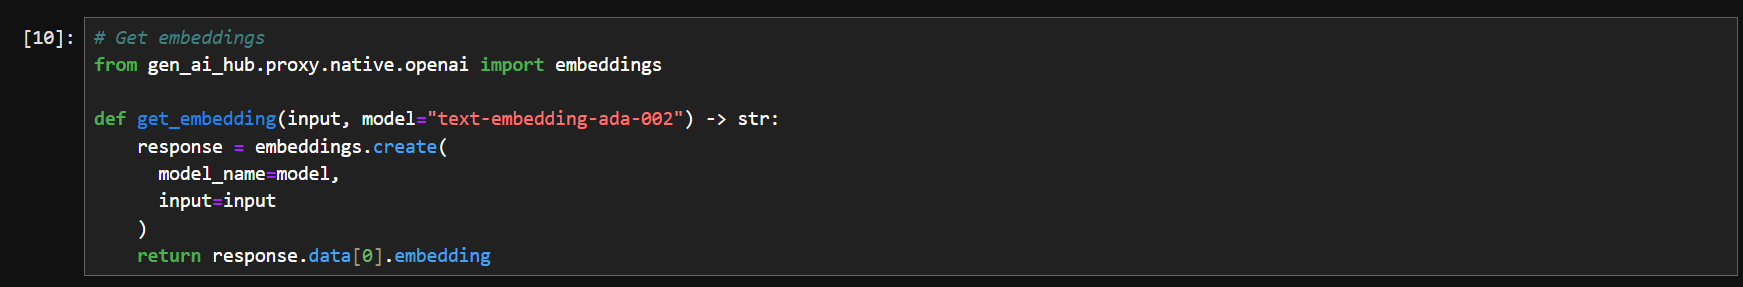
借助 COSINE-SIMILARITY 之类的技术,可以用 embedding 找出彼此相似的文本。你可以用这类技术从 HANA 向量存储中找出与你的 prompt 相似的文本数据。
现在定义一个函数,在数据中做相似度检索。该函数接收查询作为输入,从表中返回相似的内容。
把 TABLENAME 替换为你的表名。
cursor = cc.cursor()
def run_vector_search(query: str, metric="COSINE_SIMILARITY", k=4):
    if metric == 'L2DISTANCE':
        sort = 'ASC'
    else:
        sort = 'DESC'
    query_vector = get_embedding(query)
    sql = '''SELECT TOP {k} "ID2", "TEXT"
        FROM "TABLENAME"
        ORDER BY "{metric}"("VECTOR_STR", TO_REAL_VECTOR('{qv}')) {sort}'''.format(k=k, metric=metric, qv=query_vector, sort=sort)
    cursor.execute(sql)
    hdf = cursor.fetchall()
    return hdf[:k]
我们可以定义一个 prompt 模板,为 prompt 提供上下文。这样当我们把 prompt 传给模型时,模板会为 prompt 补充必要的上下文,从而生成更好的结果。
promptTemplate_fstring = """
You are an SAP HANA Cloud expert.
You are provided multiple context items that are related to the prompt you have to answer.
Use the following pieces of context to answer the question at the end.
Context:
{context}
Question:
{query}
"""
from langchain.prompts import PromptTemplate
promptTemplate = PromptTemplate.from_template(promptTemplate_fstring)
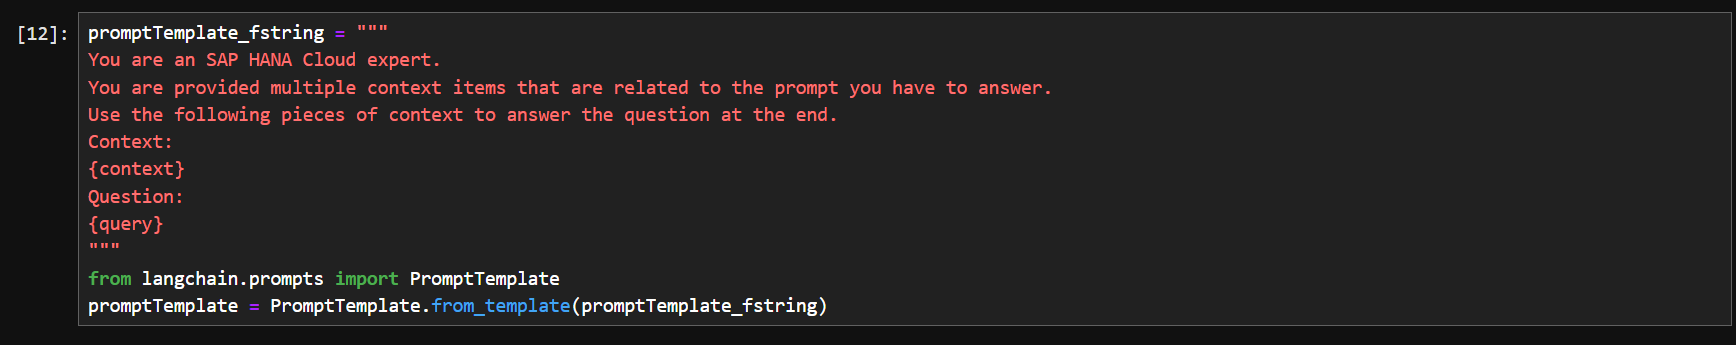
这里我们为 prompt 创建了一个模板。它包含两个变量 'context' 与 'query',这两个变量会在后续步骤中被替换成上下文与查询内容
现在可以定义一个 ask_llm() 函数,用上面的模板查询模型。
!pip install tiktoken
import tiktoken
from gen_ai_hub.proxy.langchain.openai import ChatOpenAI

def ask_llm(query: str, metric='COSINE_SIMILARITY', k = 4) -> str:
    context = ''
    context = run_vector_search(query, metric, k)
    prompt = promptTemplate.format(query=query, context=' '.join(str(context)))
    encoding = tiktoken.get_encoding("cl100k_base")
    num_tokens = len(encoding.encode(str(prompt)))
    print('no of tokens'+ str(num_tokens))
    llm = ChatOpenAI(proxy_model_name='gpt-4-32k',max_tokens = 8000)
    response = llm.invoke(prompt).content
    print('Query: '+ query)
    print('\nResponse:')
    print(response)
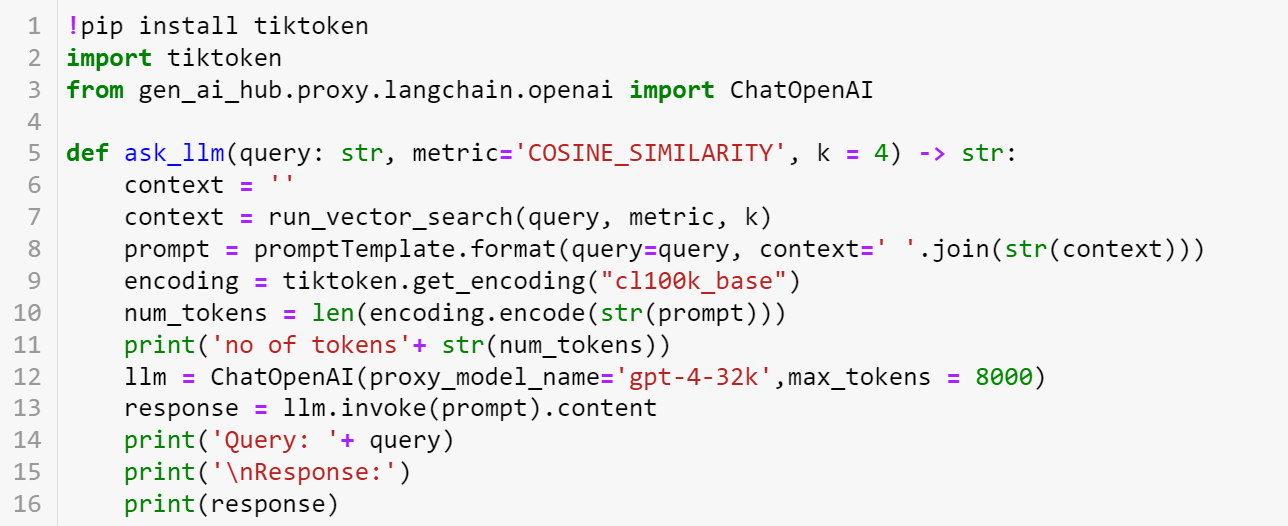
上面的函数把 query 与 context 填入模板生成 prompt,再把该 prompt 传给 LLM 模型并打印回答。
这里我们使用的是 gpt-4-32k 模型。请确保你已经在 AI Launchpad 中为 gpt-4-32K 模型创建了 deployment。
我们可以对比 RAG 生成的输出与直接把 prompt 传给模型时的输出有何不同。如果不用 RAG 直接把 prompt 传给模型,输出会是这样。
query = "How can I run a shortest path algorithm?"
from gen_ai_hub.proxy.langchain.openai import ChatOpenAI
llm = ChatOpenAI(proxy_model_name='gpt-4')
response = llm.invoke(query).content
response
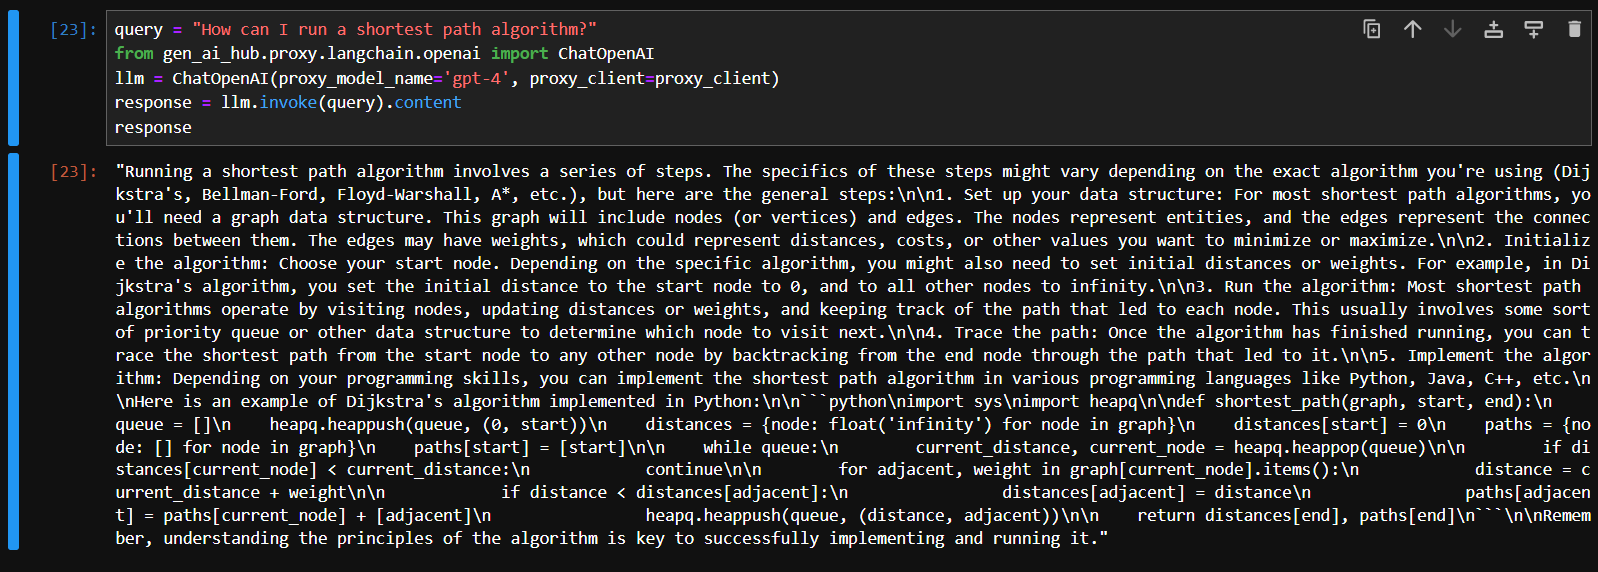
现在把下面的查询传给函数,测试用检索增强生成给出的结果。
query = "I want to calculate a shortest path. How do I do that?"
response = ask_llm(query=query, k=4)
response
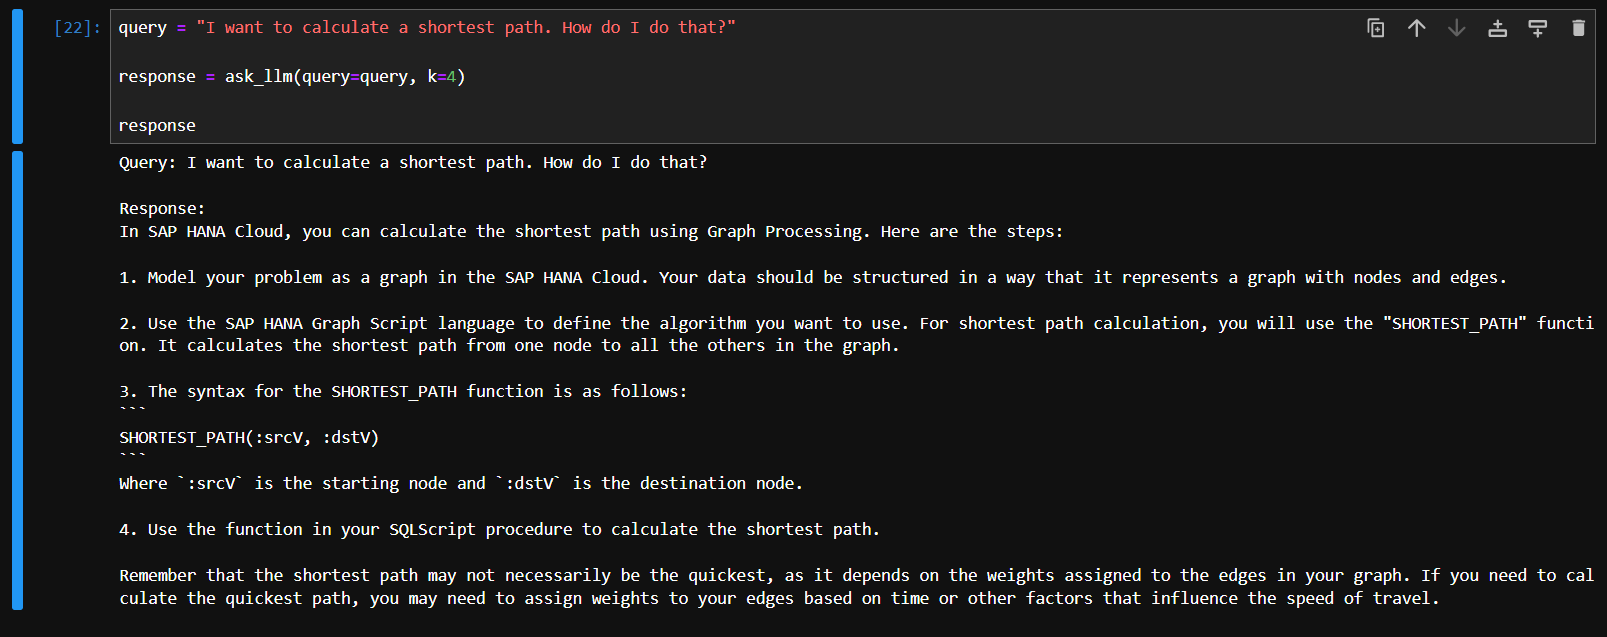
可以看到,使用 RAG 时我们得到了更好的输出。
结果: 在帮助门户中实现 RAG embedding 后,Bob 改善了使用 node 库的开发者的支持体验。帮助门户现在能对查询给出更准确、更贴合上下文的回答,减少了对人工支持的依赖,也让开发者能自行找到解决方案。
用 prompt 驱动模型
借助提示(prompting)技术,LLM 可以完成各种各样的任务。有效使用 prompt,模型可以在以下任务上取得不错的效果
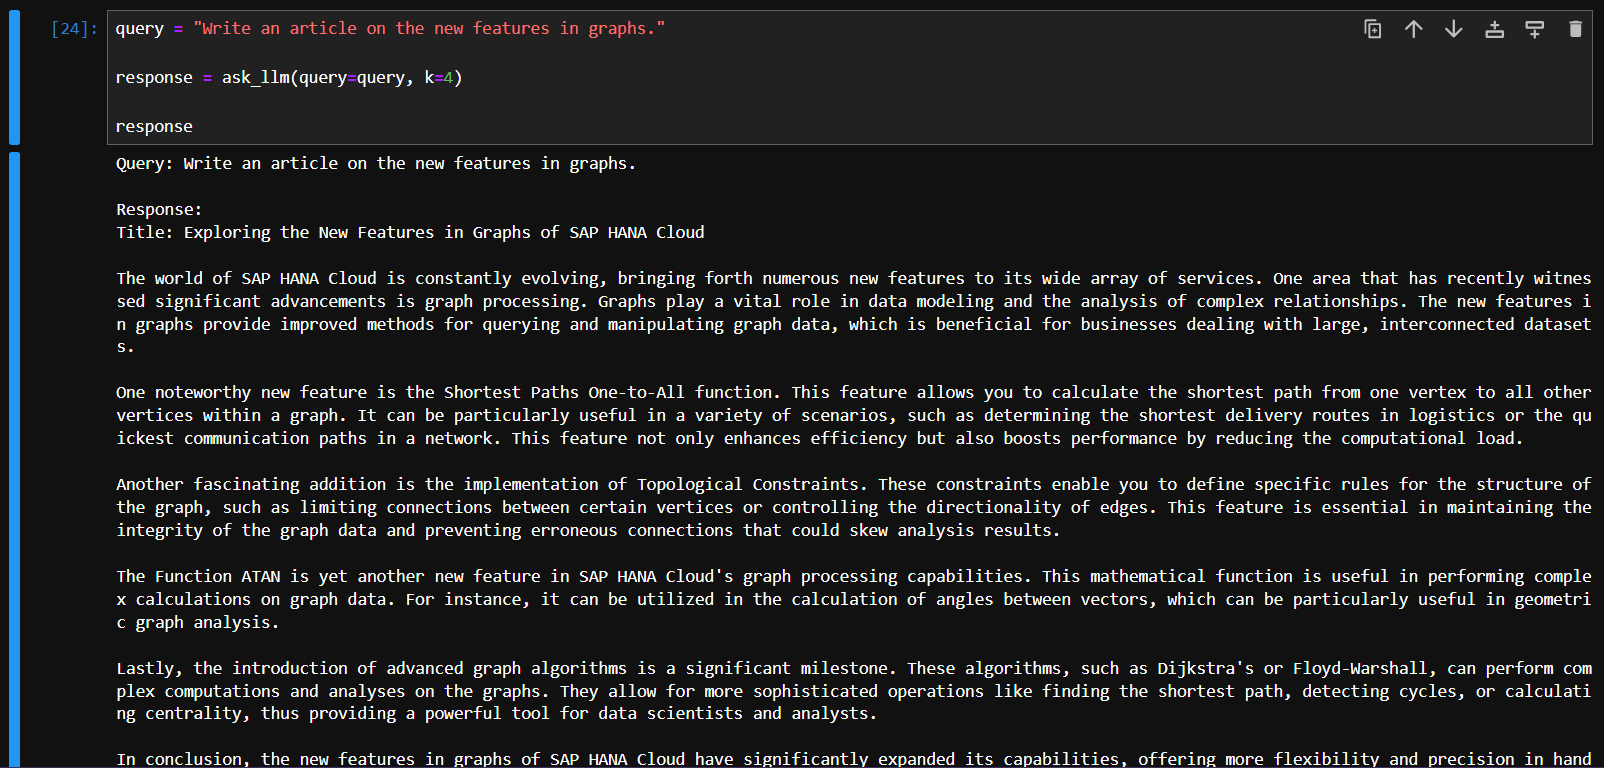
使用 RAG 生成内容
模型可以为文章、博客、故事等生成文本内容。
query = "Write an article on the new features in graphs."
response = ask_llm(query=query, k=4)
response
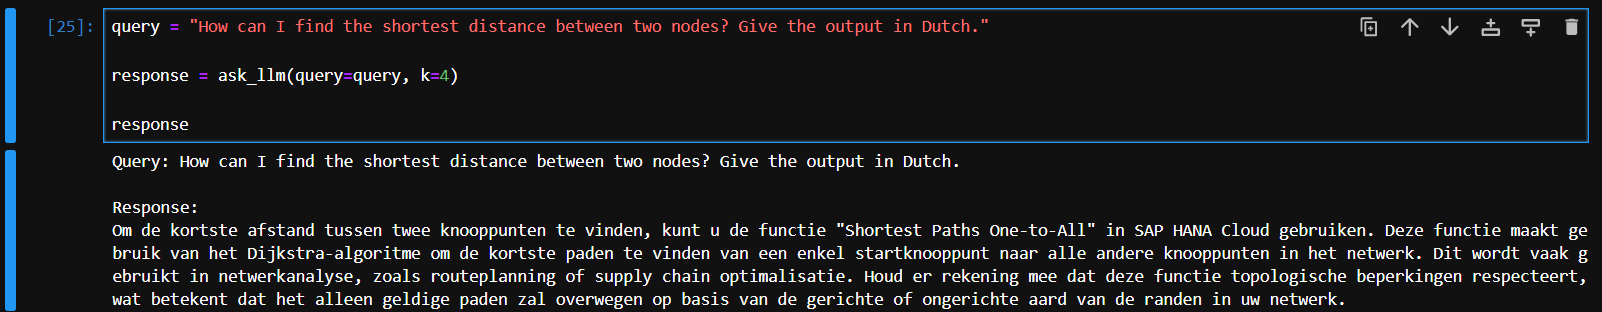
使用 RAG 做语言翻译
如果你希望输出另一种语言,可以在 prompt 中要求模型这么做。
query = "How can I find the shortest distance between two nodes? Give the output in Dutch."
response = ask_llm(query=query, k=4)
response
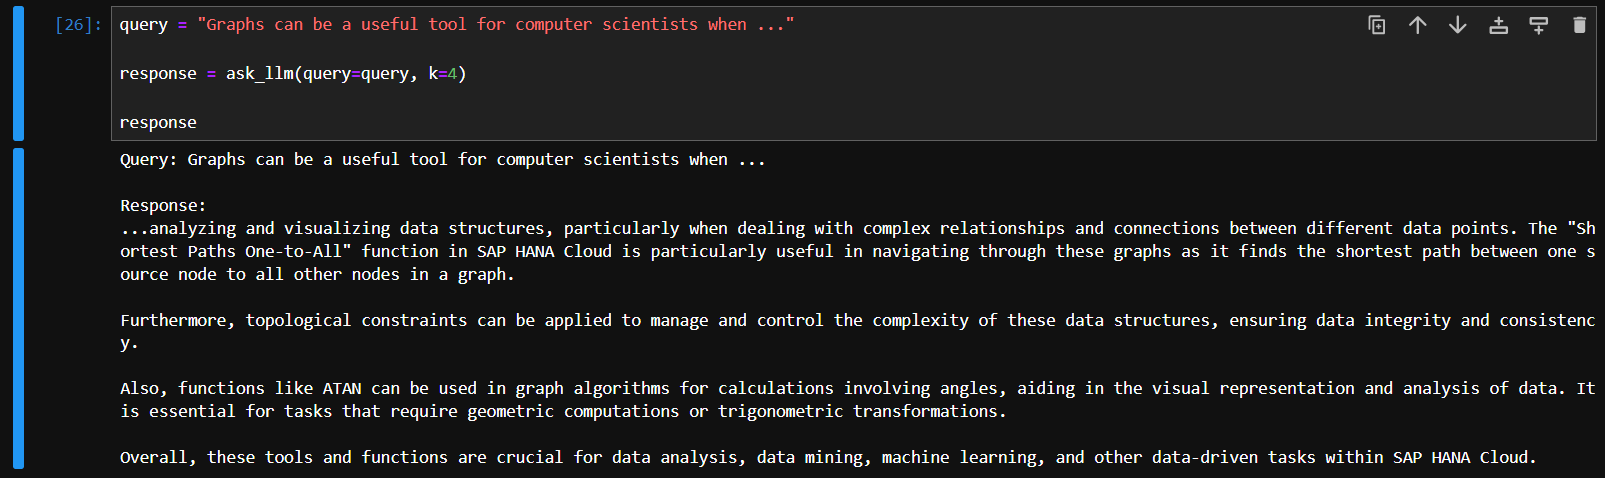
使用 RAG 做文本补全
模型可以用于文本补全。给它一段文本输入,模型会为给定文本给出补全建议。
query = "Graphs can be a useful tool for computer scientists when ..."
response = ask_llm(query=query, k=4)
response
使用 RAG 做文本分类
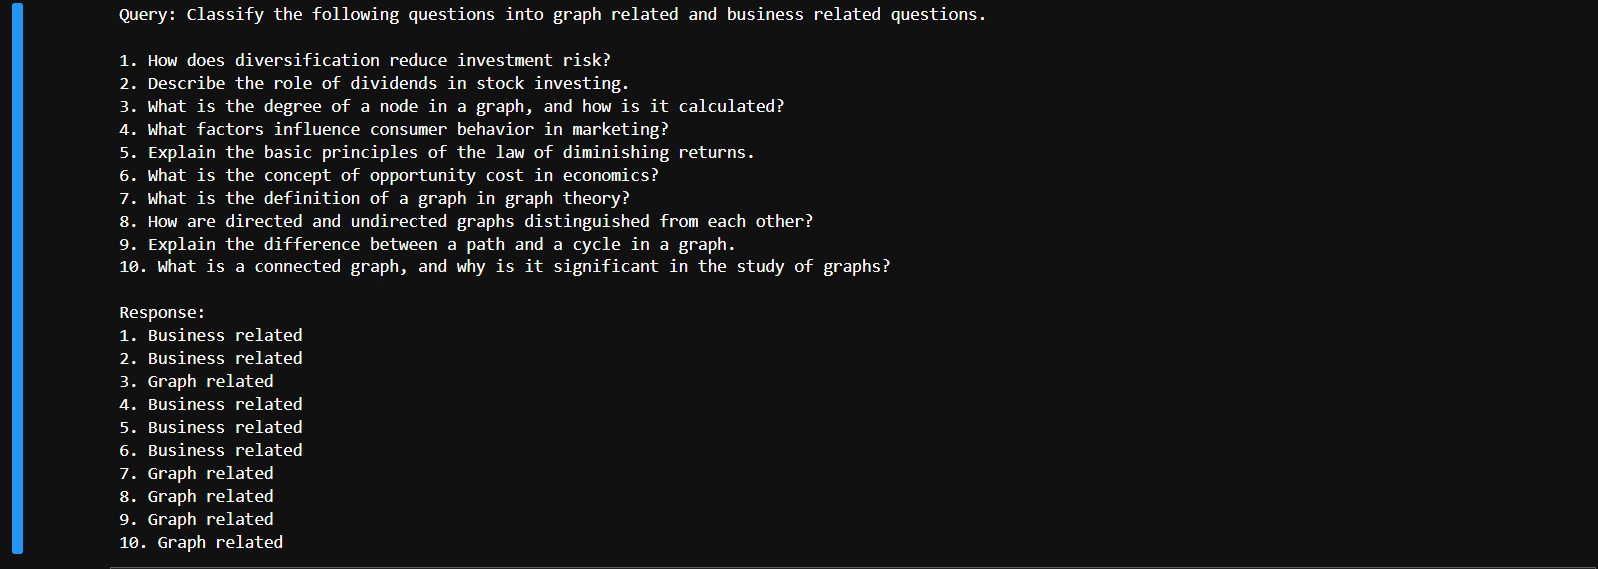
模型可以基于语义对文本分类。在下面的例子中,模型可以判断一个问题与 graph 有关还是与业务有关。
query = '''Classify the following questions into graph related and business related questions.

    1. How does diversification reduce investment risk?
    2. Describe the role of dividends in stock investing.
    3. What is the degree of a node in a graph, and how is it calculated?
    4. What factors influence consumer behavior in marketing?
    5. Explain the basic principles of the law of diminishing returns.
    6. What is the concept of opportunity cost in economics?
    7. What is the definition of a graph in graph theory?
    8. How are directed and undirected graphs distinguished from each other?
    9. Explain the difference between a path and a cycle in a graph.
    10. What is a connected graph, and why is it significant in the study of graphs?'''
response = ask_llm(query=query, k=4)
response
使用 RAG 调整语气
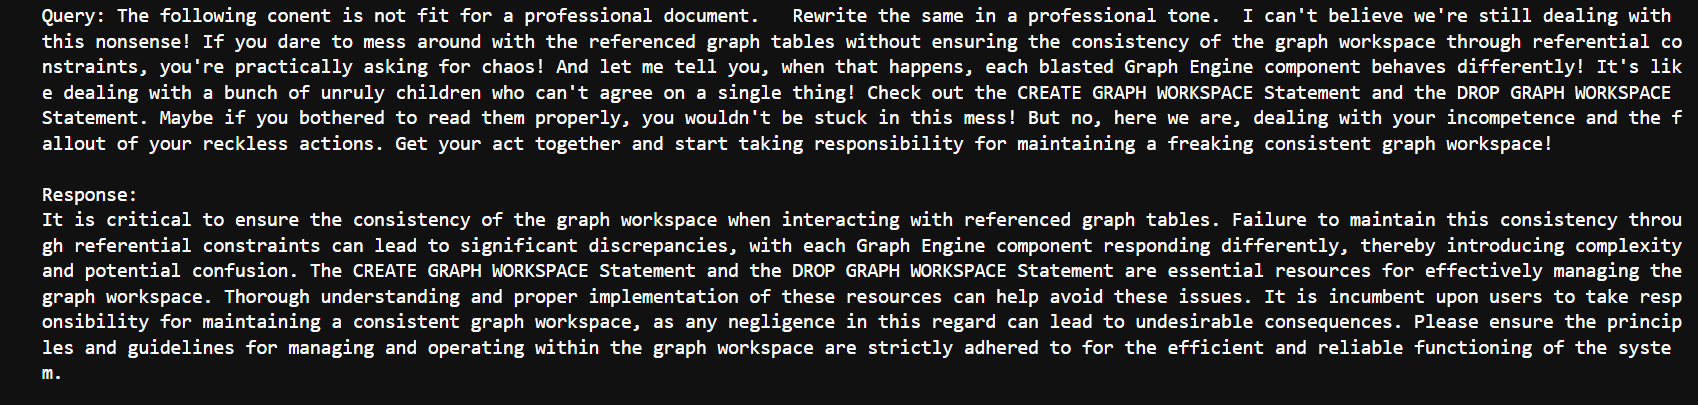
模型可以根据给出的指示调整内容的语气。下面的例子中,我们给出一段语气愤怒的文章片段,让 LLM 把它改写成专业的表达。
query = '''
    The following conent is not fit for a professional document. Rewrite the same in a professional tone.

    I can't believe we're still dealing with this nonsense! If you dare to mess around with the referenced graph tables without ensuring the consistency of the graph workspace through referential constraints, you're practically asking for chaos! And let me tell you, when that happens, each blasted Graph Engine component behaves differently! It's like dealing with a bunch of unruly children who can't agree on a single thing!

    Check out the CREATE GRAPH WORKSPACE Statement and the DROP GRAPH WORKSPACE Statement. Maybe if you bothered to read them properly, you wouldn't be stuck in this mess! But no, here we are, dealing with your incompetence and the fallout of your reckless actions. Get your act together and start taking responsibility for maintaining a freaking consistent graph workspace!'''
response = ask_llm(query=query, k=4)
response
使用 RAG 做拼写/语法检查
模型还可以发现文档中的拼写与语法问题并及时纠正
query = '''
    Proofread and rewrite the following sentence:
    The GraphScript langaguae  will eases the developomont of application-specific graph algthrihms and integrates them into SQL-based data procezzing.
        '''
response = ask_llm(query=query, k=4)
response

使用 Reddit 数据做检索增强生成
工作流 2
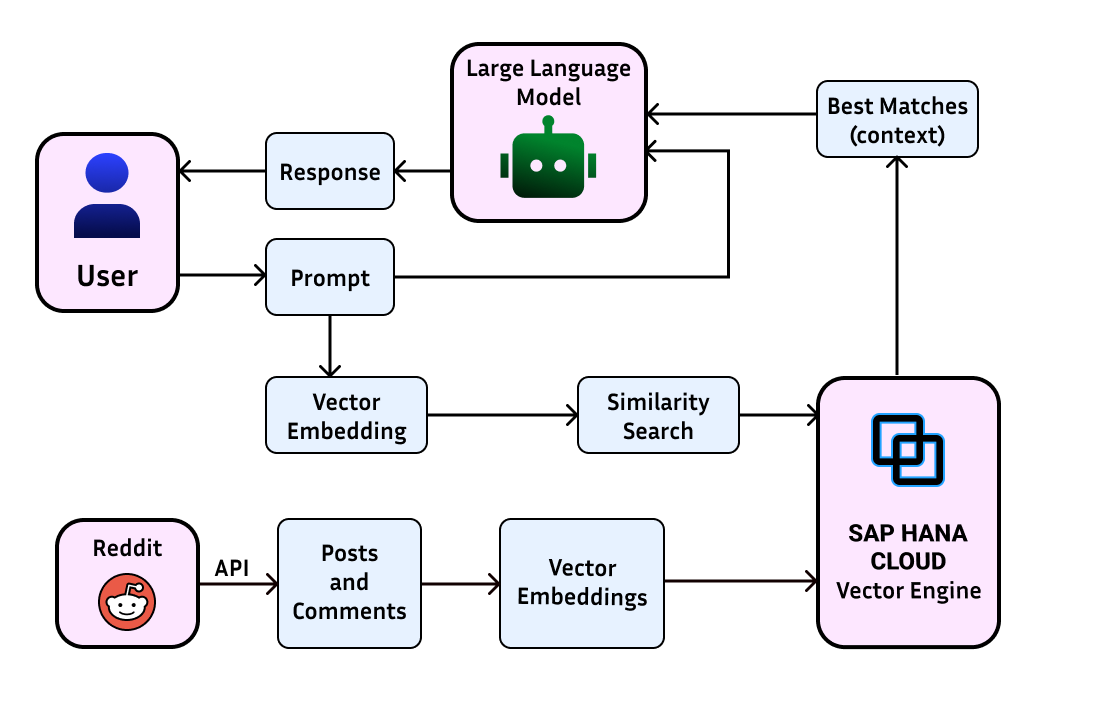
作为 XYZ 公司的内容开发者,Bob 用 embedding 改善开发者支持的进程遇到了新挑战:他的同事 Alice 在 Reddit 上发现了关键信息。下面是它如何融入用户故事:
发现关键信息:
Alice 注意到一篇 Reddit 帖子,指出 node 库中某个已废弃函数的问题。她意识到这可能影响开发者,于是深入排查并找到了一个绕过办法,随即以回复的形式分享在该帖子下。
支持请求增多:
第二天,Bob 的团队收到大量与 Reddit 上讨论的同一问题相关的询问。尽管 Alice 已在平台上及时回复,开发者仍然继续遇到问题,支持请求因此激增。
应对模型局限:
Bob 发现现有模型提供的支持与 Reddit 上的实时信息之间存在缺口。他意识到模型缺少 Reddit 讨论中的最新上下文,导致回答仍基于已废弃的函数而过时。
集成 Reddit 数据:
为弥合这个缺口,Bob 决定通过 Reddit API 把模型连接到 Reddit。
他从 XYZNODE subreddit 中获取相关数据,该社区包含与 node 库相关的讨论。
通过提取帖子标题、正文与评论,Bob 让模型获取到用户分享的最新见解与解决方案,包括 Alice 的绕过办法。
存储与处理 Reddit 数据:
Bob 把获取到的 Reddit 数据结构化,并以适合分析的格式保存。
他在公司的向量存储中新建一张表,从而高效地存储与检索 Reddit 数据及其 embedding,以便进一步处理。
在模型查询中使用 Reddit 上下文:
Bob 修改已有的 run_vector_search() 与 ask_llm() 函数,把 Reddit 数据与评论中的上下文纳入进来。
他确保模型在回答开发者查询时会考虑 Reddit 讨论中的最新上下文。
测试与验证:
Bob 做充分测试,验证 Reddit 数据已集成到模型中。
他确认模型回答现在能反映 Reddit 上讨论的最新信息与解决方案,包括 Alice 针对已废弃函数给出的绕过办法。
你可以通过 Reddit 的 api 连接,用其数据做检索增强生成。本示例中,我使用名为 'python' 的 subreddit 中的数据,围绕 python 编程语言做检索增强生成。
用你的凭据连接 reddit api。
CLIENT_ID = "<your-client-id>"
SECRET_KEY = "<your-secret-key>"
import requests
auth = requests.auth.HTTPBasicAuth(CLIENT_ID,SECRET_KEY)
data = {
    'grant_type':'password',
    'username':'<your-reddit-username>',
    'password':'<your-reddit-password>'
}
headers = {'User-Agent':'MyAPI/0.0.1'}
res = requests.post('https://www.reddit.com/api/v1/access_token',auth=auth,data=data,headers=headers)
TOKEN = res.json()['access_token']
headers['Authorization'] = f'bearer {TOKEN}'
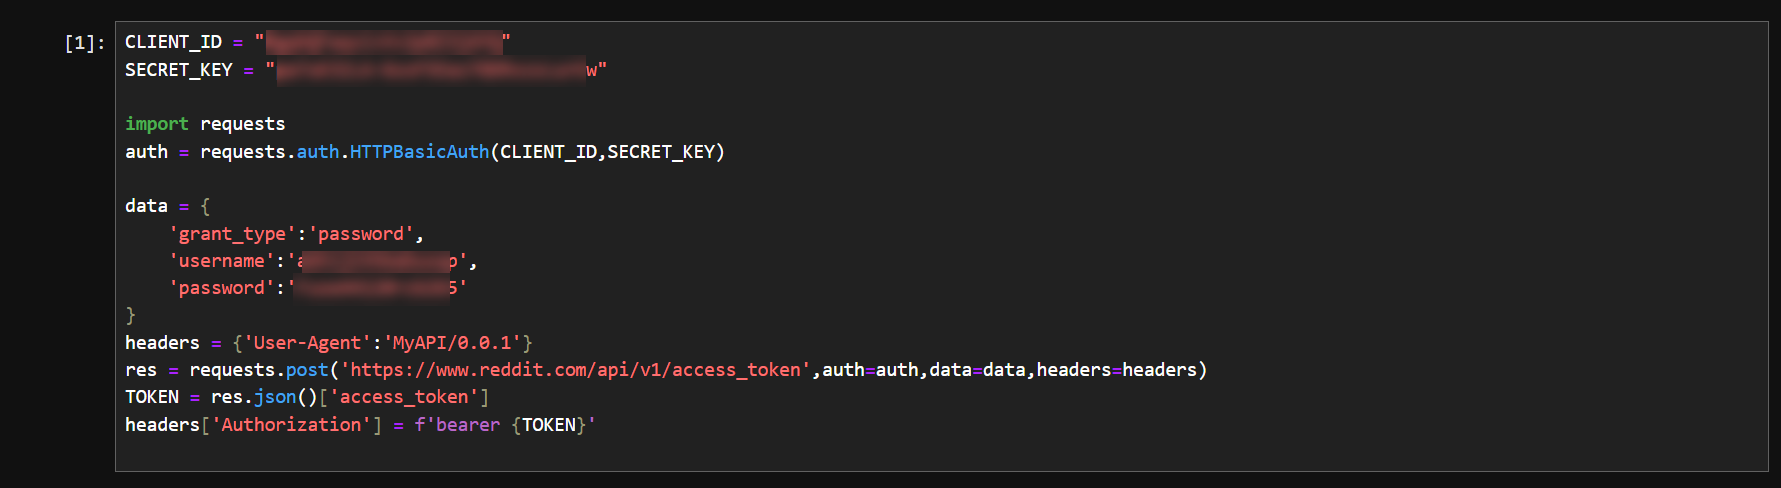
这里我们用凭据为 reddit API 生成了一个 token。该 token 会存放在 headers 中,随每次 API 调用一起传递。
现在可以访问 subreddit 'saphanagraph' 中的帖子了。连接到 saphanagraph subreddit,其中包含与 hana graph 相关的信息。
reddit_data = requests.get('https://oauth.reddit.com/r/saphanagraph',headers=headers).json()['data']['children']
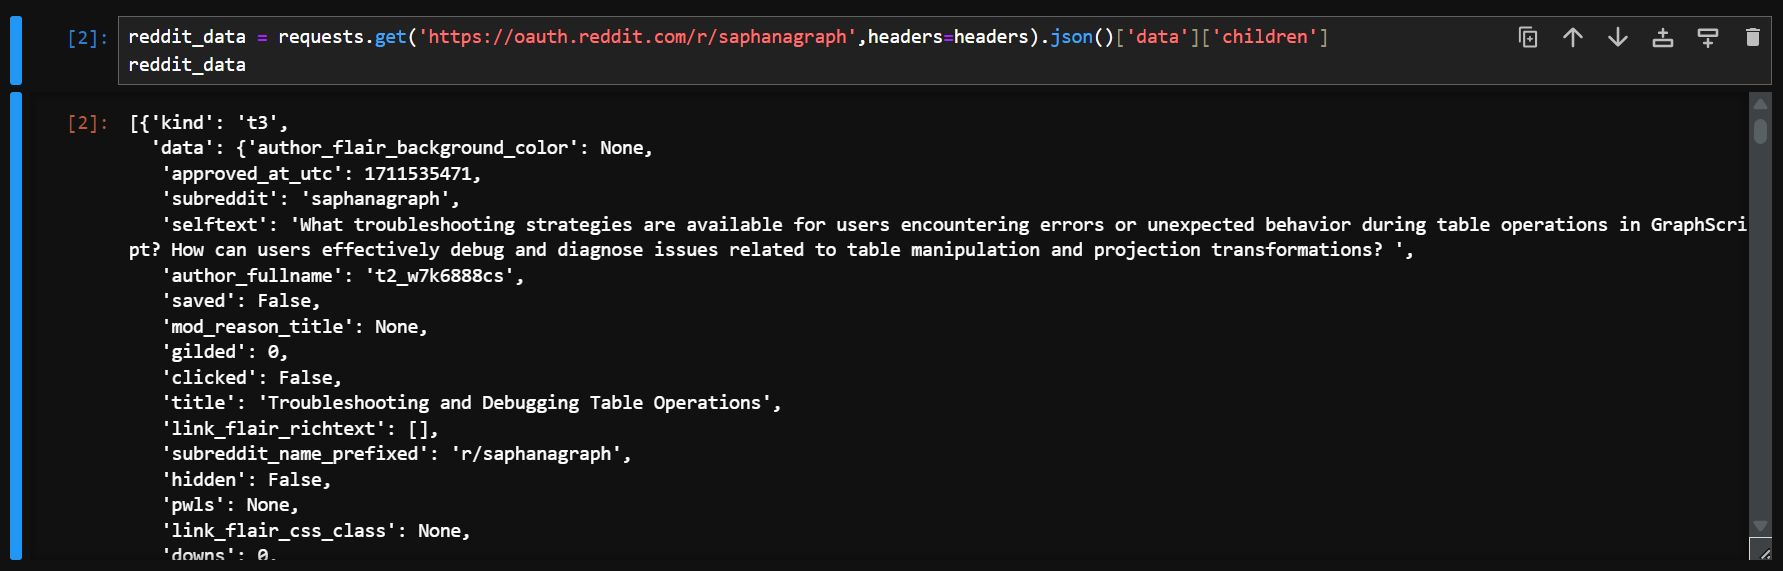
现在运行下面的代码片段,提取该 subreddit 中所有帖子的评论与回复。
ids = [data['data']['id'] for data in reddit_data]
comments = {}
for i in ids:
    comment_data = requests.get(f'https://oauth.reddit.com/r/saphanagraph/comments/{i}',headers=headers).json()
    comments[f"{i}"] = []
    def parse_comments(data):
        for j in data:
            comments[f"{i}"].append(j['data']['body'])
            if j['data']['replies'] != '':
                parse_comments(j['data']['replies']['data']['children'])
    if(len(comment_data[1]['data']['children'])):
        parse_comments(comment_data[1]['data']['children'])
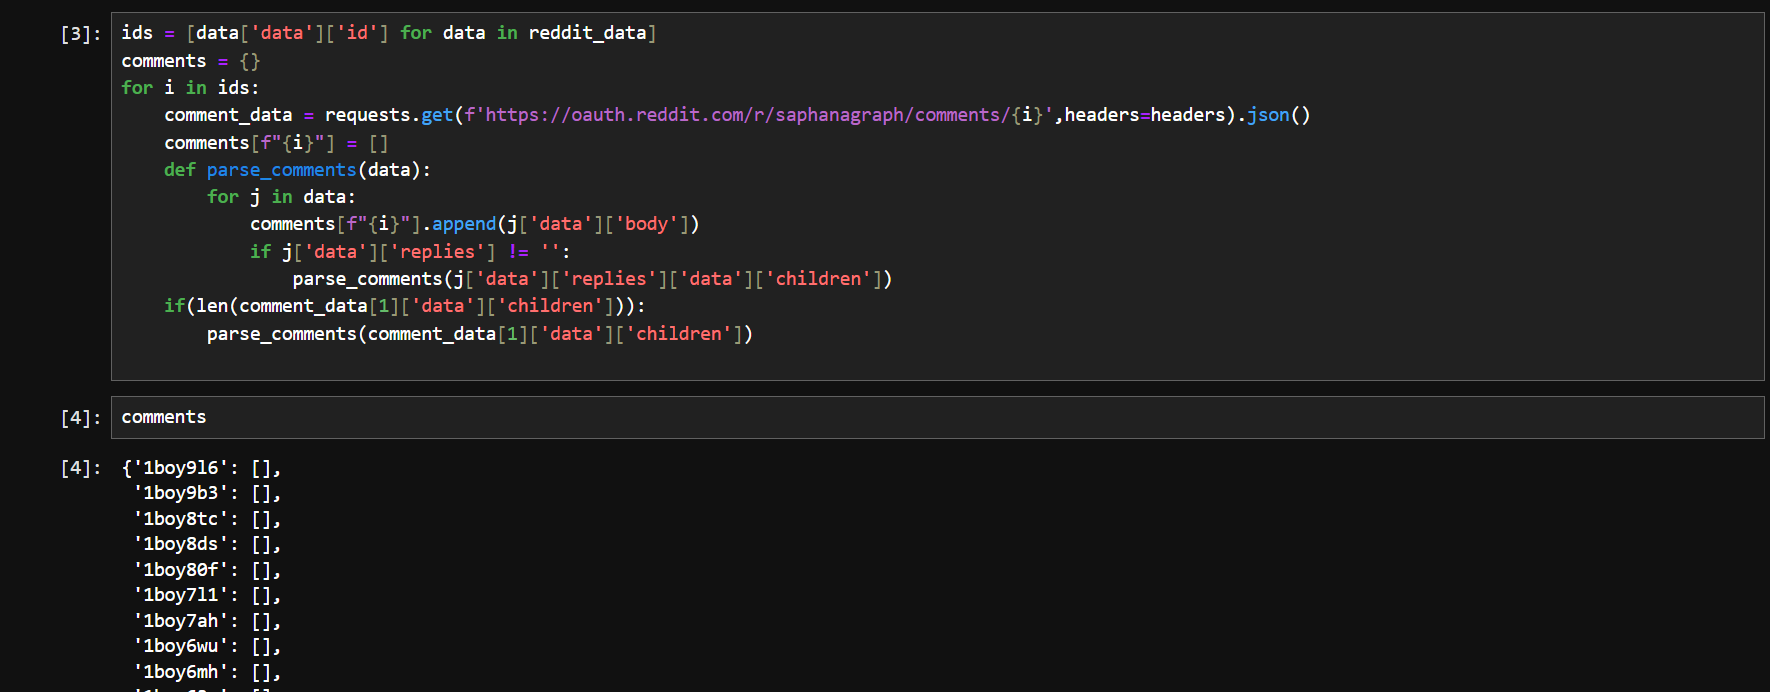
现在为评论生成向量 embedding。在把数据发给模型之前,我们会先对数据做匿名化处理,然后只把内容意图为正面的数据发送出去并保存为 embedding。
from gen_ai_hub.proxy.langchain.openai import ChatOpenAI

def user_intention(query) -> str:

    llm = ChatOpenAI(proxy_model_name='gpt-4')
    response =  llm.invoke("Classify the following query in one word as negative or positive : " + query).content
    if "negative" in response.lower():
        return False
    else:
        return True

from gen_ai_hub.proxy.native.openai import embeddings

def get_embedding(input, model="text-embedding-ada-002") -> str:
    response = embeddings.create(
      model_name=model,
      input=input
    )
    return response.data[0].embedding
在上面的代码中,我们定义了 user_intention() 函数,把 Reddit 数据分类为正面与负面数据。
对内容做匿名化,去掉含负面评价的内容,并据此创建 dataframe。
import pandas as pd
from presidio_anonymizer.entities import OperatorConfig
from presidio_analyzer import AnalyzerEngine, BatchAnalyzerEngine, RecognizerResult, DictAnalyzerResult

analyzer = AnalyzerEngine(log_decision_process=False)
batch_analyzer = BatchAnalyzerEngine(analyzer_engine=analyzer)

extracted_data = []
for post in enumerate(reddit_data):
    post_content = post[1]['data']['selftext']
    post_content = reddit_data[0]['data']['selftext']
    anonymizer_results = analyzer.analyze(text=post_content, entities=["PERSON", "EMAIL_ADDRESS", "IP_ADDRESS"], language="en", return_decision_process=True)
    for i in anonymizer_results:
        post_content = post_content.replace(i.entity_value, i.anonymized_value)
    if user_intention(post_content):
        row = [post[0]+1]
        row.append(post[1]['data']['title'])
        row.append(post_content)
        row.append(str(comments[post[1]['data']['id']]))
        row.append(str(get_embedding(row[1])))
        extracted_data.append(row)
# df = pd.DataFrame(extracted_data)
# df.columns = ["ID", "Title", "Post", "Comments", "Post-Vector"]
运行上面的代码后,你可能需要重启 notebook。重启后,需要从连接 reddit API 开始重新执行。
在上面的代码中,我们从 reddit 提取数据并保存到 dataframe 中。我们用 batch_analyzer 与 batch_anonymizer 去掉了 reddit 数据中的敏感信息。
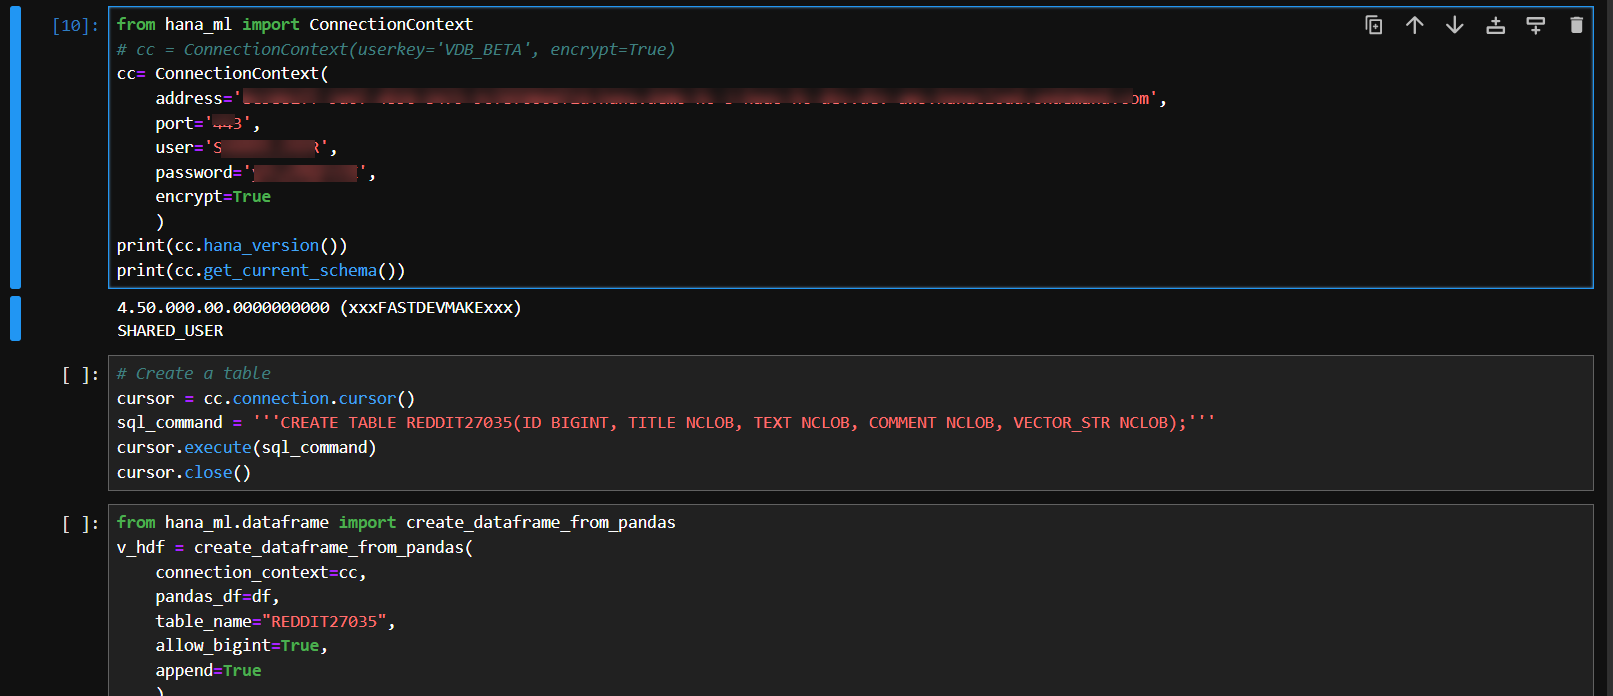
把数据上传到 HANA 向量存储,做法与上一节相同。
填写你的凭据以创建 connectionContext
把 TABLENAME 替换为你要新建的表名。注意:表名只能使用大写字母和数字。
from hana_ml import ConnectionContext
from hana_ml.dataframe import create_dataframe_from_pandas

cc= ConnectionContext(
    address='<address>',
    port='<port-number>',
    user='<user-name>',
    password='<password>',
    encrypt=True
    )

cursor = cc.connection.cursor()
sql_command = '''CREATE TABLE TABLENAME(ID BIGINT, TITLE NCLOB, TEXT NCLOB, COMMENT NCLOB, VECTOR_STR REAL_VECTOR);'''
cursor.execute(sql_command)
cursor.close()

cursor = cc.connection.cursor()
sql_insert = 'INSERT INTO TABLENAME(ID, TITLE, TEXT, COMMENT, VECTOR_STR) VALUES (?,?,?,?,TO_REAL_VECTOR(?))'
cursor.executemany(sql_insert,extracted_data)
借助 COSINE-SIMILARITY 之类的技术,可以用 embedding 找出彼此相似的文本。你可以用这类技术从 HANA 向量存储中找出与你的 prompt 相似的文本数据。
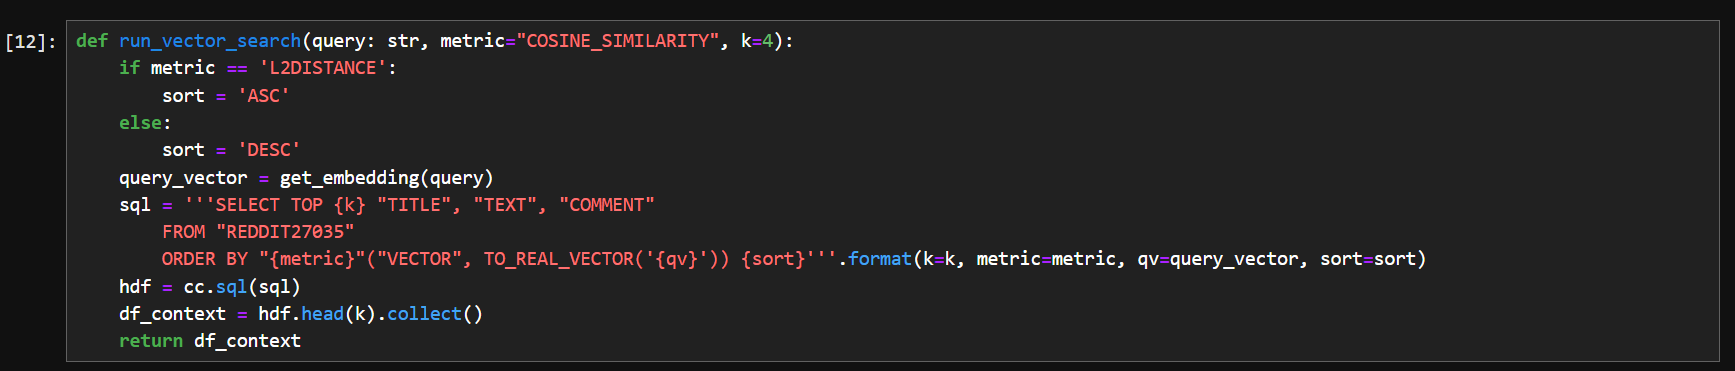
现在定义一个函数,在数据中做相似度检索。该函数接收查询作为输入,从表中返回相似的内容。
把 TABLENAME 替换为你的表名。
def run_vector_search(query: str, metric="COSINE_SIMILARITY", k=4):
    if metric == 'L2DISTANCE':
        sort = 'ASC'
    else:
        sort = 'DESC'
    query_vector = get_embedding(query)
    sql = '''SELECT TOP {k} "TITLE", "TEXT", "COMMENT"
        FROM "TABLENAME"
        ORDER BY "{metric}"("VECTOR_STR", TO_REAL_VECTOR('{qv}')) {sort}'''.format(k=k, metric=metric, qv=query_vector, sort=sort)
    hdf = cc.sql(sql)
    df_context = hdf.head(k).collect()
    return df_context
我们可以定义一个 prompt 模板,为 prompt 提供上下文。这样当我们把 prompt 传给模型时,模板会为 prompt 补充必要的上下文,从而生成更好的结果。
promptTemplate_fstring = """
You are an Python expert.
You are provided multiple context items that are related to the prompt you have to answer.
Use the following pieces of context to answer the question at the end.
Context:
{context}
Question:
{query}"""
from langchain.prompts import PromptTemplate
promptTemplate = PromptTemplate.from_template(promptTemplate_fstring)
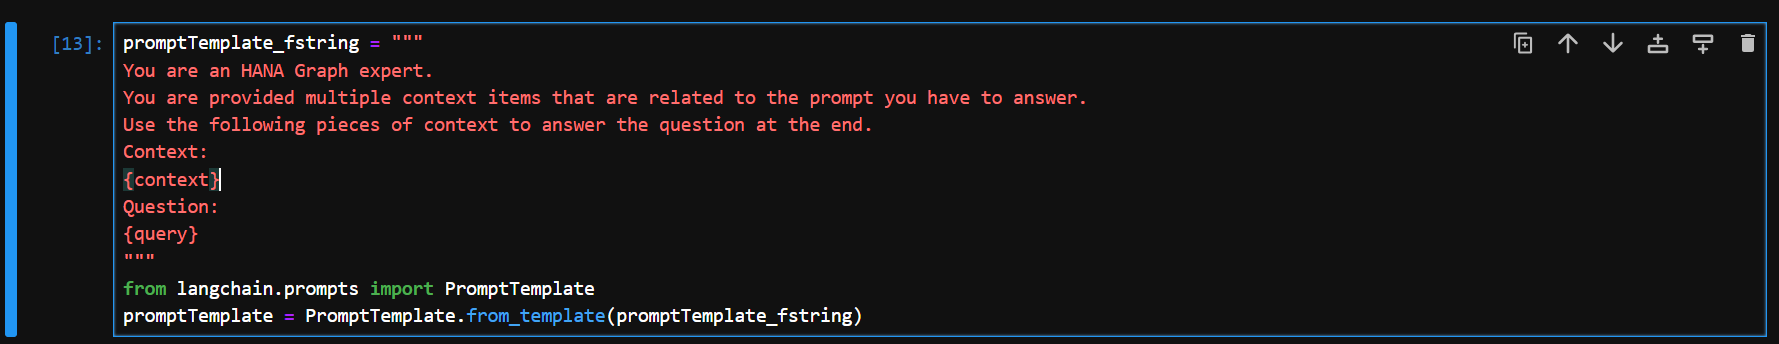
这里我们为 prompt 创建了一个模板。它包含两个变量 'context' 与 'query',这两个变量会在后续步骤中被替换成上下文与查询内容
现在可以定义一个 ask_llm() 函数,用上面的模板查询模型。
def ask_llm(query: str, metric='COSINE_SIMILARITY', k = 4) -> str:
    context = ''
    context = run_vector_search(query, metric, k)
    prompt = promptTemplate.format(query=query, context=' '.join(context['TEXT'].astype('string')+context['COMMENT'].astype('string')))
    llm = ChatOpenAI(proxy_model_name='gpt-4')
    response = llm.invoke(prompt).content
    print('Query: '+ query)
    print('\nResponse:')
    print(response)
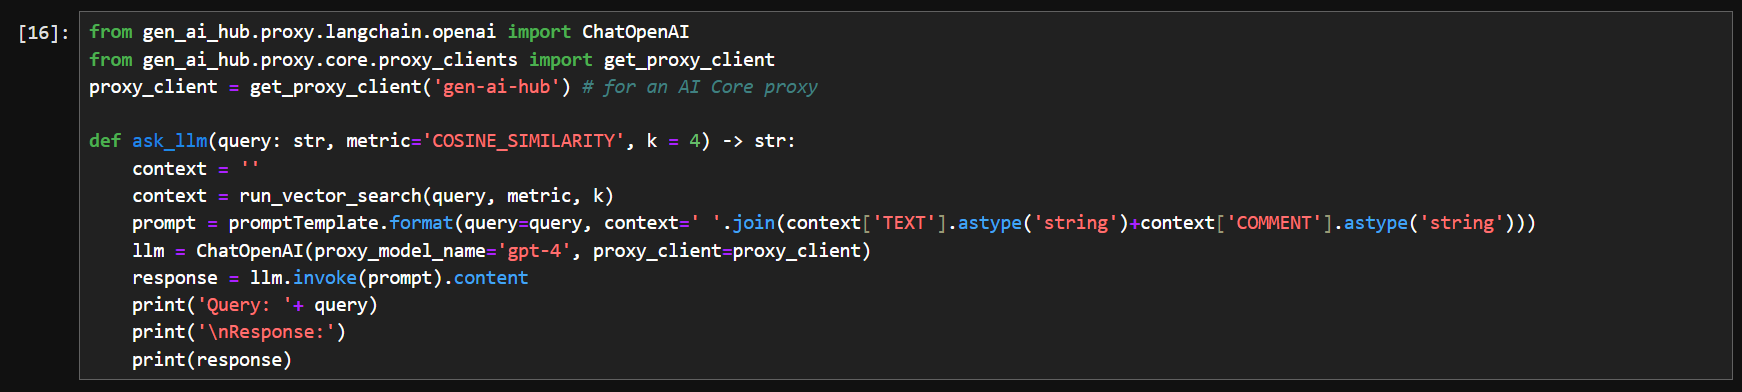
上面的函数把 query 与 context 填入模板生成 prompt,再把该 prompt 传给 LLM 模型并打印回答。
这里我们使用的是 gpt-4 模型。请确保你已经在 AI Launchpad 中为 gpt-4 模型创建了 deployment
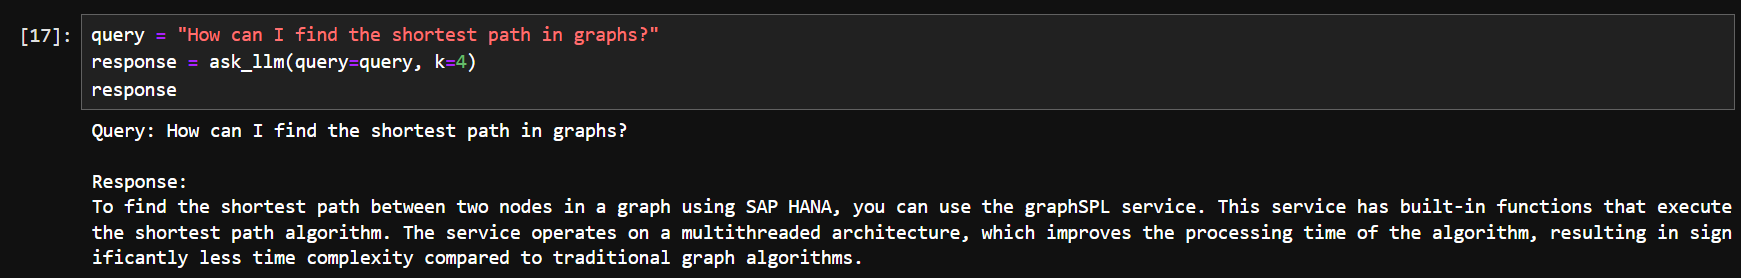
现在把下面的查询传给函数,测试用检索增强生成给出的结果。
query = "How can I find the shortest path in graphs?"
response = ask_llm(query=query, k=4)
response
与不用 RAG 时同一查询的输出相比,我们得到了更详细的输出。
可以看到,生成的输出基于我们在 Reddit 中发布的评论。
在模型上尝试信息抽取
query = "How can I search for a word in a dictionary?"
response = ask_llm(query=query, k=4)
response

结果: 通过集成 Reddit 实时数据,Bob 让模型能向开发者提供最新且相关的支持。借助社区分享的实时见解与解决方案,由 embedding 驱动的帮助门户变得更有价值,能以更高的准确度和效率回答开发者的问题。
代码生成
我们可以借助 LLM 用 python 及其他编程语言生成代码。下面的例子让模型写一段代码,在字典中查找某个单词。
llm = ChatOpenAI(proxy_model_name='gpt-4')
response = llm.invoke("write the python code to search for a word in a dictionary?").content
print(response)
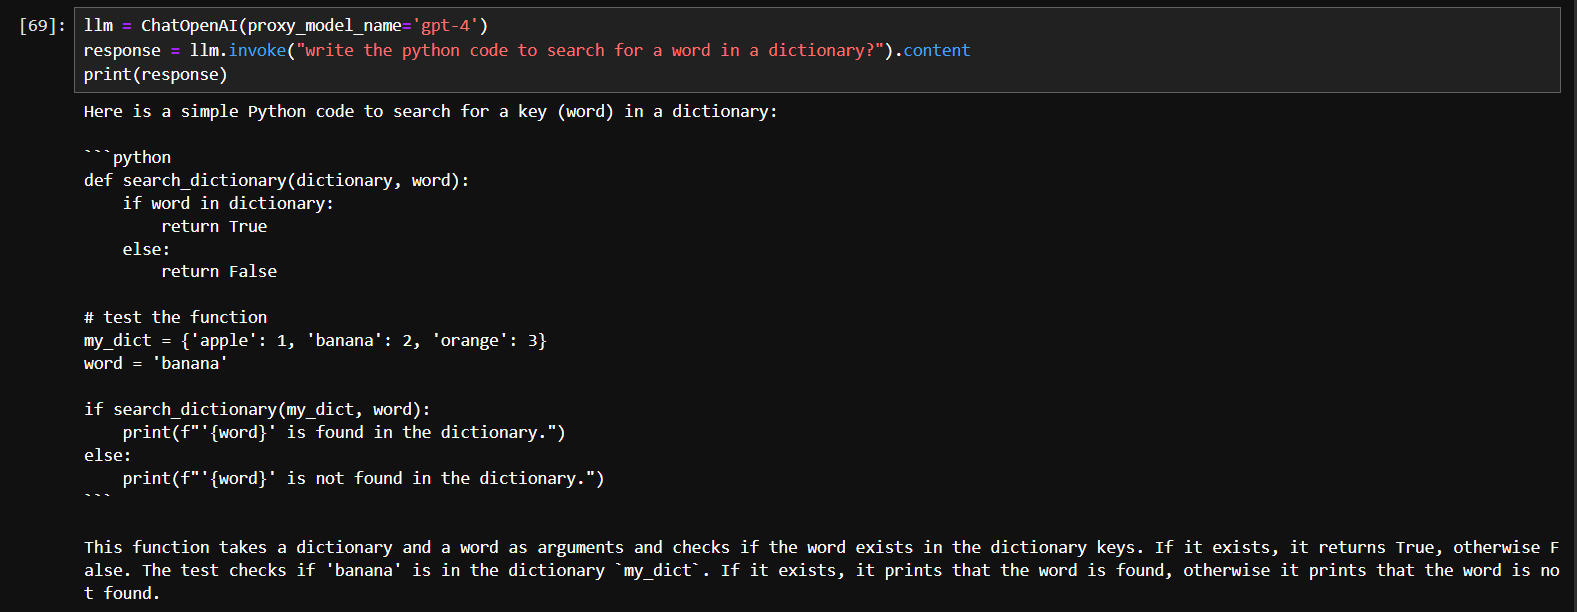
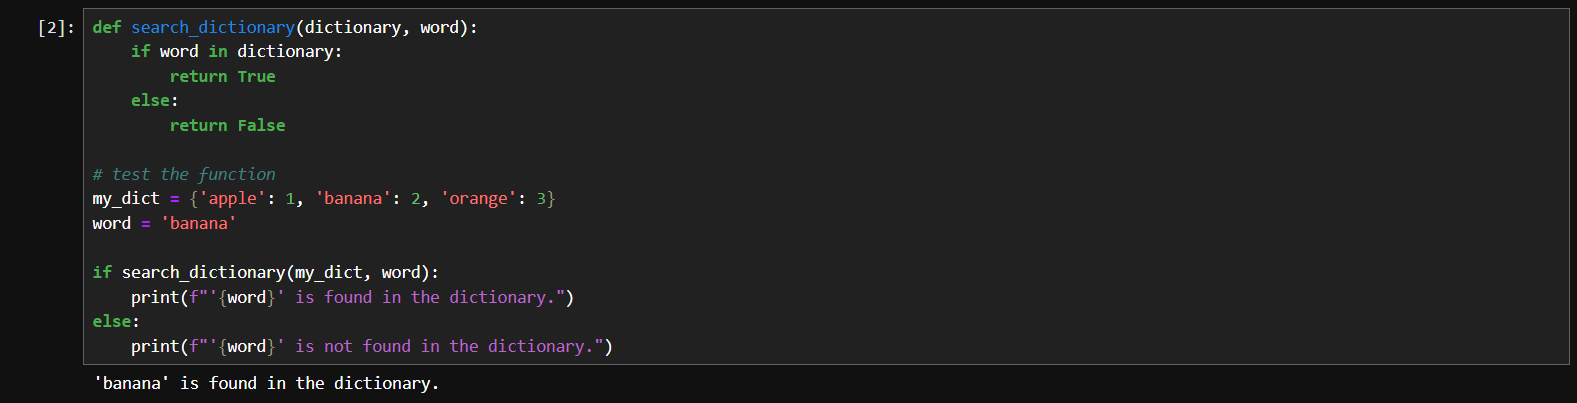
我们可以把生成的代码粘贴到新的 cell 中运行,查看它的输出
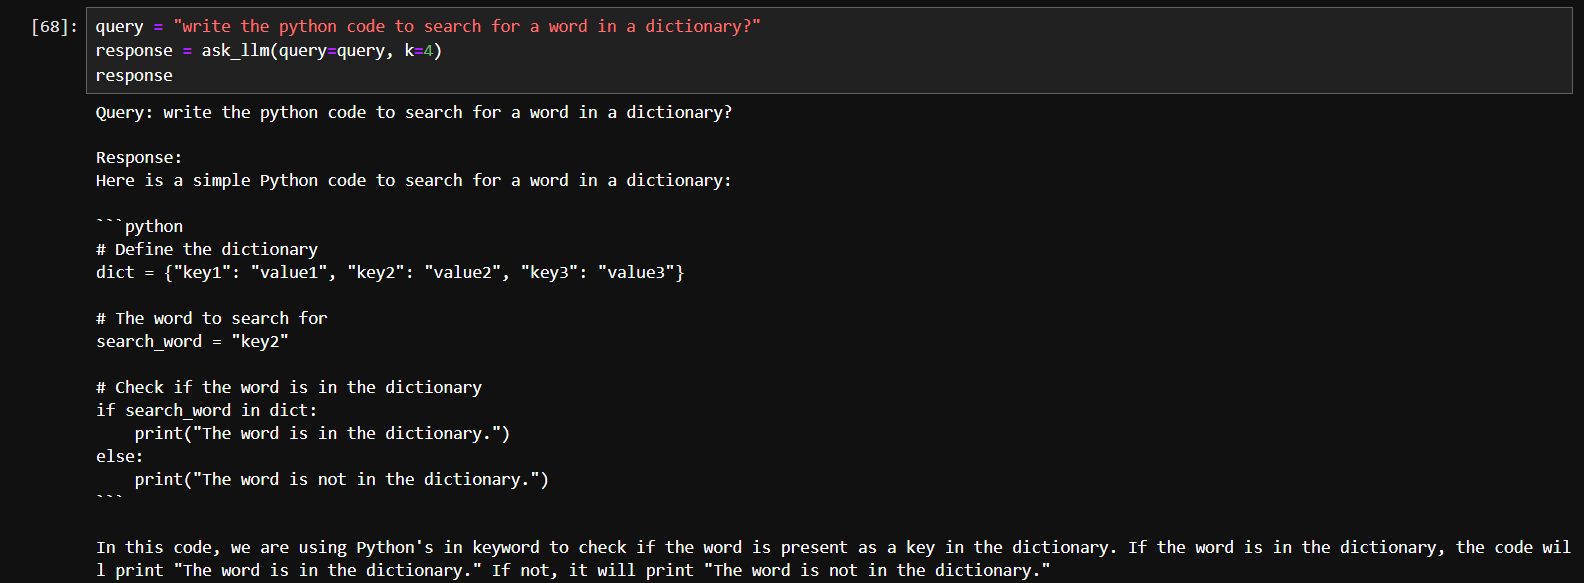
现在我们用 RAG 生成代码。下面的例子使用同一个 prompt,借助 RAG 生成代码。
query = "write the python code to search for a word in a dictionary?"
response = ask_llm(query=query, k=4)
response
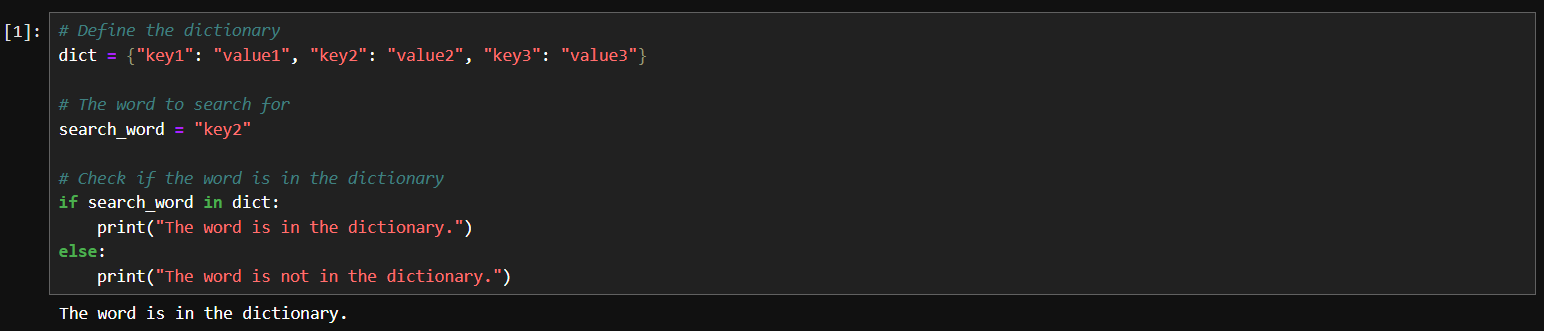
我们可以把生成的代码粘贴到新的 cell 中运行,查看它的输出
我们可以借助 LLM 找出两次生成的代码之间的差异。把代码粘贴到下面的 prompt 中并运行该 cell。
query = '''
Find the difference between the following two pieces of python code and explain what each code does.

code-1:

<code 1 here>

code-2:
<code 2 here>
'''

llm = ChatOpenAI(proxy_model_name='gpt-4')
response = llm.invoke(query).content
print(response)
在这里可以看到两段代码的差异。
结果:生成代码后,Bob 测试代码并推送到 github,用于测试与质量保证。借助 LLM,写代码的工作量大幅减少。
搭建 SAP AI Launchpad 与 SAP AI Core
SAP AI Launchpad 是 SAP BTP 上的多租户 SaaS 应用。你可以用 SAP AI Launchpad 管理跨不同 AI 运行时的 AI 用例。SAP AI Launchpad 还通过 SAP AI Core 中的 Generative AI Hub 提供生成式 AI 能力,并在 Cloud Foundry 环境中可用。你也可以把 SAP HANA 数据库作为 AI 运行时接入,以使用 HANA 预测分析库(PAL),或接入 SAP AI Services 以使用 SAP AI Service 中的 Data Attribute Recommendation。
[1/4] 打开 SAP Business Technology Platform
👉 打开你的 BTP cockpit。
👉 导航到子账户:GenAI CodeJam。
[2/4] 打开 SAP AI Launchpad 并连接 SAP AI Core
👉 进入 Instances and Subscriptions,查看是否存在 SAP AI Core 实例与 SAP AI Launchpad 订阅。
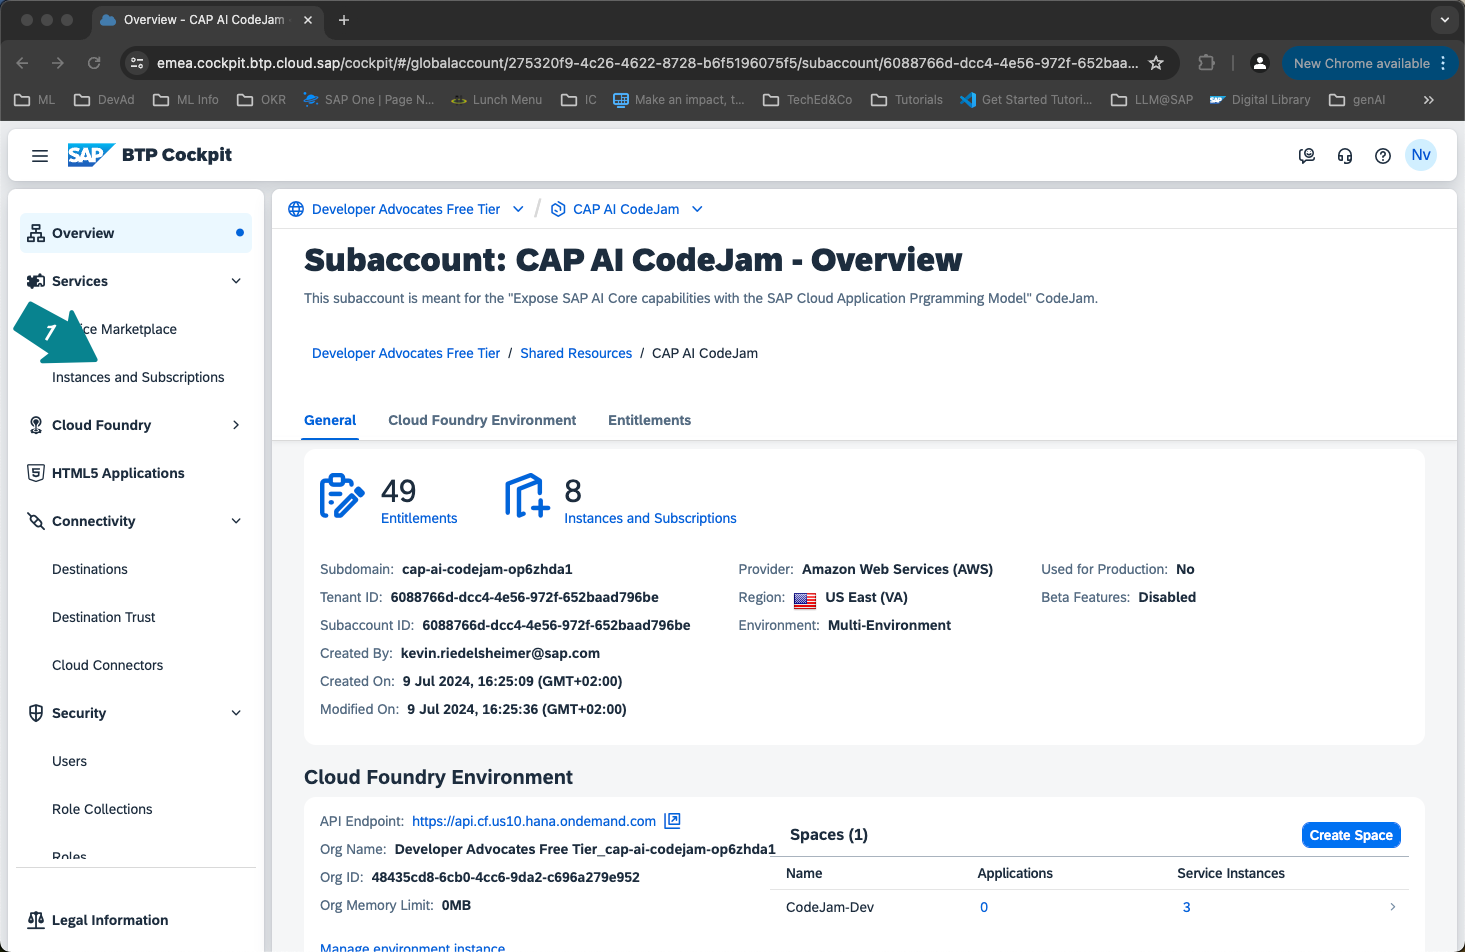
借助 SAP AI Launchpad,你可以管理全部机器学习操作。☝️ 请确保你使用 SAP AI Core 的扩展计划(extended plan),以便使用 Generative AI Hub。要把 SAP AI Core 连接到 SAP AI Launchpad,需要 SAP AI Core 服务密钥。
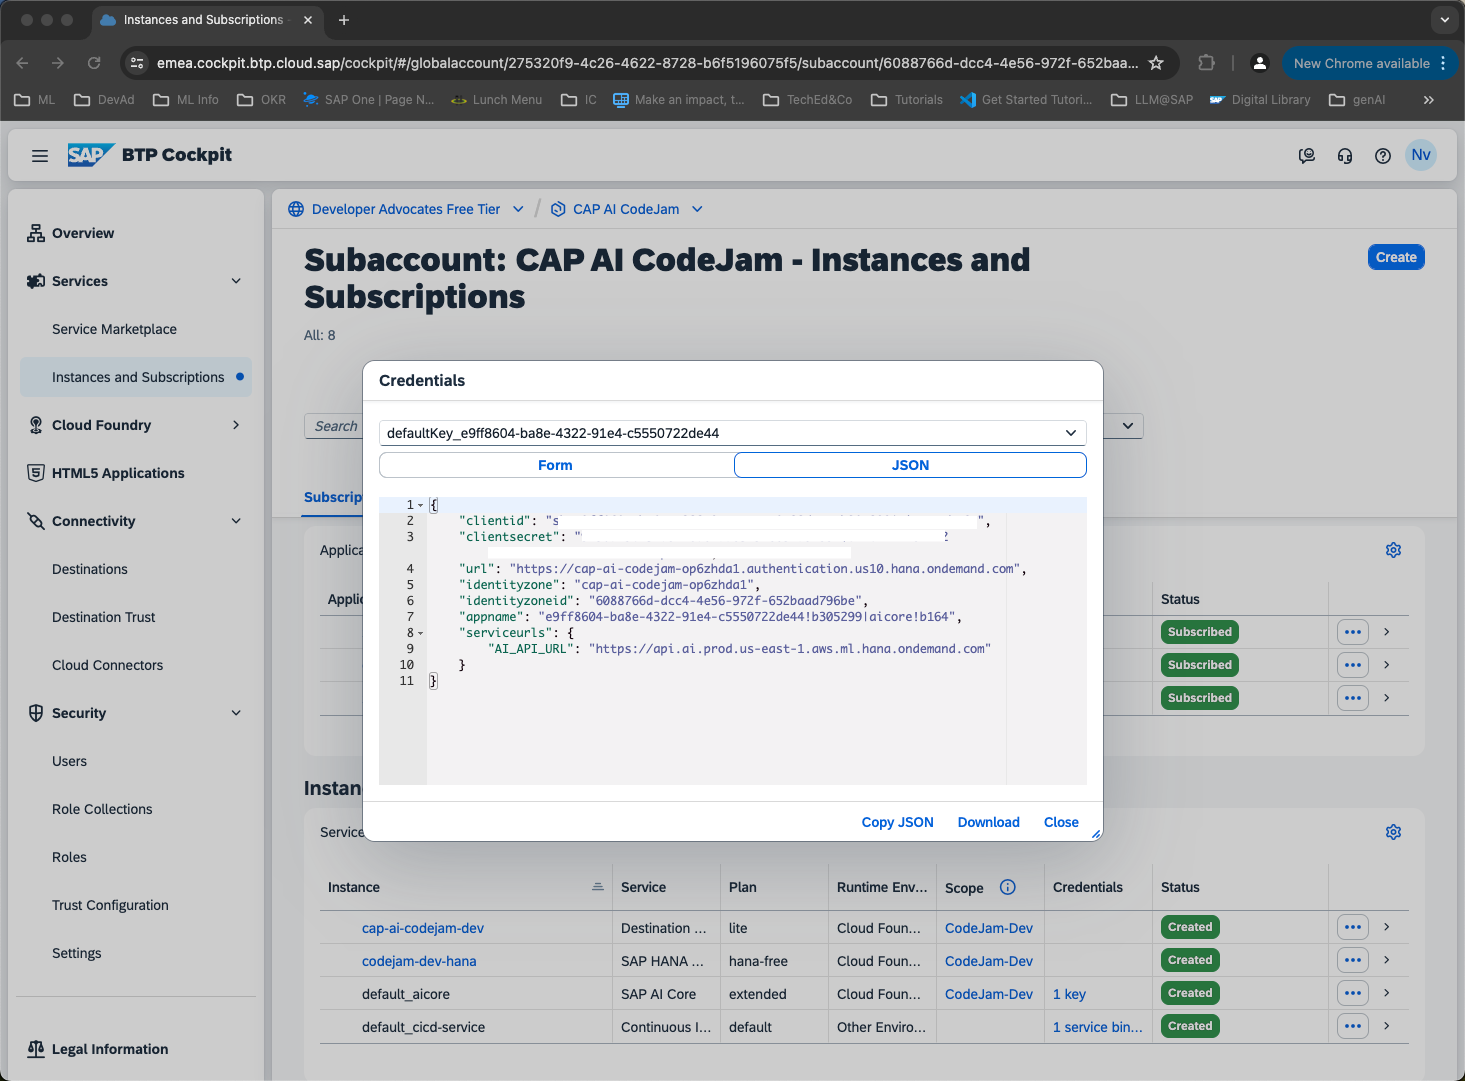
☝️ 在该子账户中,SAP AI Core 服务实例与 SAP AI Launchpad 应用之间的连接已经建立。否则你需要用 SAP AI Core 服务密钥信息新增一个运行时。
👉 打开 SAP AI Launchpad。
[3/4] 为你的团队创建新的 resource group
SAP AI Core 租户使用 resource group 来隔离 AI 资源与工作负载。场景(例如 foundation-models)
与可执行项(训练模型或创建部署时用的模板)在所有 resource group 之间共享。
请务必为你的团队创建一个新的 resource group。 不要使用默认的 resource group!
👉 打开 SAP AI Core Administration 标签页,选择 Resource Groups。
👉 Create 一个新的 resource group,名称用你团队的名字。
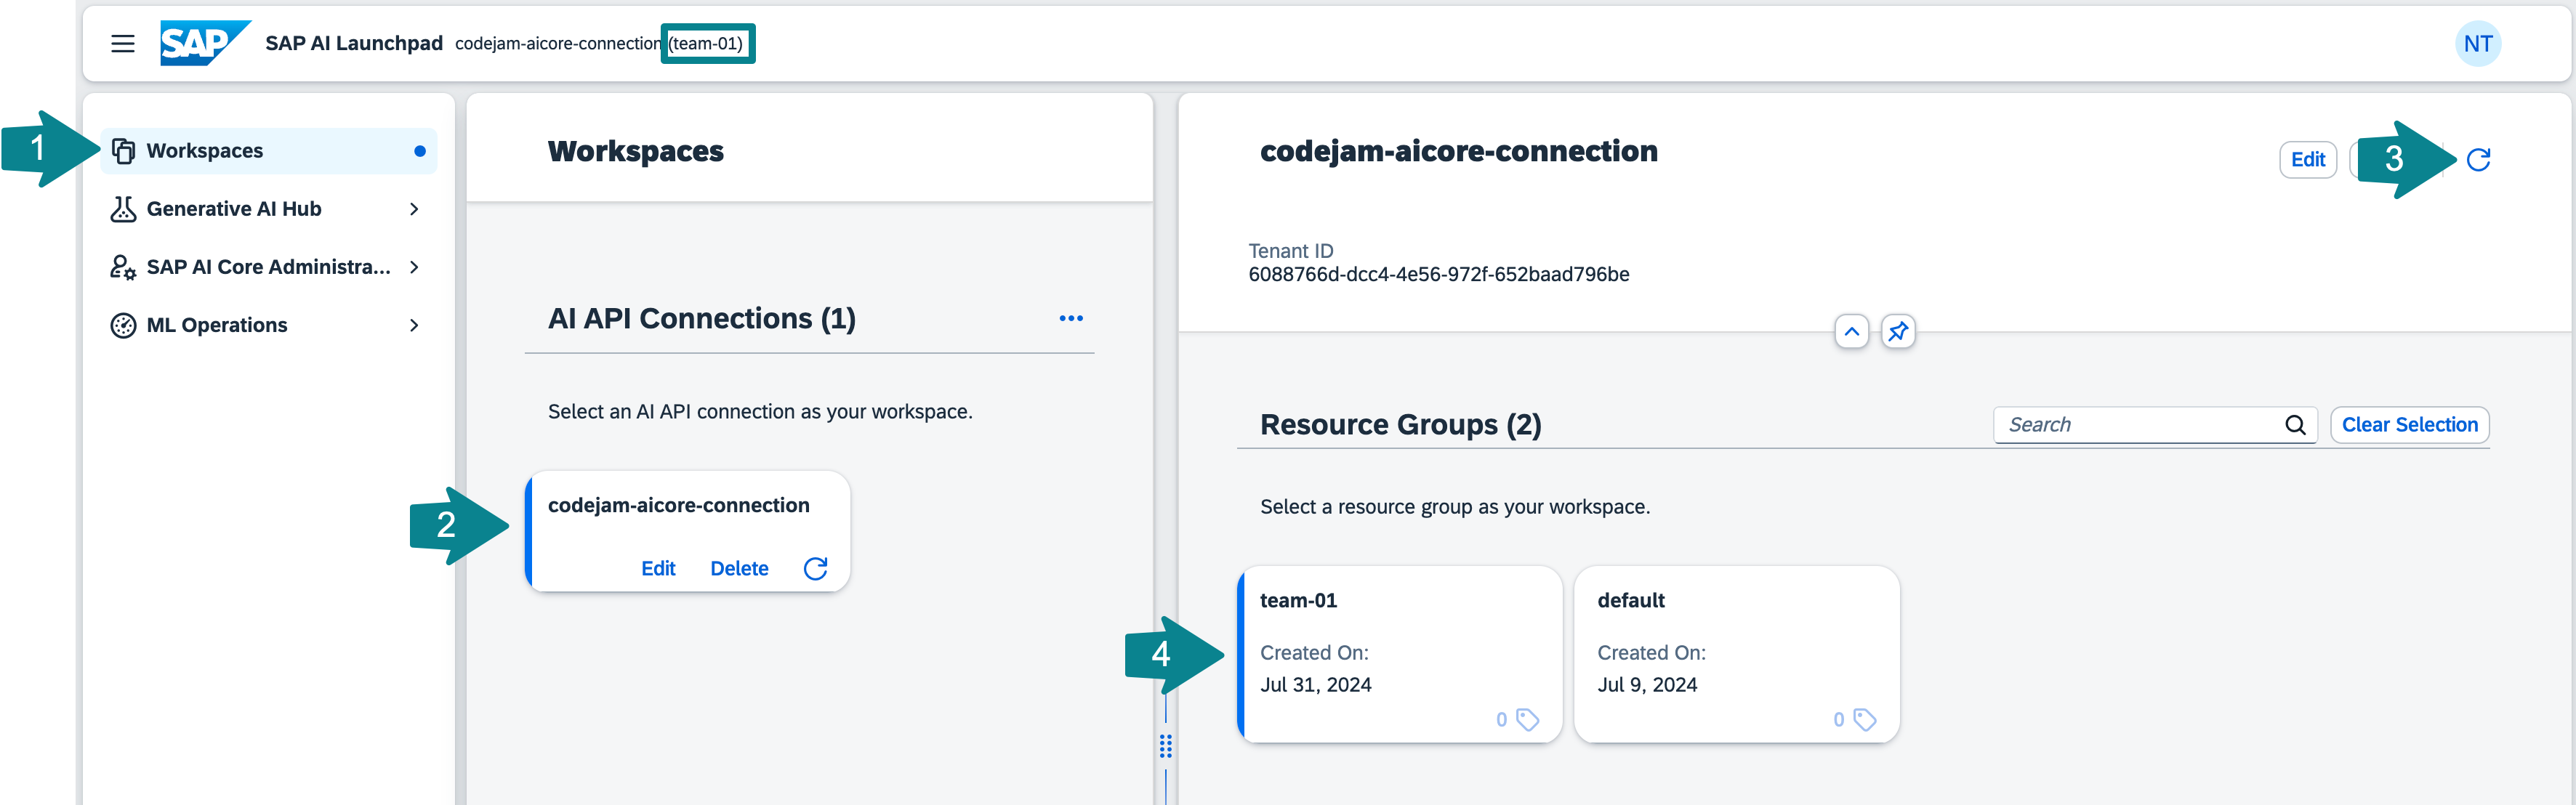
👉 返回 Workspaces。
👉 选择你的连接与 resource group。
👉 确认它已被选中。它应显示在页面顶部 SAP AI Launchpad 旁边。
☝️ 在 Exercise 04-create-embeddings 中你会用到 resource group 的名称。
如果 resource group 没有显示出来,请使用**浏览器(!)**的刷新按钮刷新页面。
下一个练习
在 SAP AI Launchpad 中探索 Generative AI Hub
要在应用中使用大语言模型(LLM)或 foundation model,可以使用 SAP AI Core 上的 Generative AI Hub。与大多数 LLM 应用一样,Generative AI Hub 按使用量计费。
Generative AI Hub 提供市场上的所有主流模型。其中既有 SAP 自行部署的开源模型(例如 Falcon 模型),也有 SAP 作为代理提供的模型,例如 GPT 系列模型、Google 模型、Amazon Bedrock 提供的模型等等。你可以在它们之间轻松切换、对比结果,并选出最适合你用例的模型。
SAP 与 LLM 提供方签订了严格的数据隐私协议,确保你的数据安全。
要开始使用 Generative AI Hub 中的某个可用模型,你需要先部署它。你可以部署一个 orchestration service,然后通过它访问所有可用模型;也可以通过 Model Library 直接部署单个模型。你可以用 Python SDK、SAP Cloud SDK for AI(JavaScript SDK)、任意编程语言或 API 平台,或者 SAP AI Launchpad 的用户界面访问已部署的模型。SAP AI Launchpad 提供 Model Library、Chat 界面与 Prompt Editor,在 Prompt Editor 中还可以保存 prompt 与模型回答。
通过 Model Library 部署 proxy
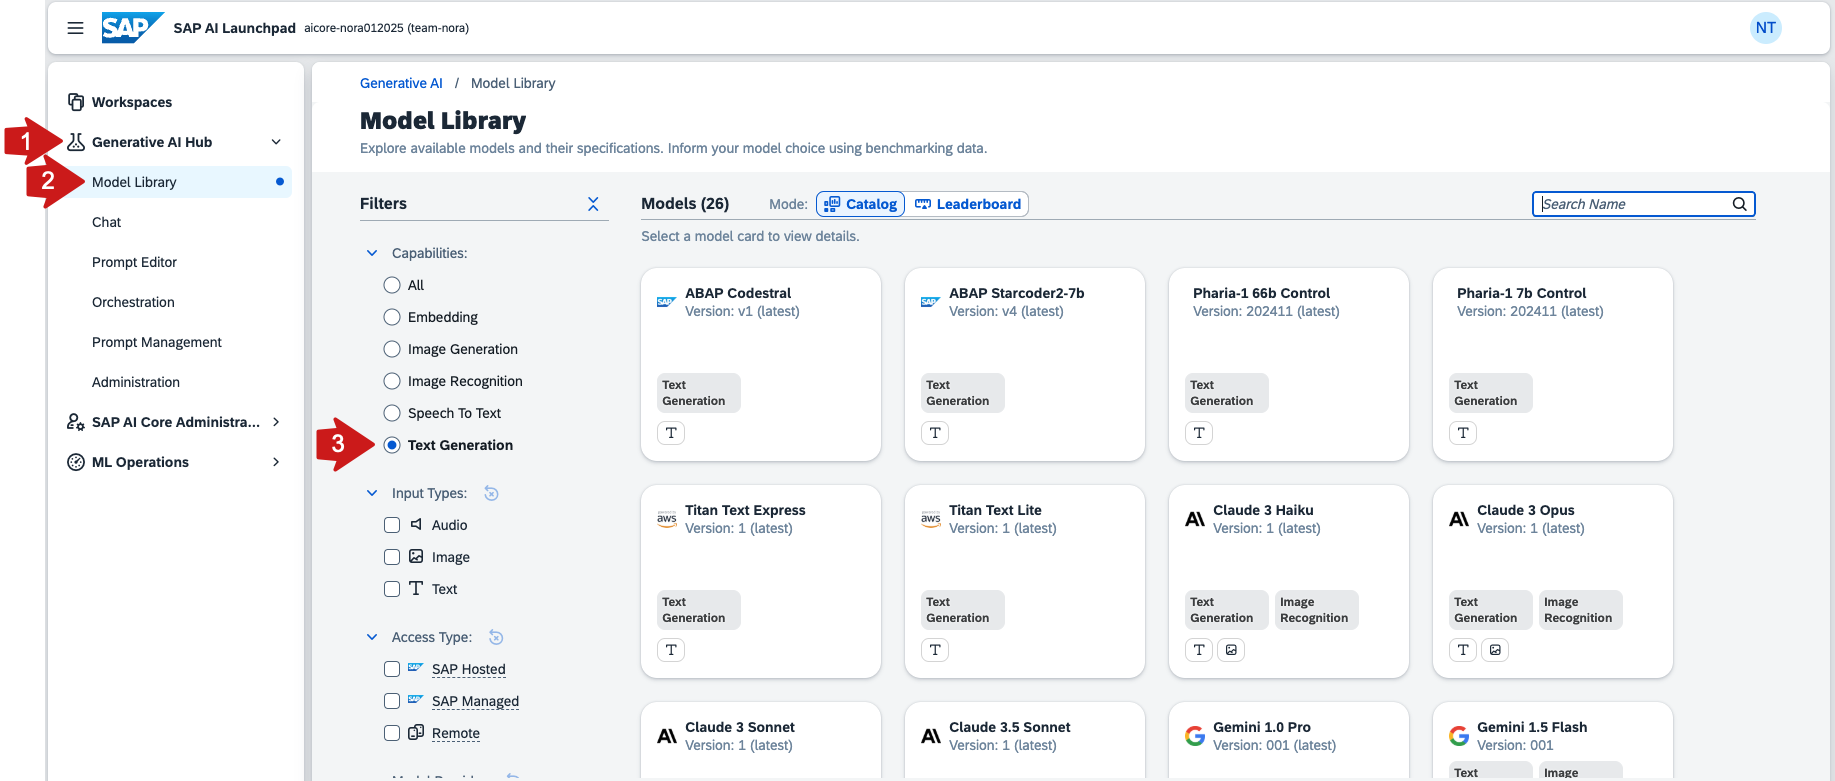
👉 打开 Generative AI Hub 标签页,选择 Model Library。
👉 点击 GPT-4o Mini,这是一个文本生成模型,也能处理图片。
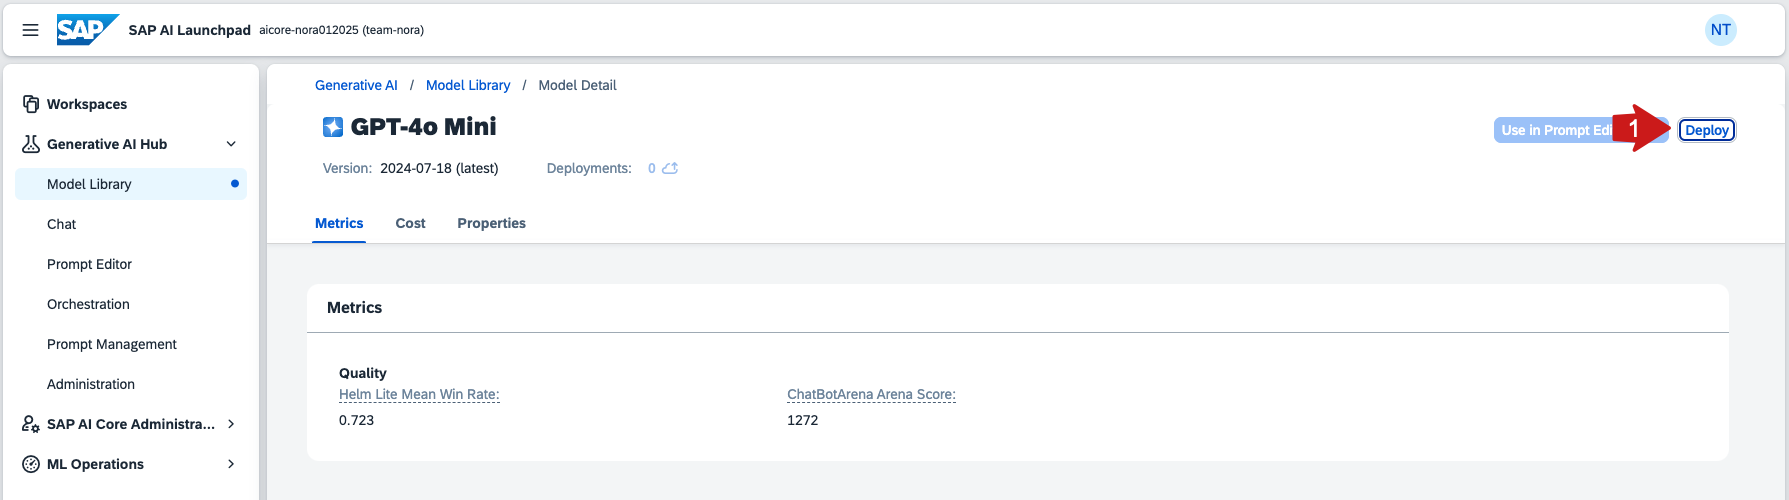
👉 点击 Deploy 一次,即可让模型端点对你可用。部署需要一分钟左右。
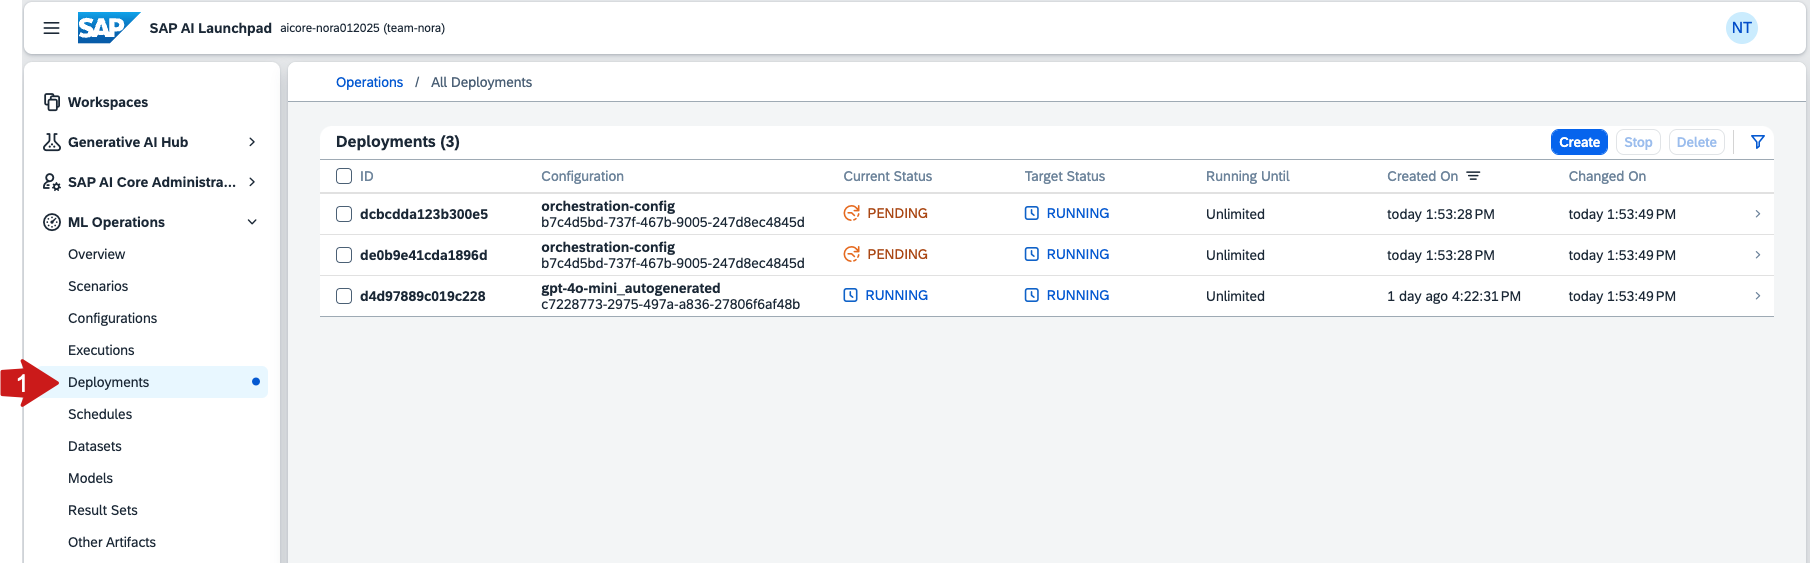
👉 你可以通过点击 ML Operations>Deployments 查看模型的部署状态。
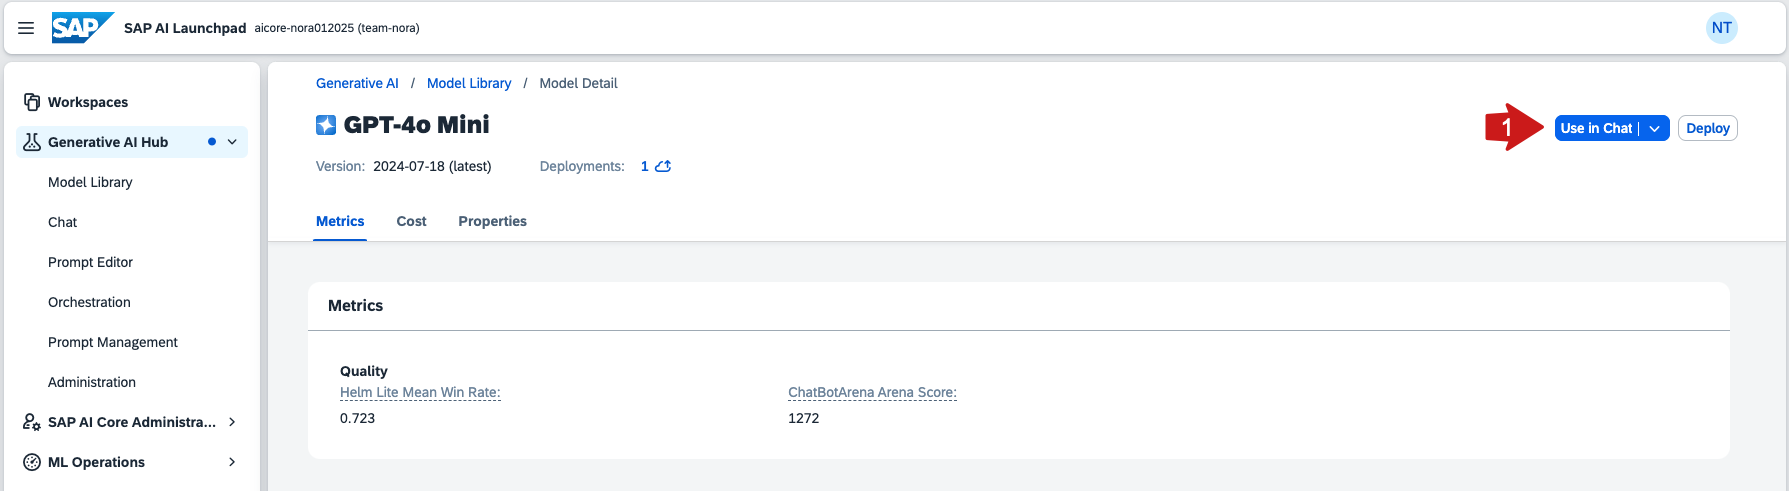
👉 点击 Use in Chat 打开聊天界面,开始与模型交互。
☝️ 如果你的模型尚未部署,Chat 窗口会提示你启用 orchestration service。启用后你就可以与所有模型对话。如果你现在部署 orchestration service,在 07-deploy-orchestration-service.md 练习中就不必再部署一次了。
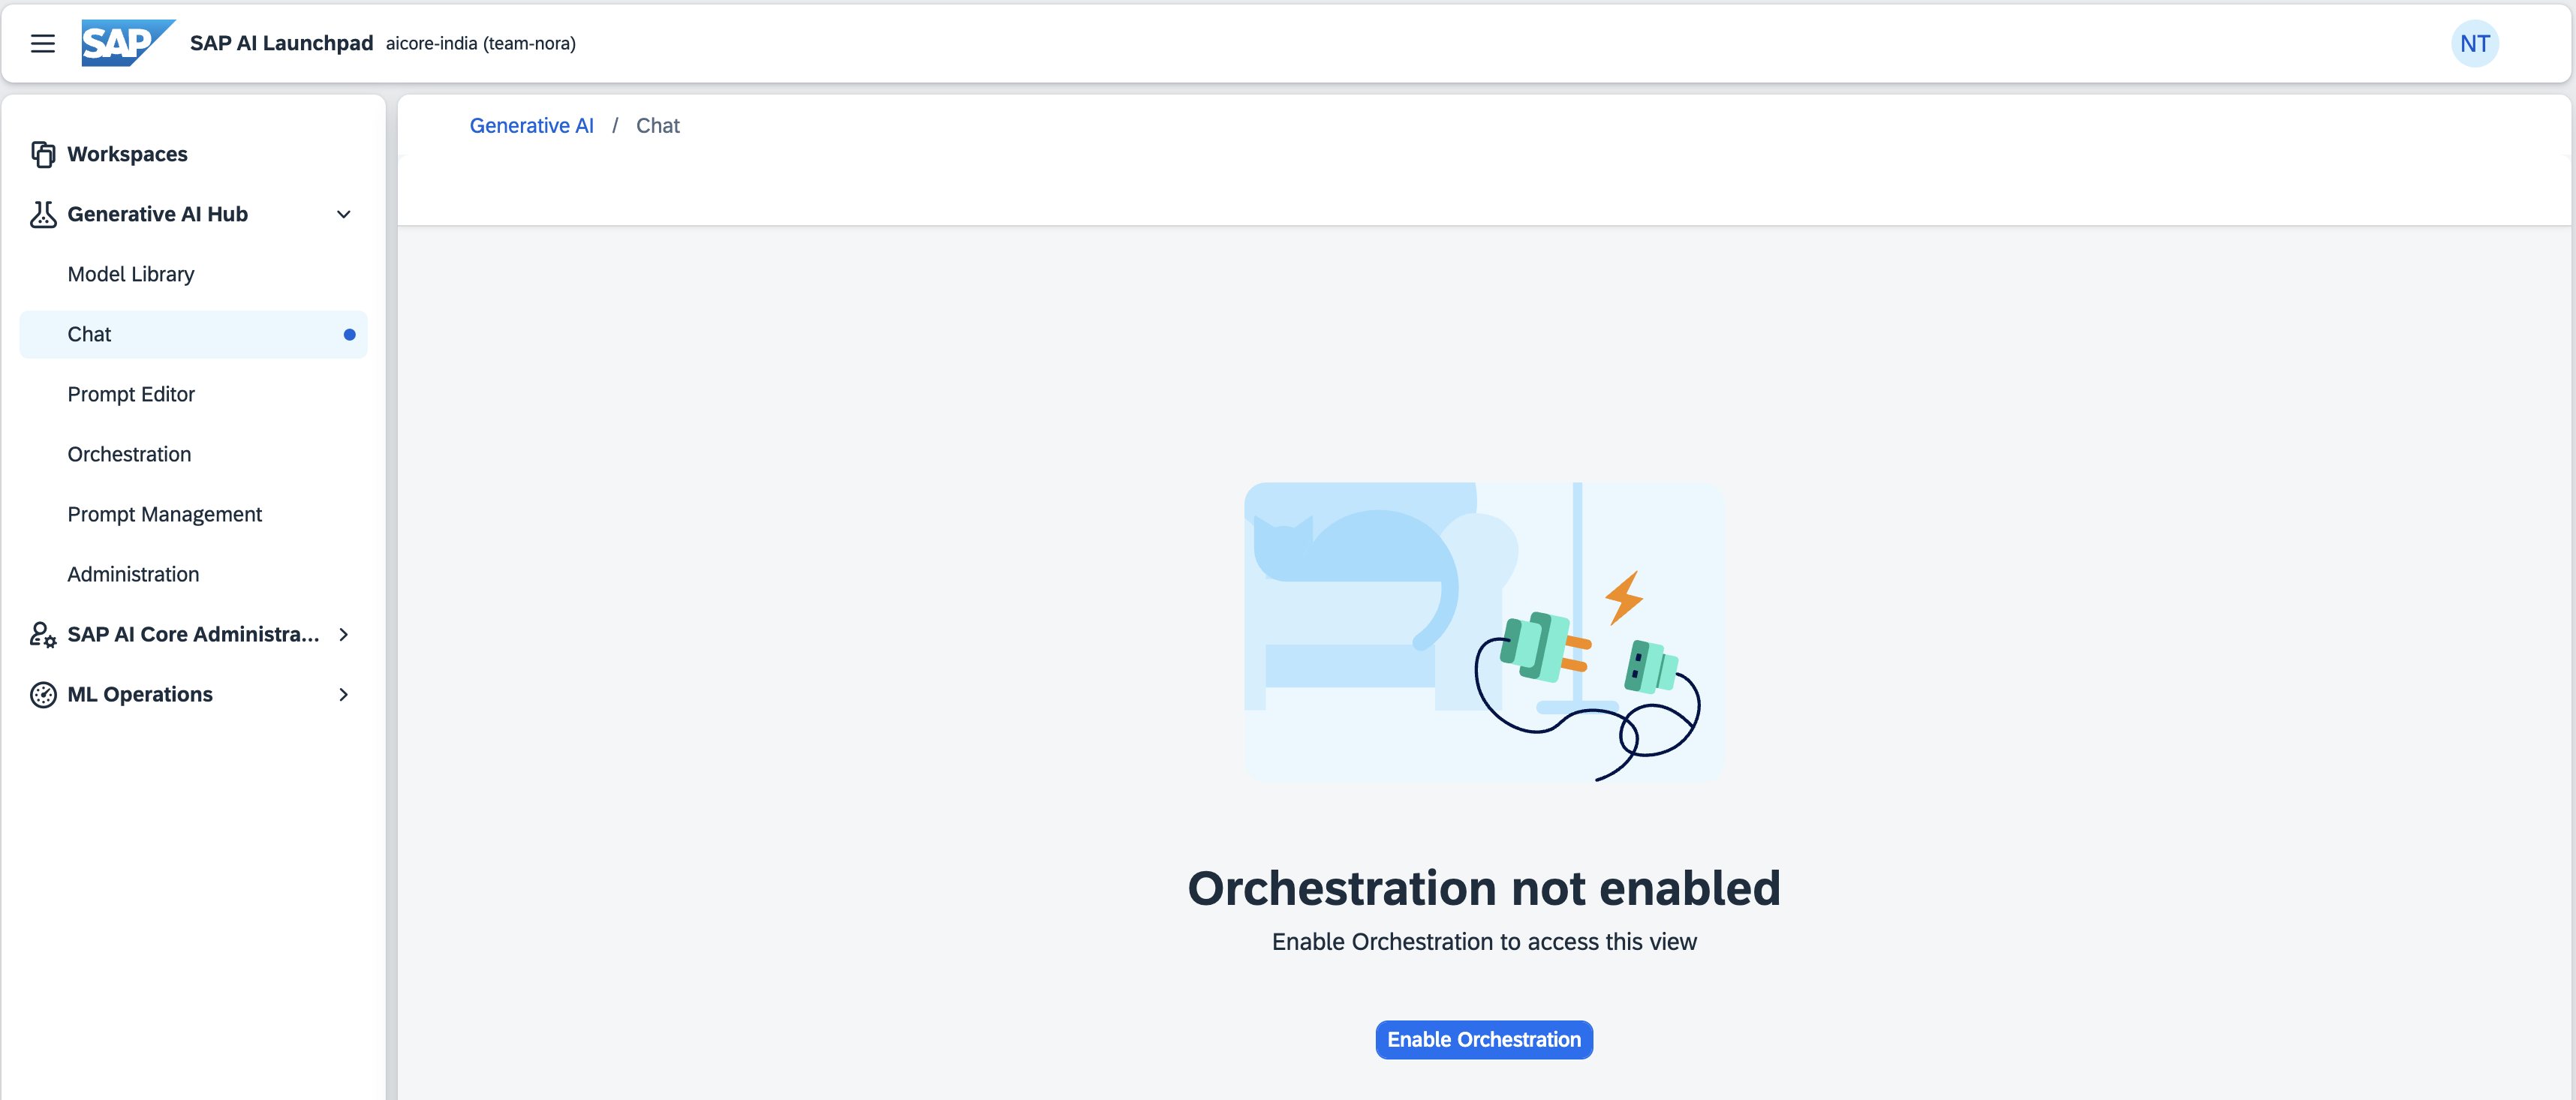
如果你的模型已部署,聊天界面会是这样:
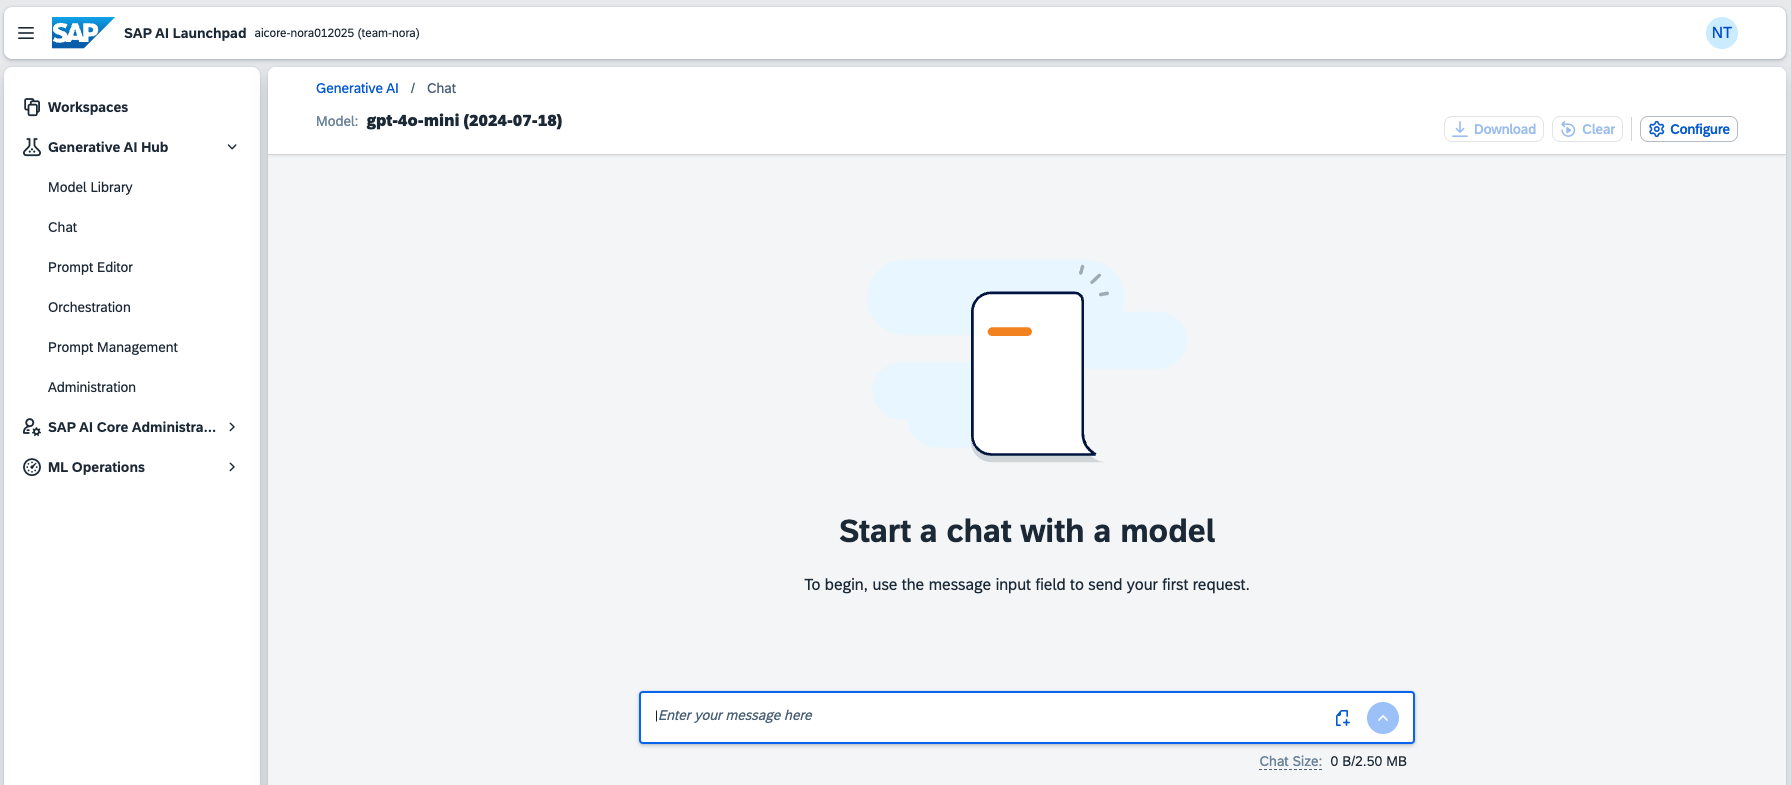
使用 Generative AI Hub 中的 Chat
👉 如果你关掉了之前的聊天窗口,随时可以打开 Generative AI Hub 标签页并选择 Chat。
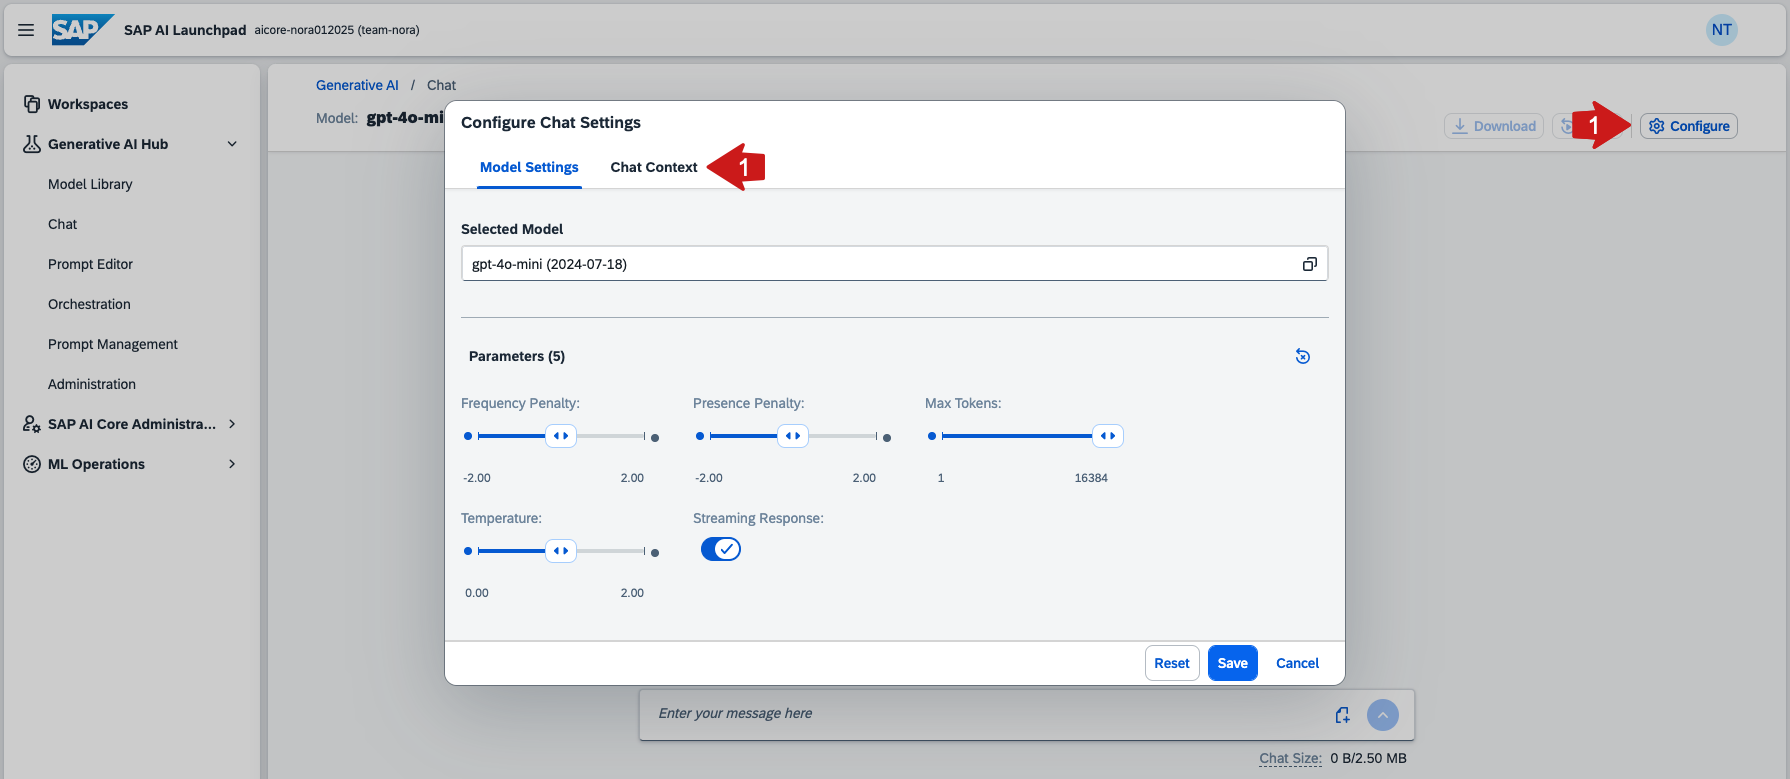
👉 点击 Configure,查看可用的字段。
在 Selected Model 下你可以看到所有已部署的模型。如果没有部署,这里为空,你也无法聊天。如果你部署了多个大语言模型,可以在这里选择要使用哪一个。
Frequency Penalty 参数用于惩罚在文本中出现过于频繁的词,帮助模型听起来不那么机械。
同样,Presence Penalty 越高,模型越有可能引入新话题,因为它会惩罚文本中已经出现过的词。
Max Tokens 参数用于设置模型输入与输出的规模。token 不是单个单词,通常长约 4-5 个字符。
Temperature 参数用于控制模型的创造性,决定它在选择序列中下一个 token 时的灵活程度。
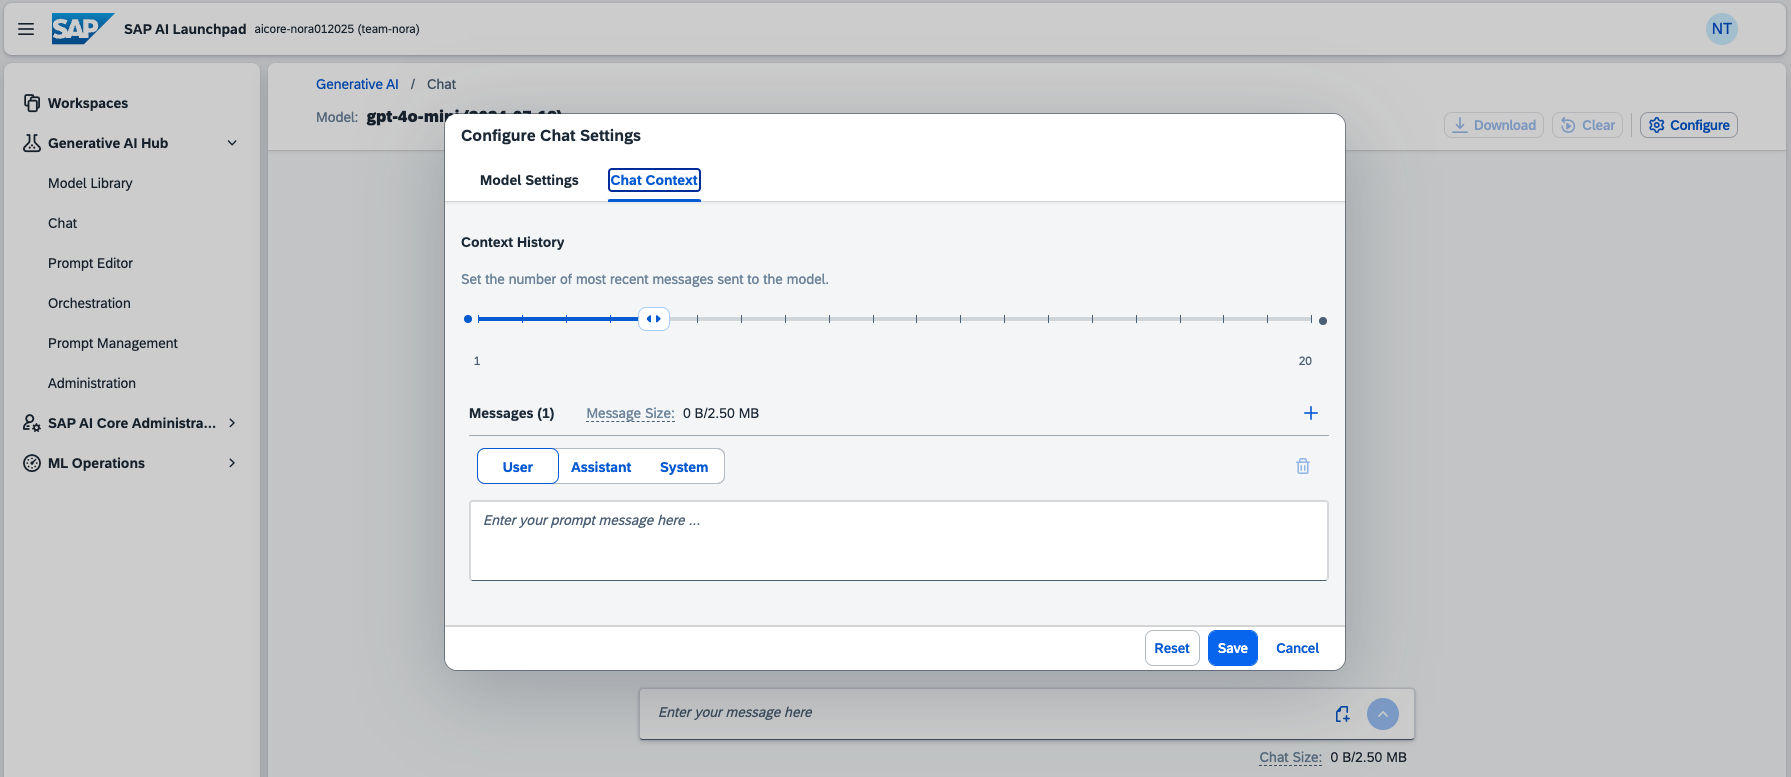
在 Chat Context 标签页中,Context History 正下方可以设置发送给模型的消息条数,即每次新请求要提供多少聊天历史作为上下文。这基本上就是模型的记忆容量。
你还可以添加 System Message 来描述角色,或补充关于期望模型做什么的更多信息。此外,你还可以提供示例输入与输出。
Prompt Engineering
👉 参照下面的例子尝试不同的 prompt engineering 技巧:
Zero shot:
The capital of the U.S. is:
Few shot:
Germany - Berlin
India - New Delhi
France -
Chain of thought(把整段内容复制到聊天窗口):
1. What is the most important city of a country?
2. In which country was the hot air balloon originally developed?
3. What is the >fill in the word from step 1< of the country >fill in the word from step 2<.
👉 试着在 System Message 中加点有趣的内容,例如「always respond like a pirate」,然后再次尝试这些 prompt。你也可以要求它用更技术化的口吻(像开发者),或更精美的口吻(像营销文案)。
👉 让模型统计单词中的字母。例如字母 r 在 strawberry 中出现了几次。你能设计出一个能正确统计的 prompt 吗?
👉 在进入下一个练习之前,请确保也部署了
Text Embedding 3 Small模型,后面会用到!点击一次 deploy 按钮即可,之后可以在ML Operations>Deployments中看到你的部署。
使用 Generative AI Hub 中的 Prompt Editor
如果你想保存 prompt 及其回答以便日后回看或对比 prompt,Prompt Editor 会很有用。你常常会发现有些任务可以定期交给 LLM 处理。这种情况下,你还可以保存多个效果不错的 prompt 版本,省去每次重新编写的工作。
在 Chat 中能设置的参数在这里同样可以设置。此外,你还可以在回答下方查看 prompt 使用了多少 token。
👉 转到 Prompt Editor,选择模型,并把 Max Tokens 再次设置为最大值
👉 粘贴下面的示例,点击 Run 试用该示例。
👉 为你的 prompt 填写 Name、Collection 名称,然后保存该 prompt。
👉 如果你现在进入 Prompt Management,就能找到之前保存的 prompt。要再次运行该 prompt,点击 Open in Prompt Editor。你也可以点击 Select 选择其他已保存的 prompt。
Chain of thought prompt - 客户支持(把整段内容复制到 prompt editor):
You are working at a big tech company and you are part of the support team.
You are tasked with sorting the incoming support requests into: German, English, Polish or French.

Review the incoming query.
Identify the language of the query as either German, English, Polish, or French.
- Example: 'bad usability. very confusing user interface.' - English
Count the number of queries for each language: German, English, Polish, and French.
Summarize the key pain points mentioned in the queries in bullet points in English.

Queries:
- What are the shipping costs to Australia?
- Kann ich einen Artikel ohne Kassenbon umtauschen?
- Offrez-vous des réductions pour les achats en gros?
- Can I change the delivery address after placing the order?
- Comment puis-je annuler mon abonnement?
- Wo kann ich den Status meiner Reparatur einsehen?
- What payment methods do you accept?
- Czemu to tak długo ma iść do Wrocławia, gdy cena nie jest wcale niska?
- Quel est le délai de livraison estimé pour le Mexique?
- Gibt es eine Garantie auf elektronische Geräte?
- I’m having trouble logging into my account, what should I do?

👉 如果还有时间,可以让 LLM 再生成一些不同的支持请求,以增加数据量。
小结
到这里,你已经会使用 SAP AI Launchpad 中的 Generative AI Hub 用户界面查询 LLM 并保存重要的 prompt。你也会理解如何用 prompt engineering 技巧优化大语言模型的输出。
延伸阅读
下一个练习
搭建 SAP Business Application Studio 与 dev space
SAP Business Application Studio 基于 Code-OSS,这是用于构建 Visual Studio Code 的开源项目。SAP Business Application Studio 以云服务形式提供,具备与主流 IDE 类似的桌面级体验,配有命令行与优化过的编辑器。
SAP Business Application Studio 的核心是 dev space。dev space 相当于云端的隔离虚拟机,按业务场景预置了定制工具与运行时,例如 SAP Fiori、SAP S/4HANA 扩展、Workflow、Mobile 等。这简化并加速了开发环境的搭建,让你能高效地在本地或云端开发、测试、构建并运行解决方案。
打开 SAP Business Application Studio
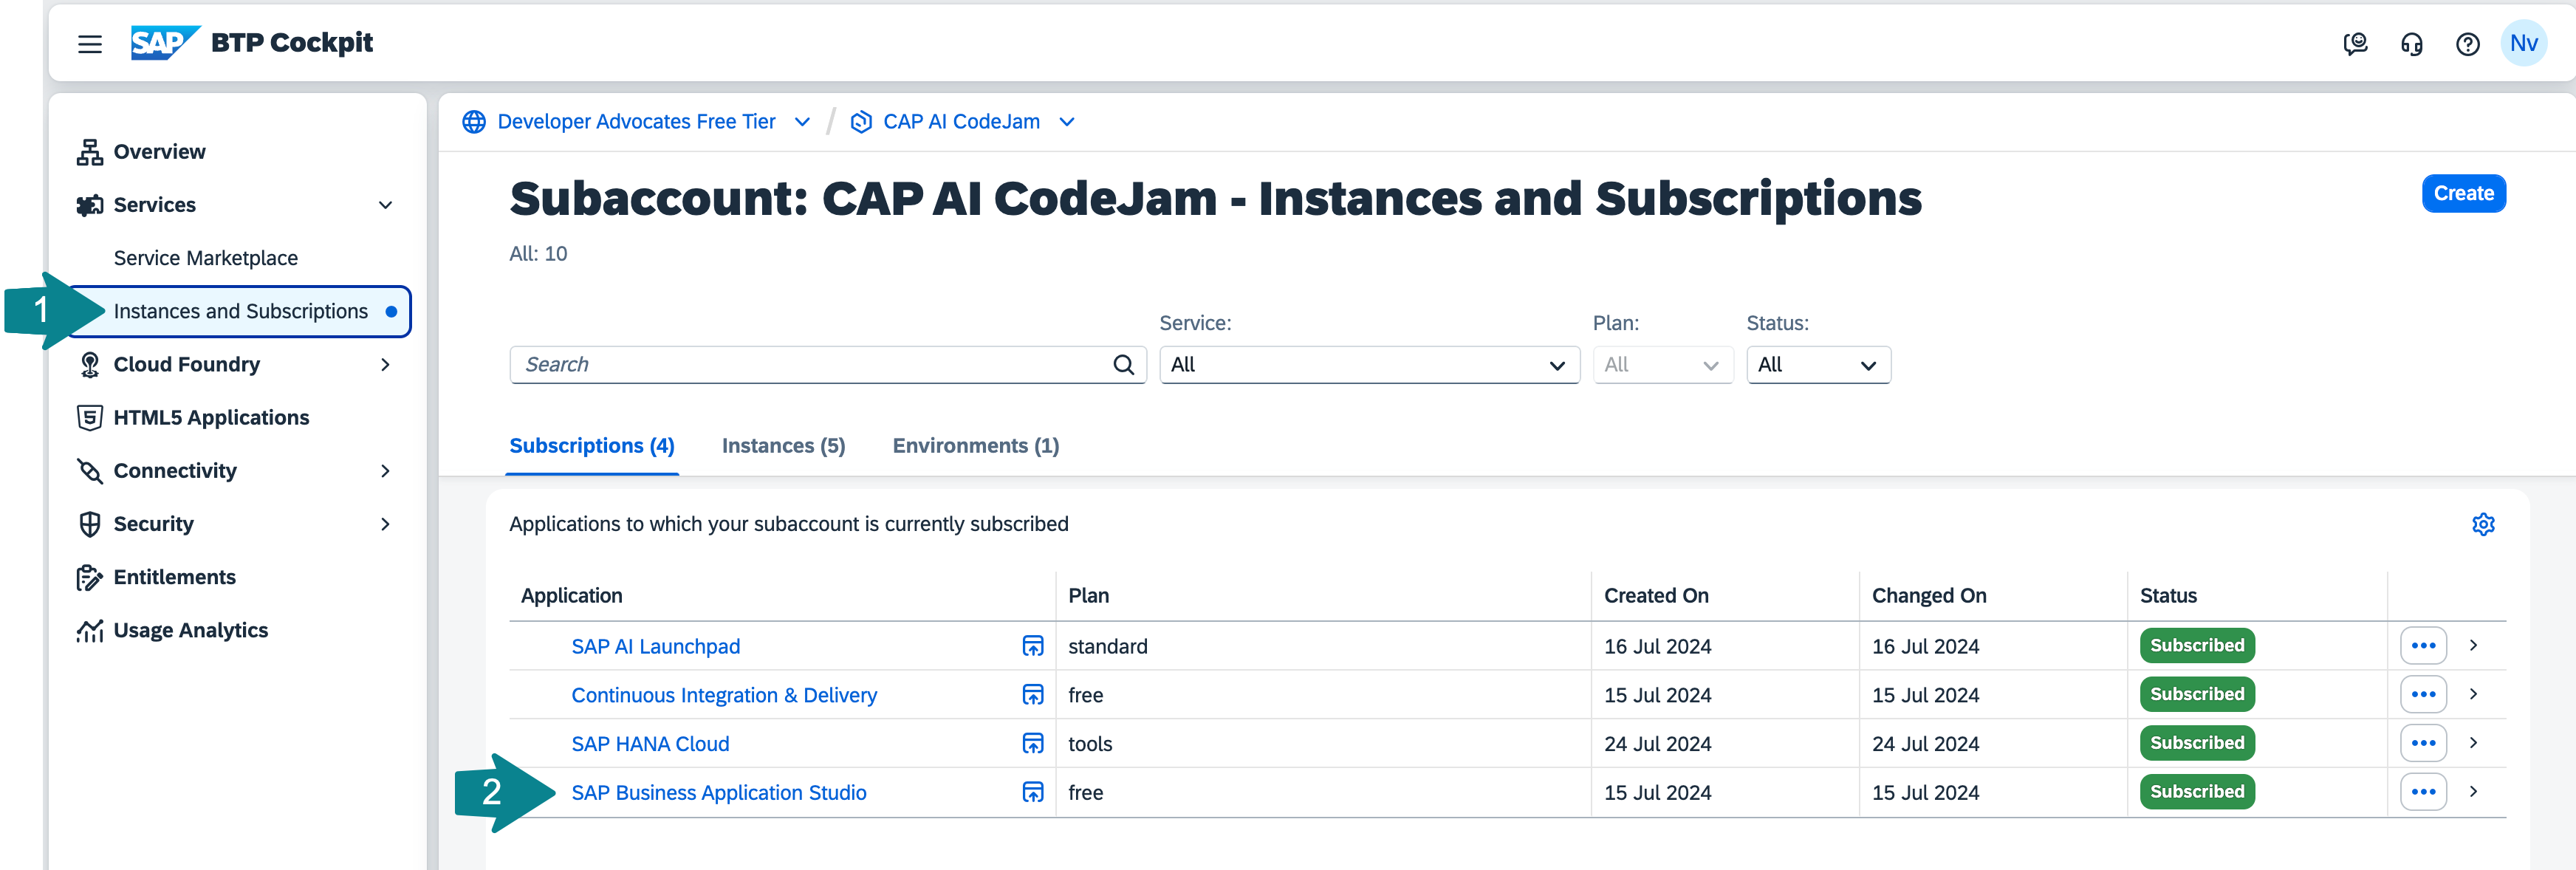
👉 返回你的 BTP cockpit。
👉 导航到 Instances and Subscriptions,打开 SAP Business Application Studio。
为 CodeJam 练习创建新的 Dev Space
👉 创建一个新的 Dev Space。
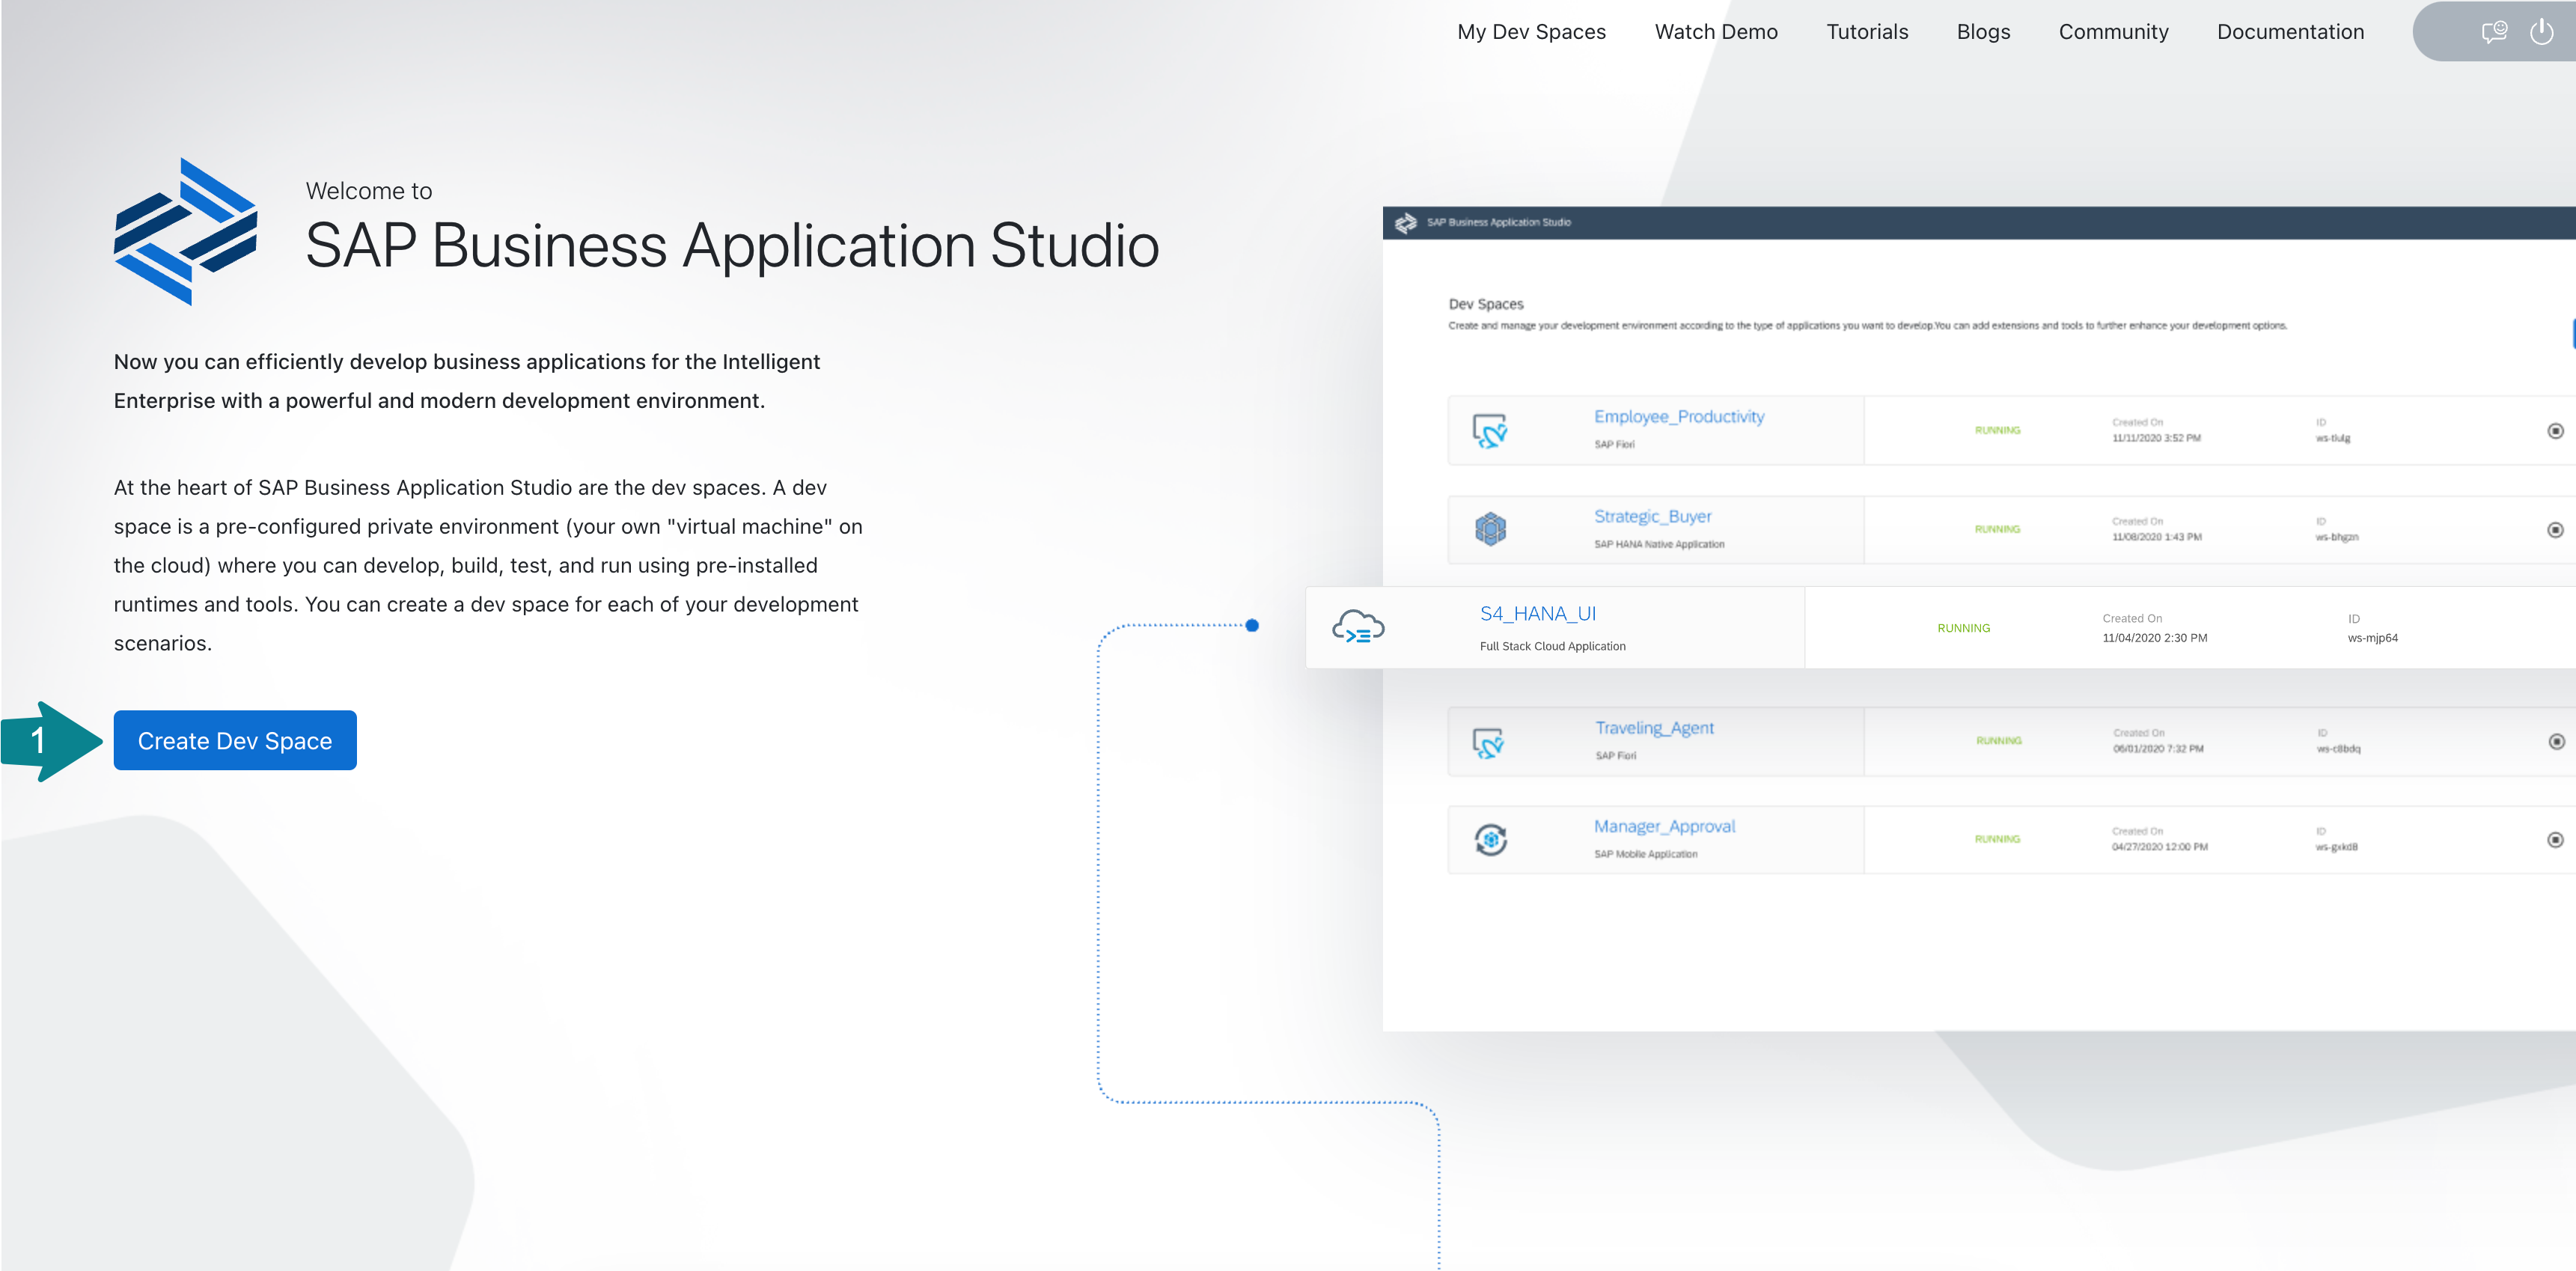
👉 输入 Dev space 名称 GenAICodeJam,在 Additional SAP Extensions 中选择 Basic 类型的应用与 Python Tools。
👉 点击 Create Dev Space。
你应该会看到该 dev space 处于 STARTING 状态。

👉 等待 dev space 进入 RUNNING 状态,然后打开它。

从 Git 仓库克隆练习
👉 在 BAS 中打开 dev space 后,用下面 URL 通过任一可用方式克隆这个包含练习的 Git 仓库:
https://github.com/SAP-samples/generative-ai-codejam.git
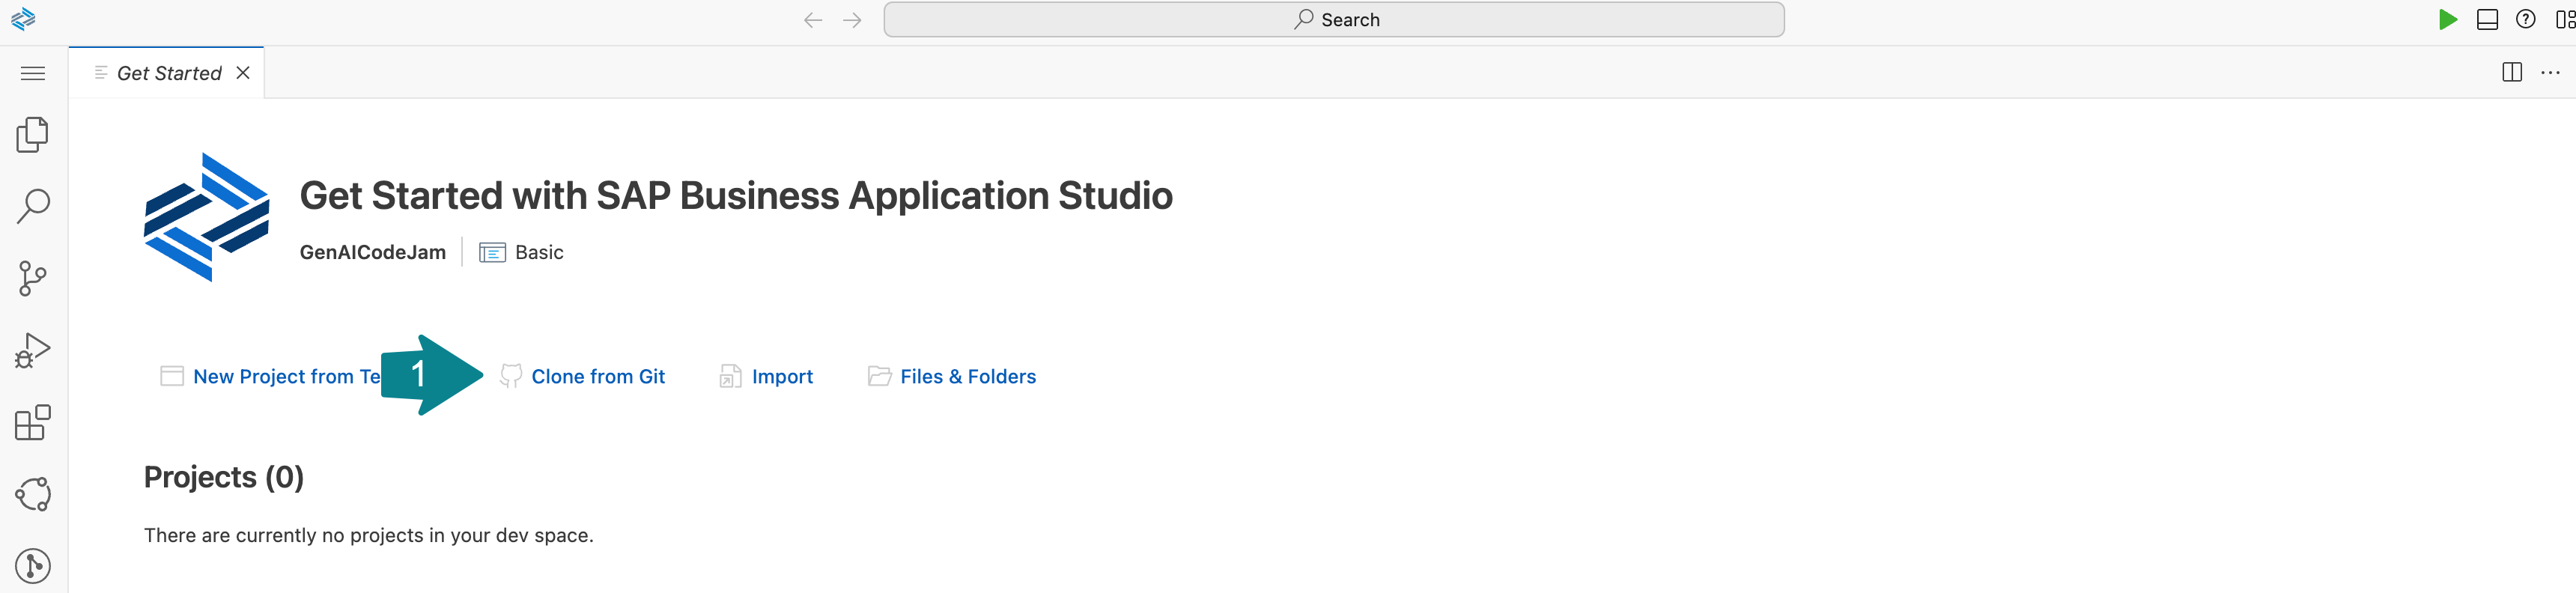
👉 点击 Open,在 Explorer 视图中打开项目。
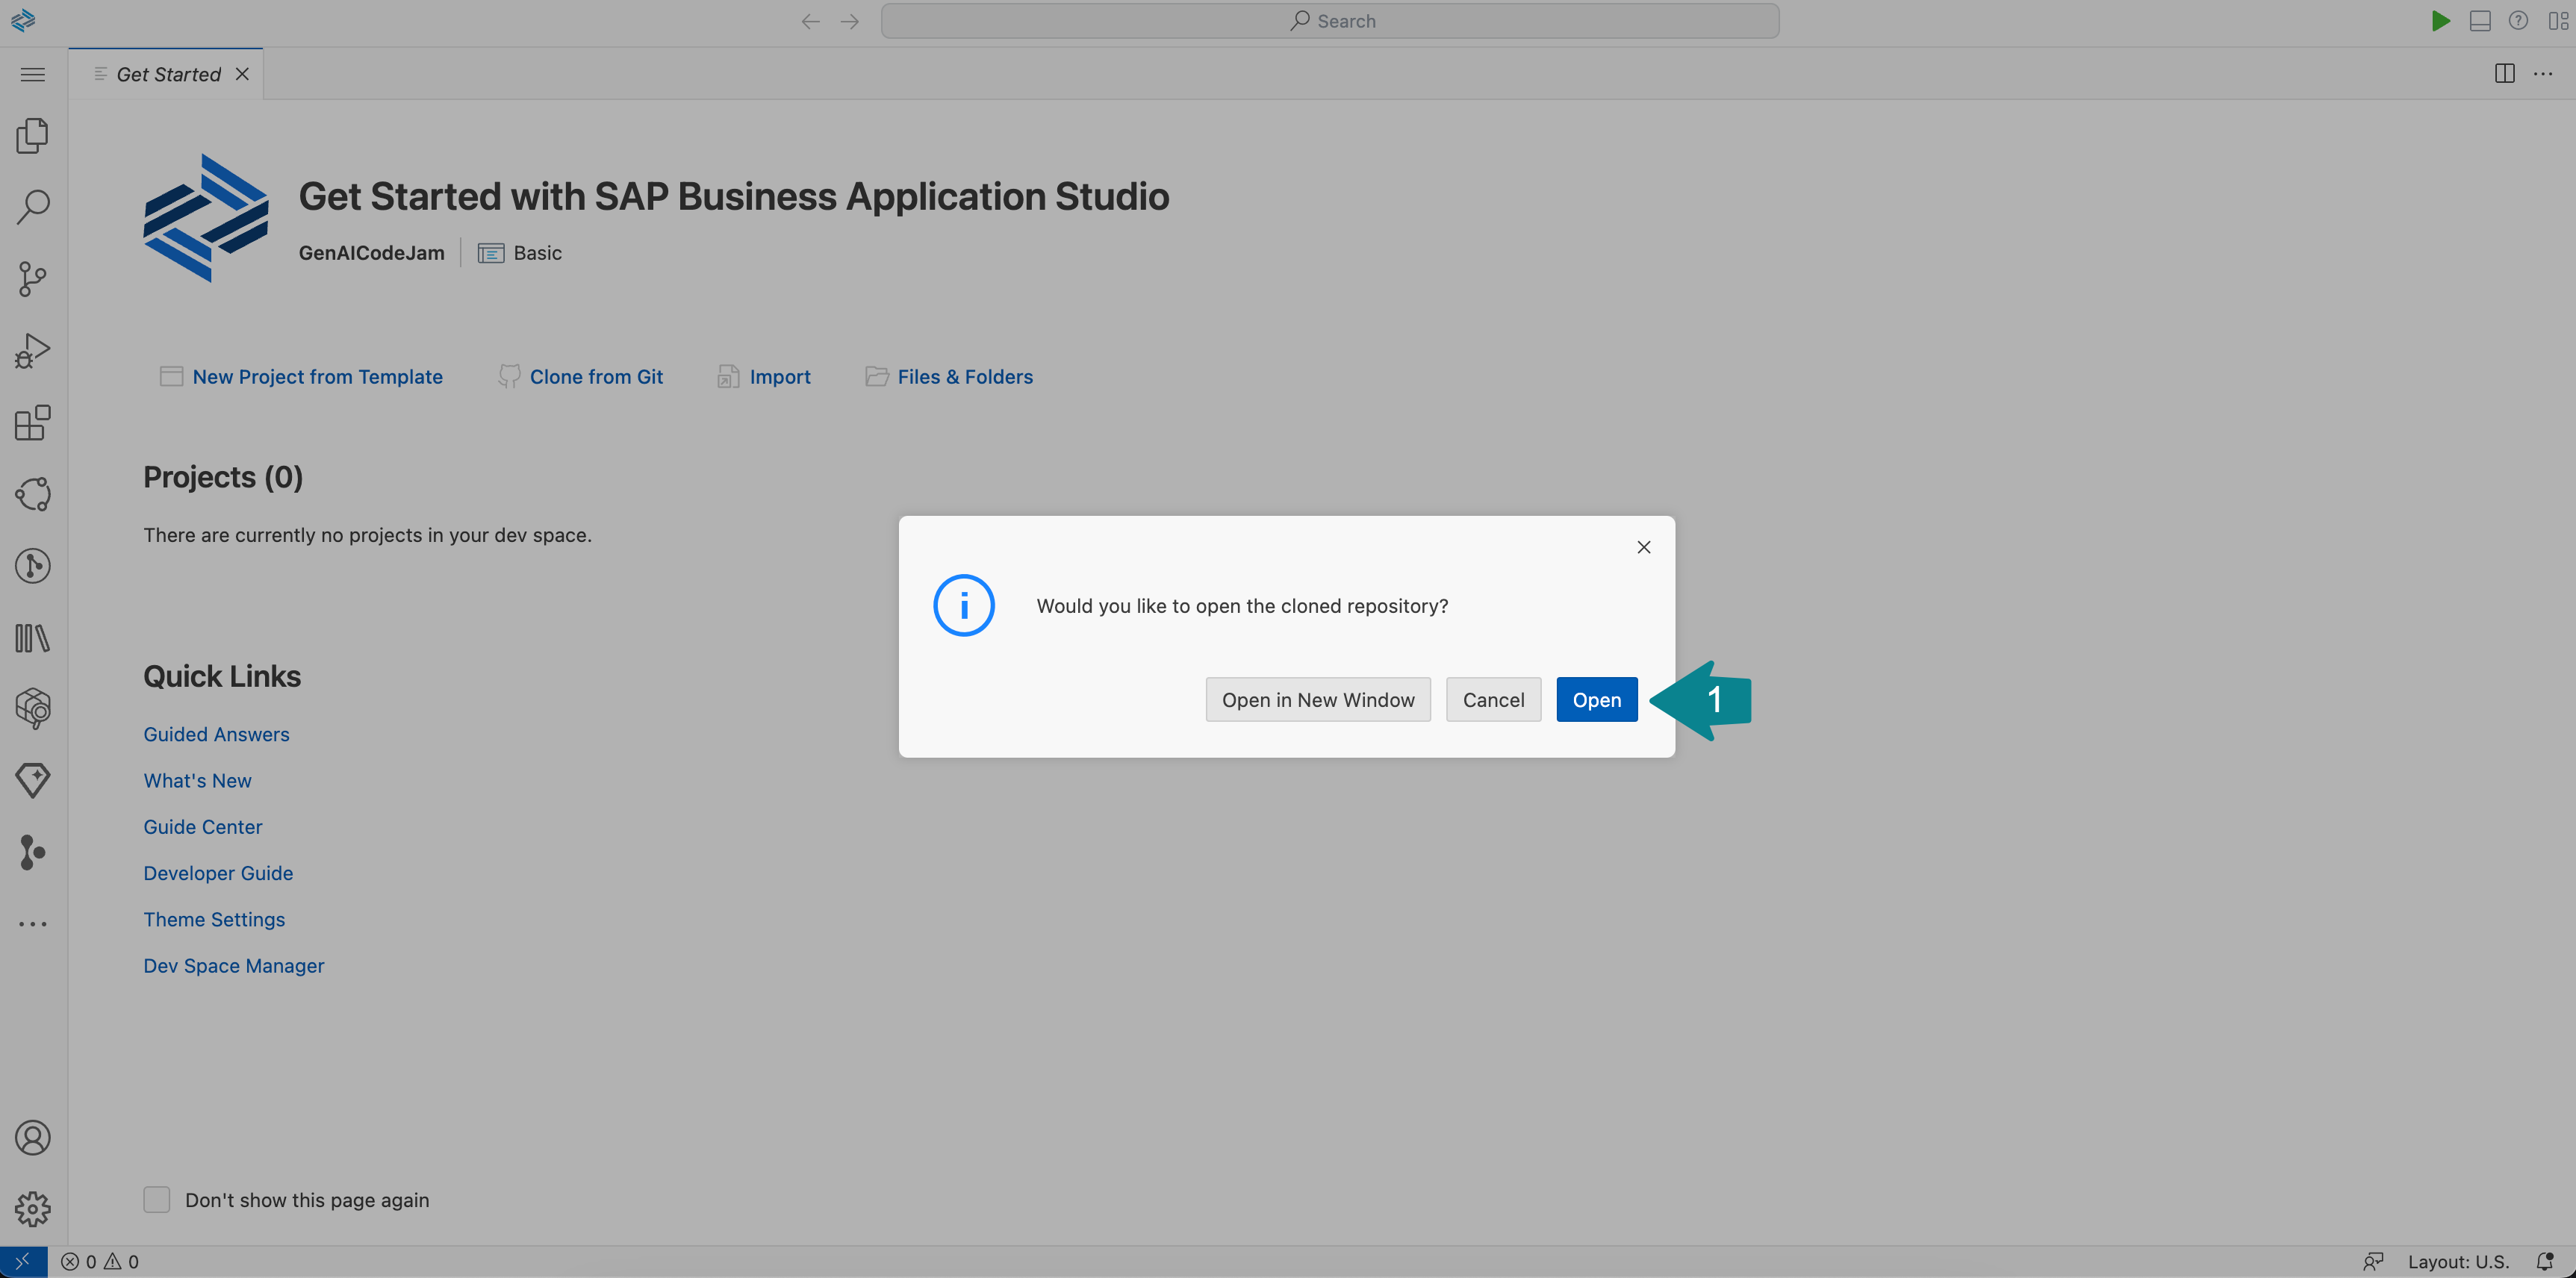
打开工作区
克隆下来的仓库中包含 codejam.code-workspace 文件,因此系统会询问你是否打开它。
👉 点击 Open Workspace。
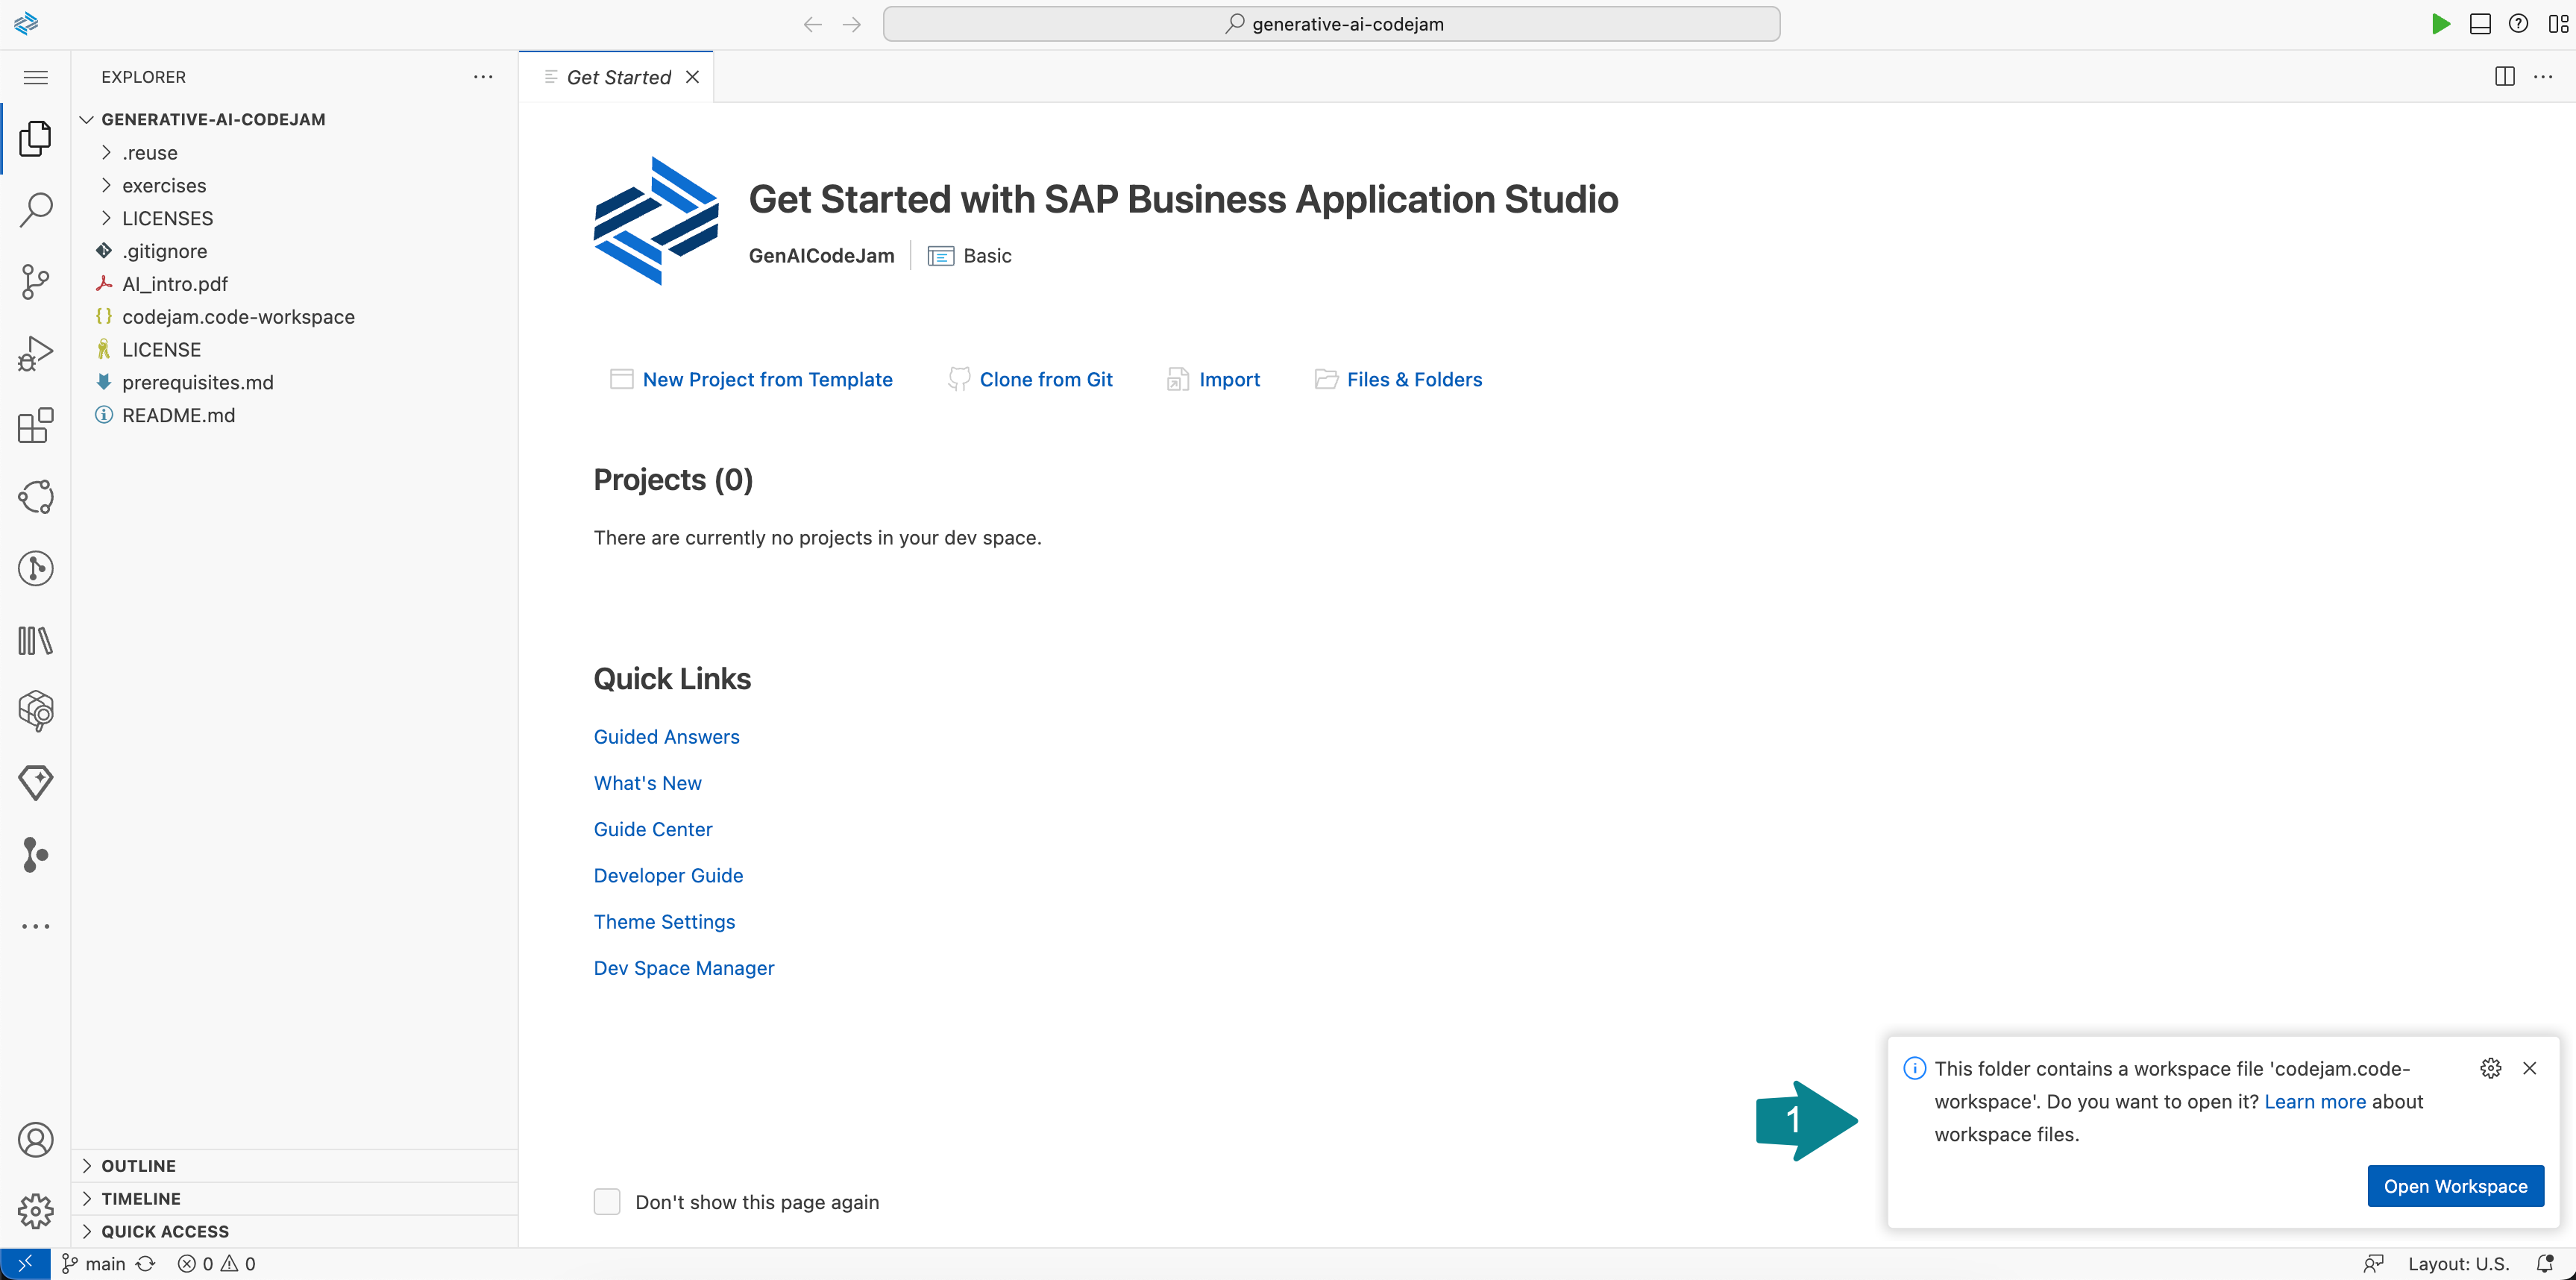
☝️ 如果你错过了上一个对话框,可以进入 BAS 的 Explorer,打开 codejam.code-workspace 文件,再点击 Open Workspace。
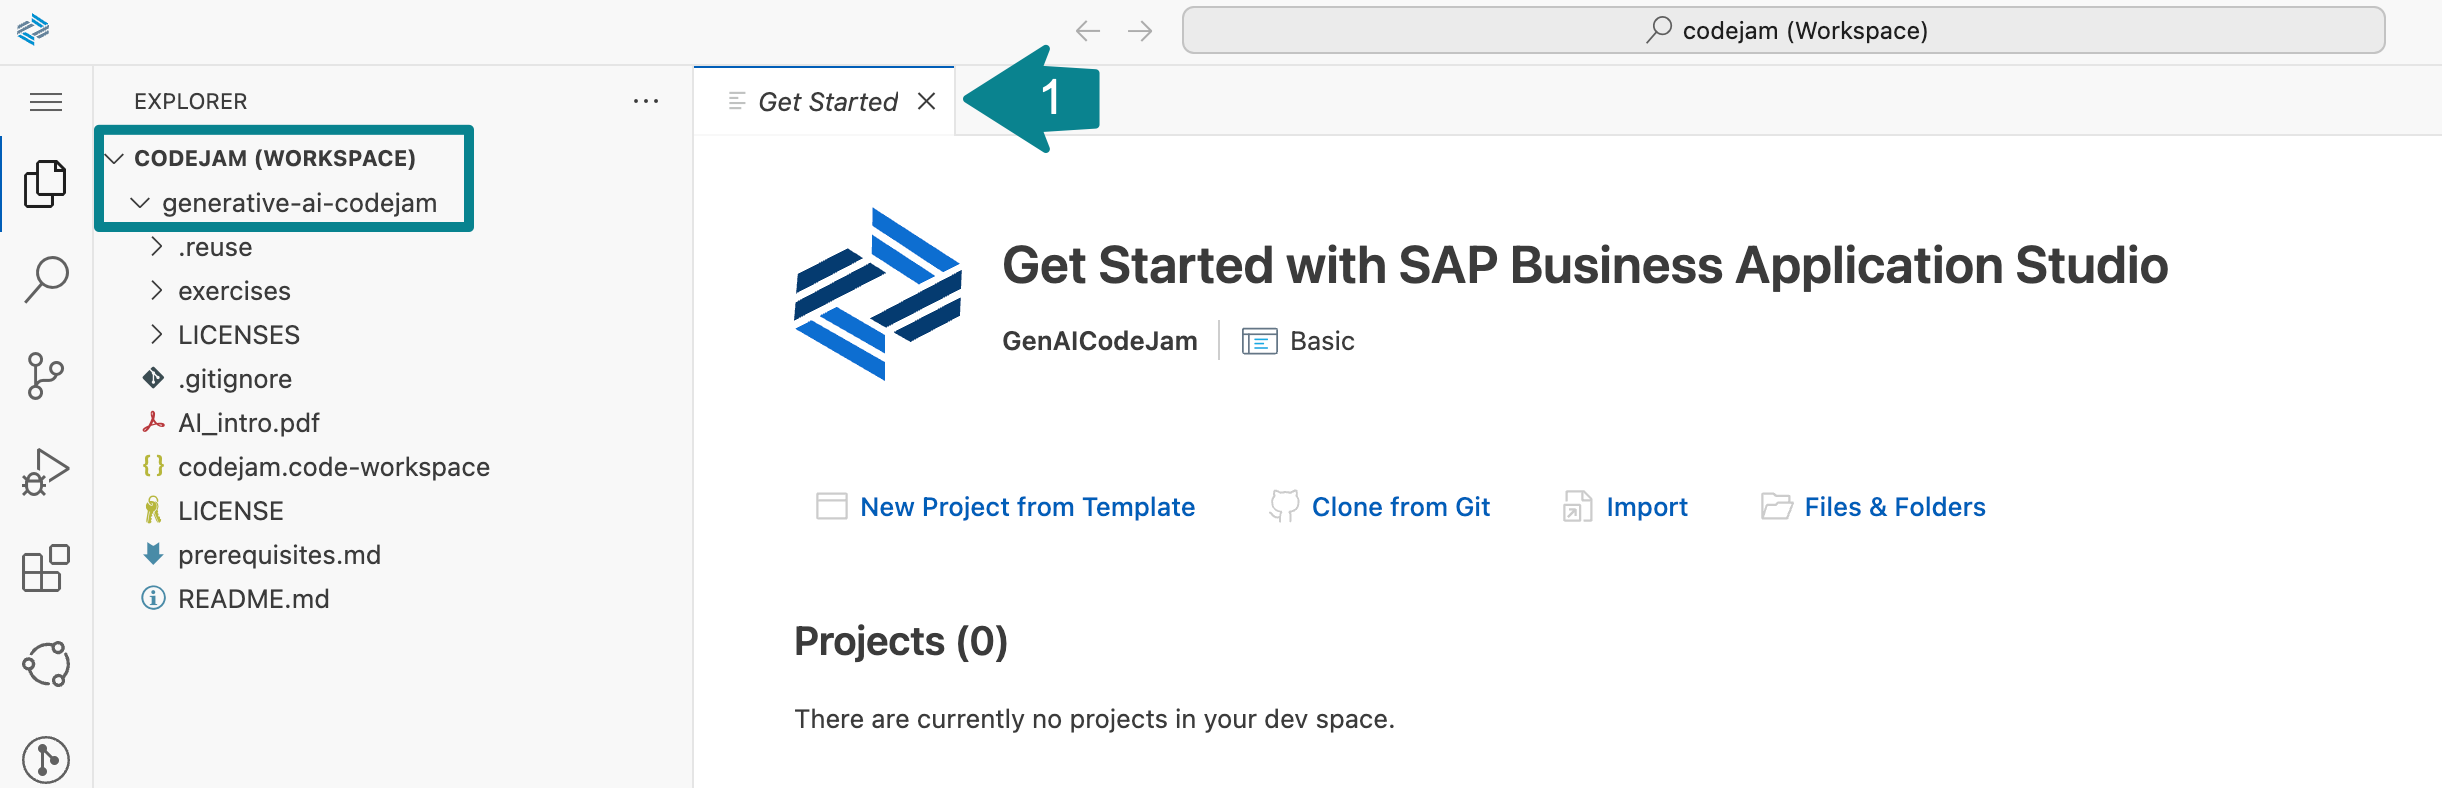
你应该会看到:
项目层级根部的
CODEJAM工作区,以及顶层文件夹名
generative-ai-codejam。
👉 你可以关闭 Get Started 标签页。
配置到 Generative AI Hub 的连接
👉 返回你的 BTP cockpit。
👉 导航到 Instances and Subscriptions,打开 SAP AI Core 实例的服务绑定(service binding)。
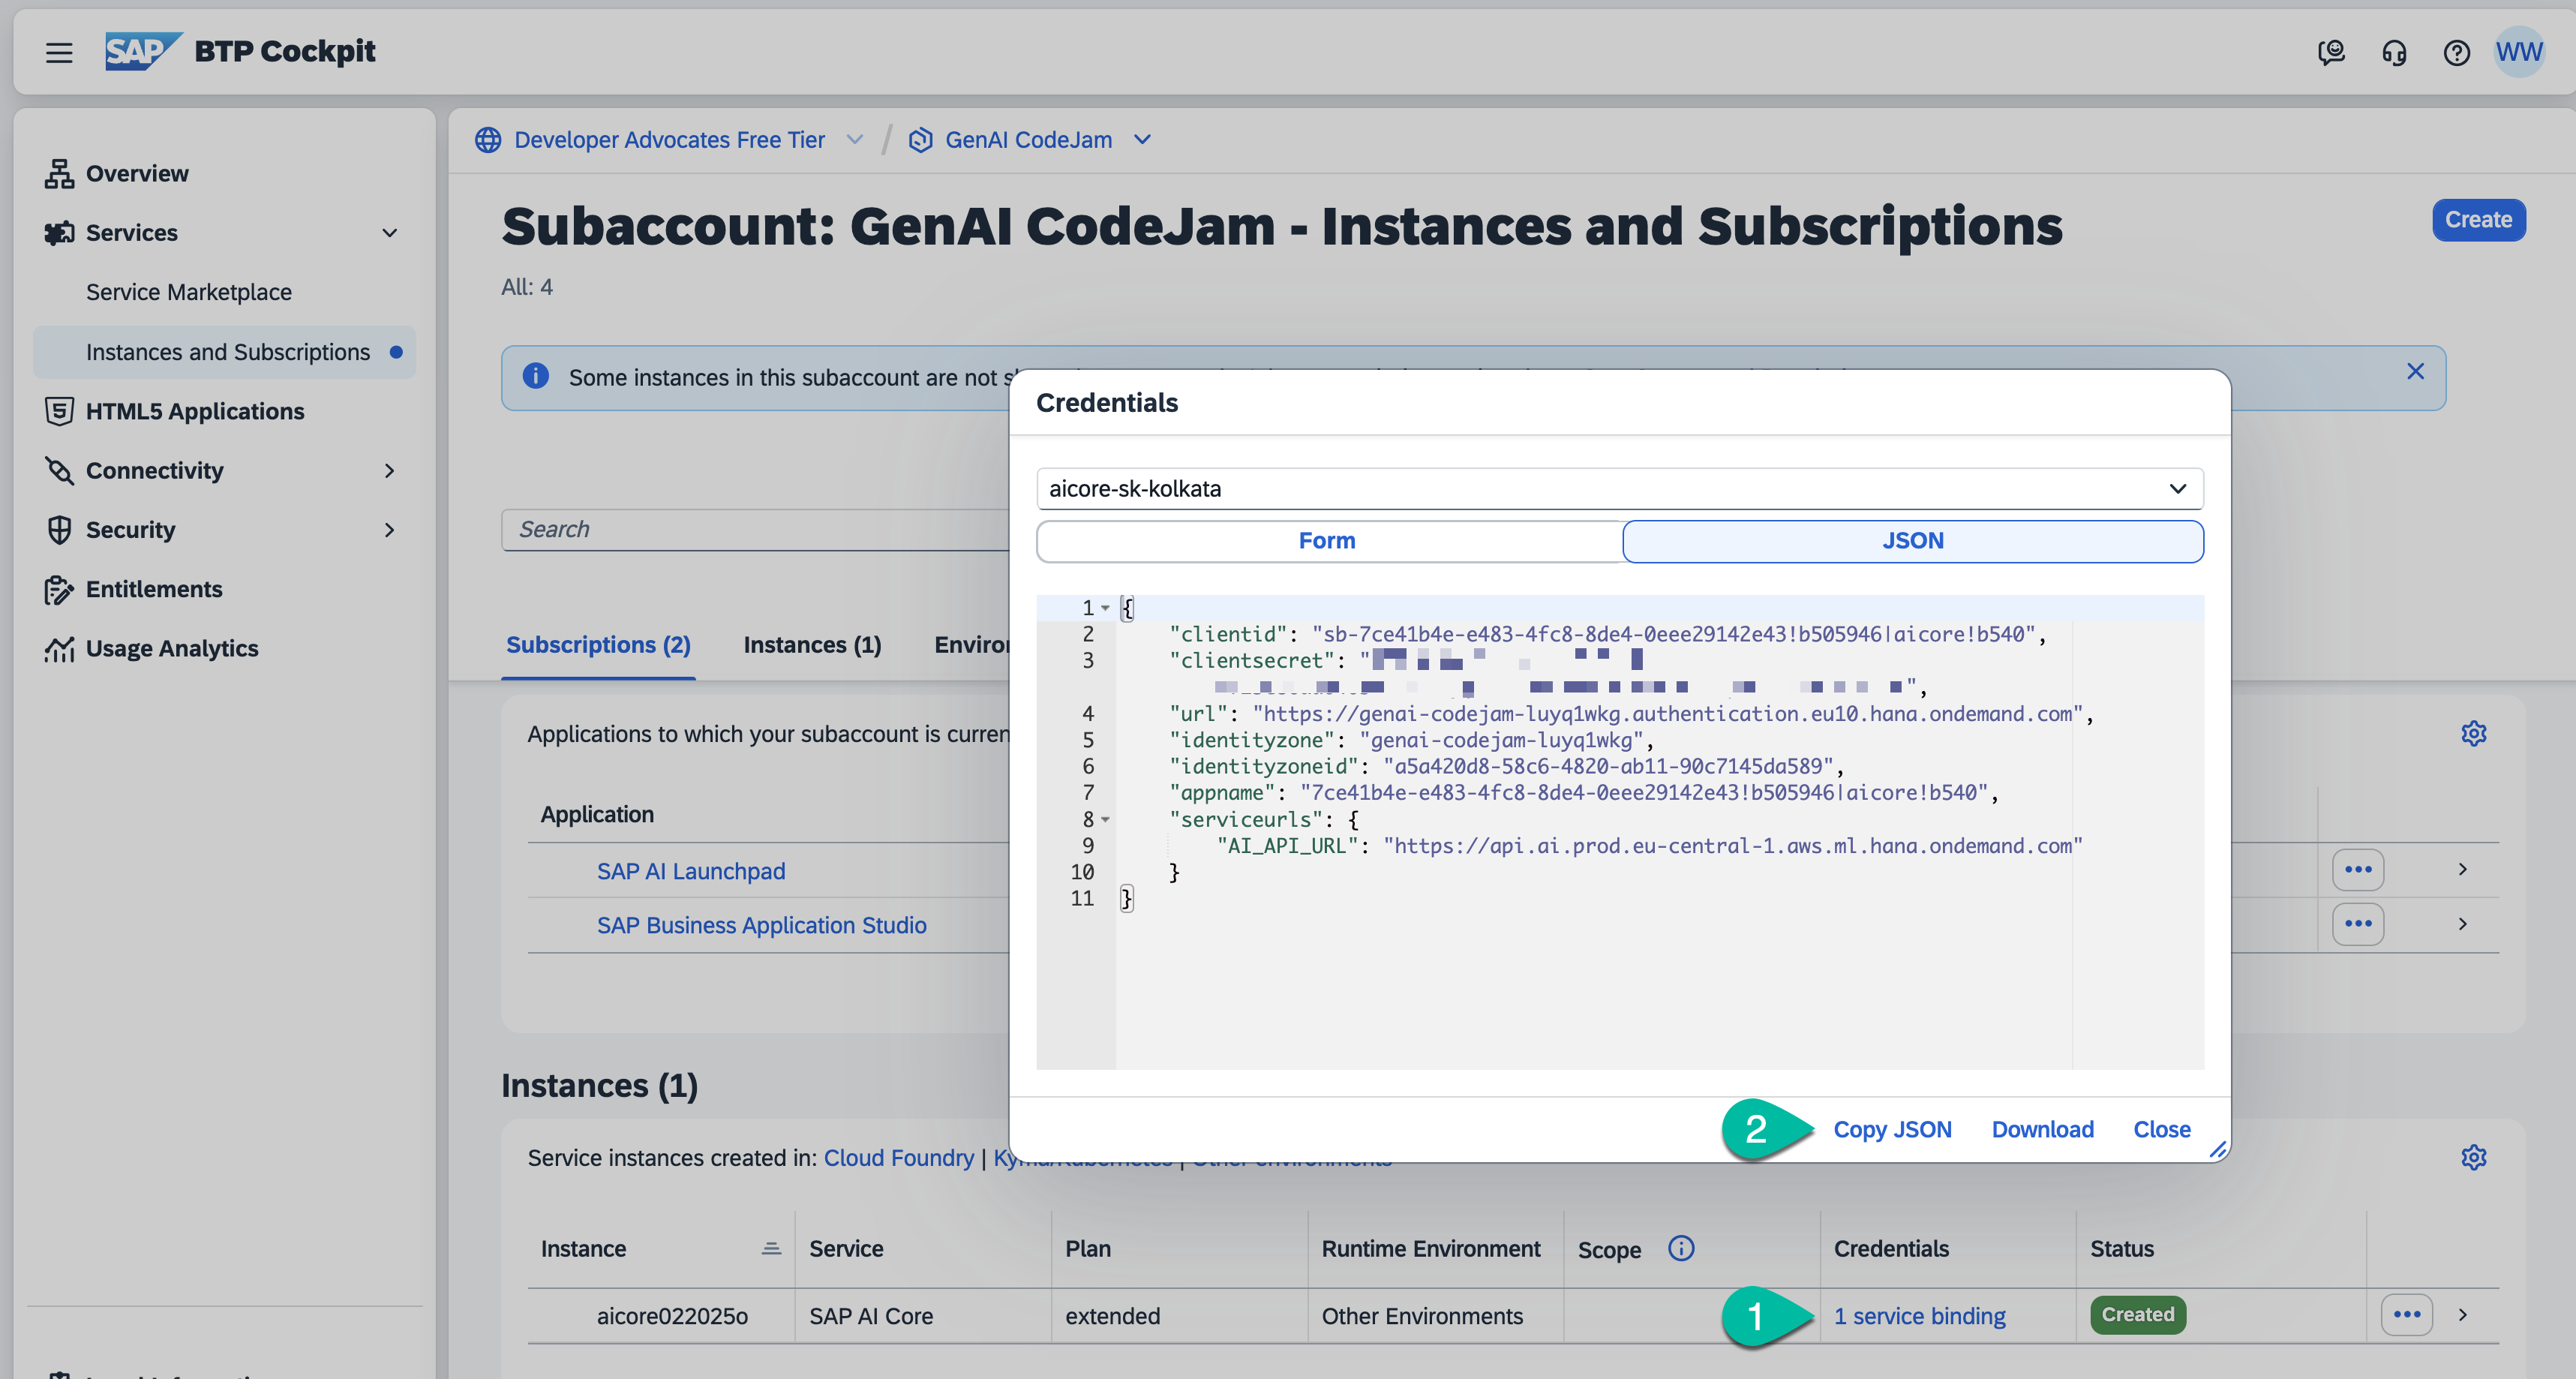
👉 点击 Copy JSON。
👉 回到 BAS,在 generative-ai-codejam/ 目录下新建文件 .aicore-config.json。
👉 把服务密钥粘贴到 generative-ai-codejam/.aicore-config.json,内容大致如下。
{
  "appname": "7ce41b4e-e483-4fc8-8de4-0eee29142e43!b505946|aicore!b540",
  "clientid": "sb-7ce41b4e-e483-4fc8-8de4-0eee29142e43!b505946|aicore!b540",
  "clientsecret": "...",
  "identityzone": "genai-codejam-luyq1wkg",
  "identityzoneid": "a5a420d8-58c6-4820-ab11-90c7145da589",
  "serviceurls": {
    "AI_API_URL": "https://api.ai.prod.eu-central-1.aws.ml.hana.ondemand.com"
  },
  "url": "https://genai-codejam-luyq1wkg.authentication.eu10.hana.ondemand.com"
}
创建 Python 虚拟环境并安装 SAP 的 Python SDK for Generative AI Hub
👉 打开一个新的终端。
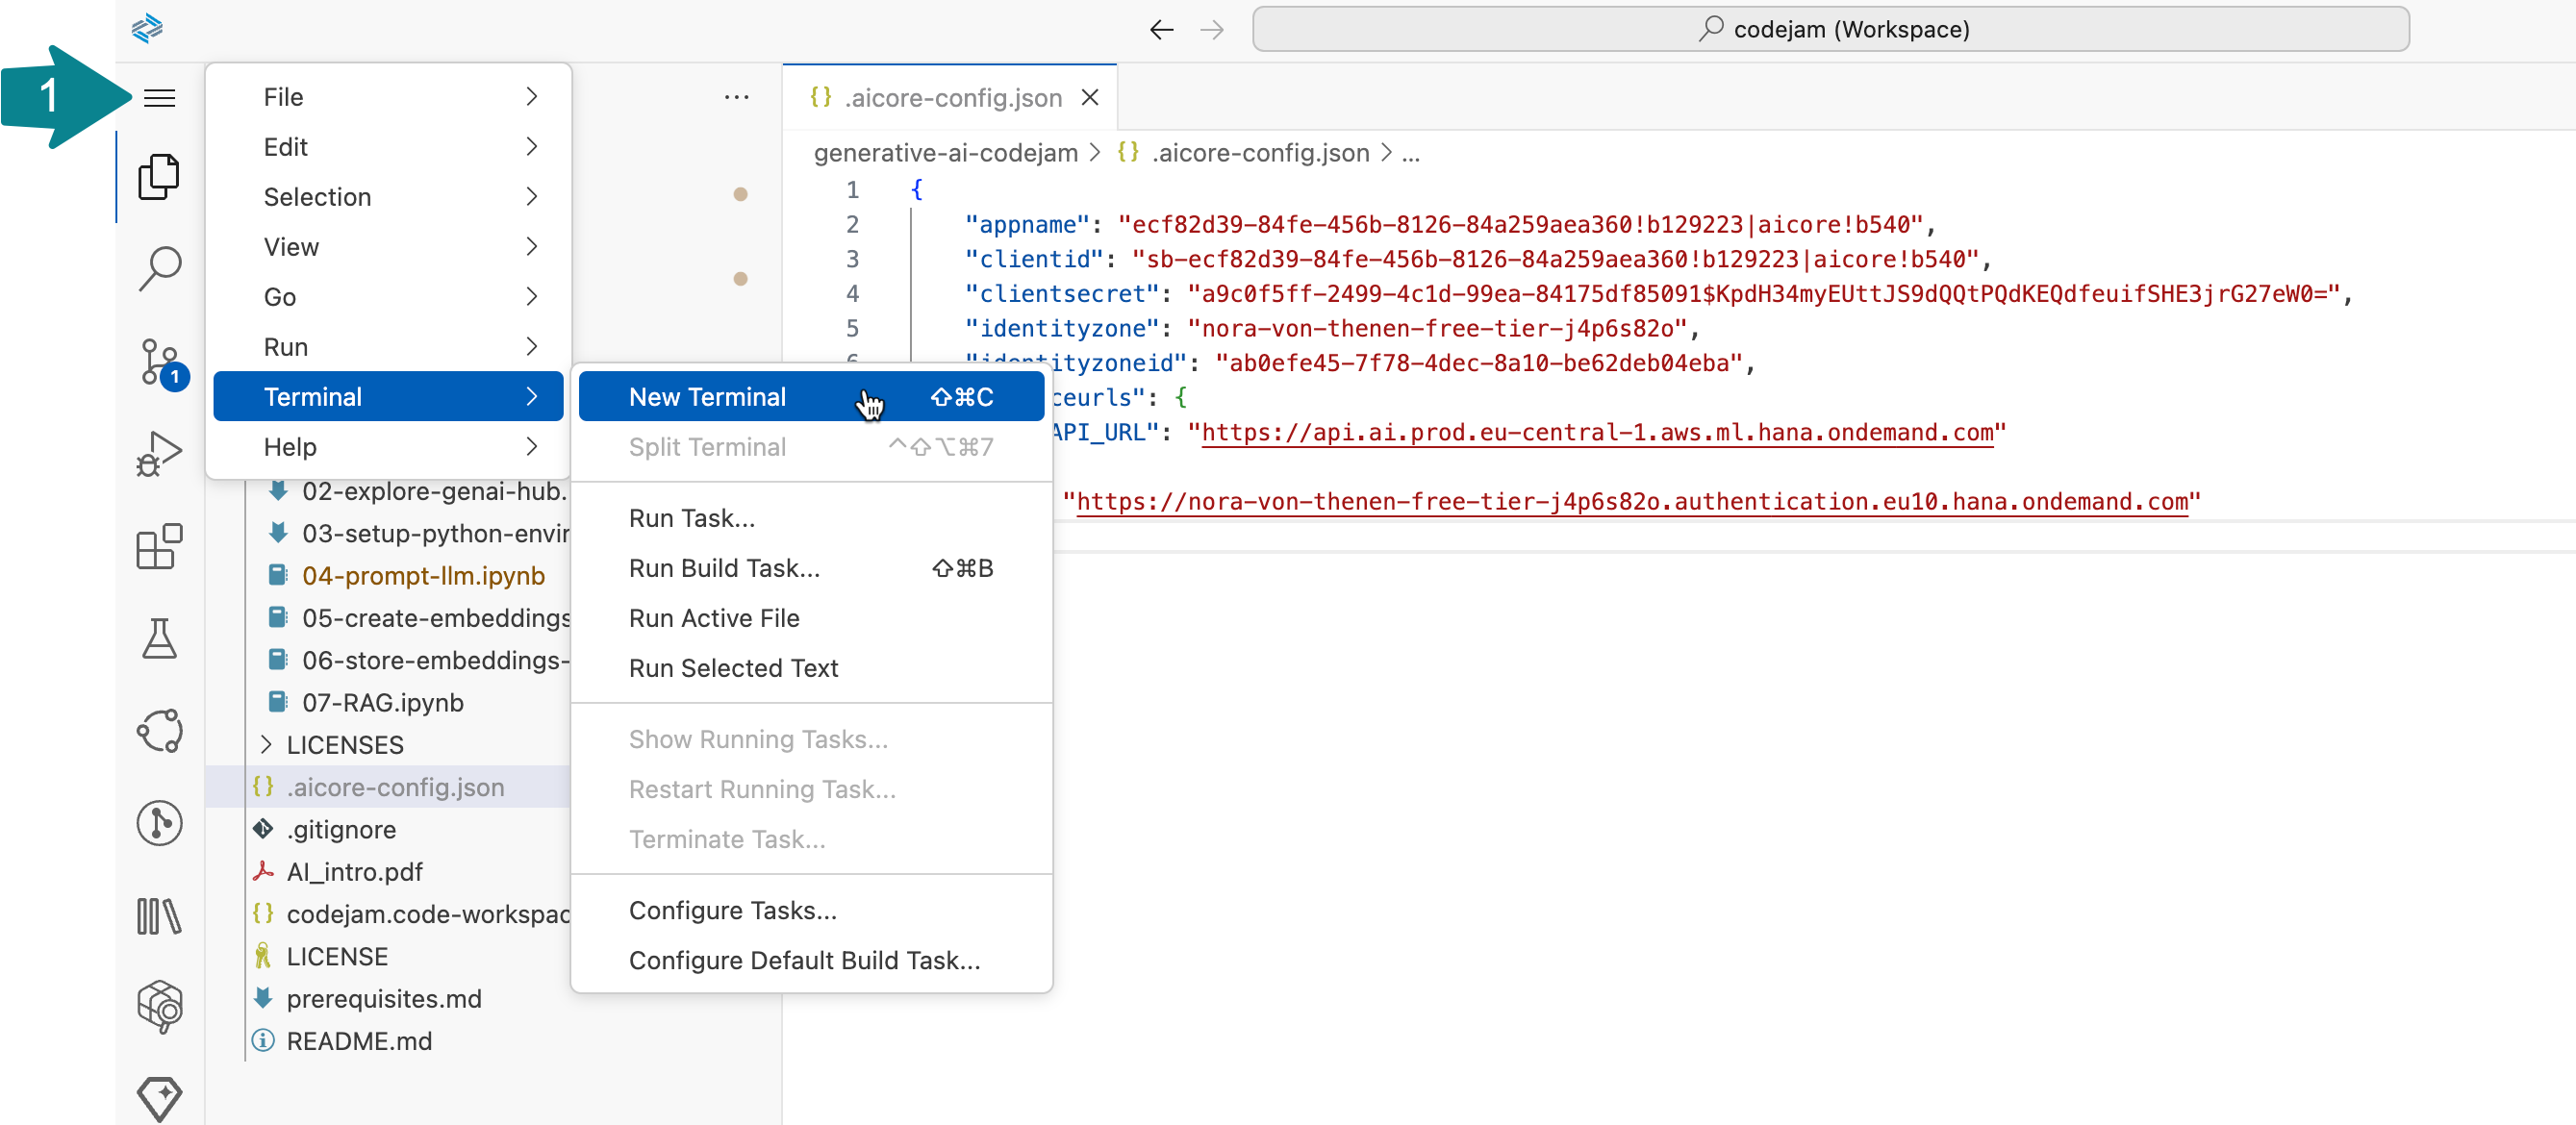
👉 用下面的命令创建虚拟环境:
python3 -m venv ~/projects/generative-ai-codejam/env --upgrade-deps
👉 像这样激活 env 虚拟环境,并确认它已激活:
source ~/projects/generative-ai-codejam/env/bin/activate
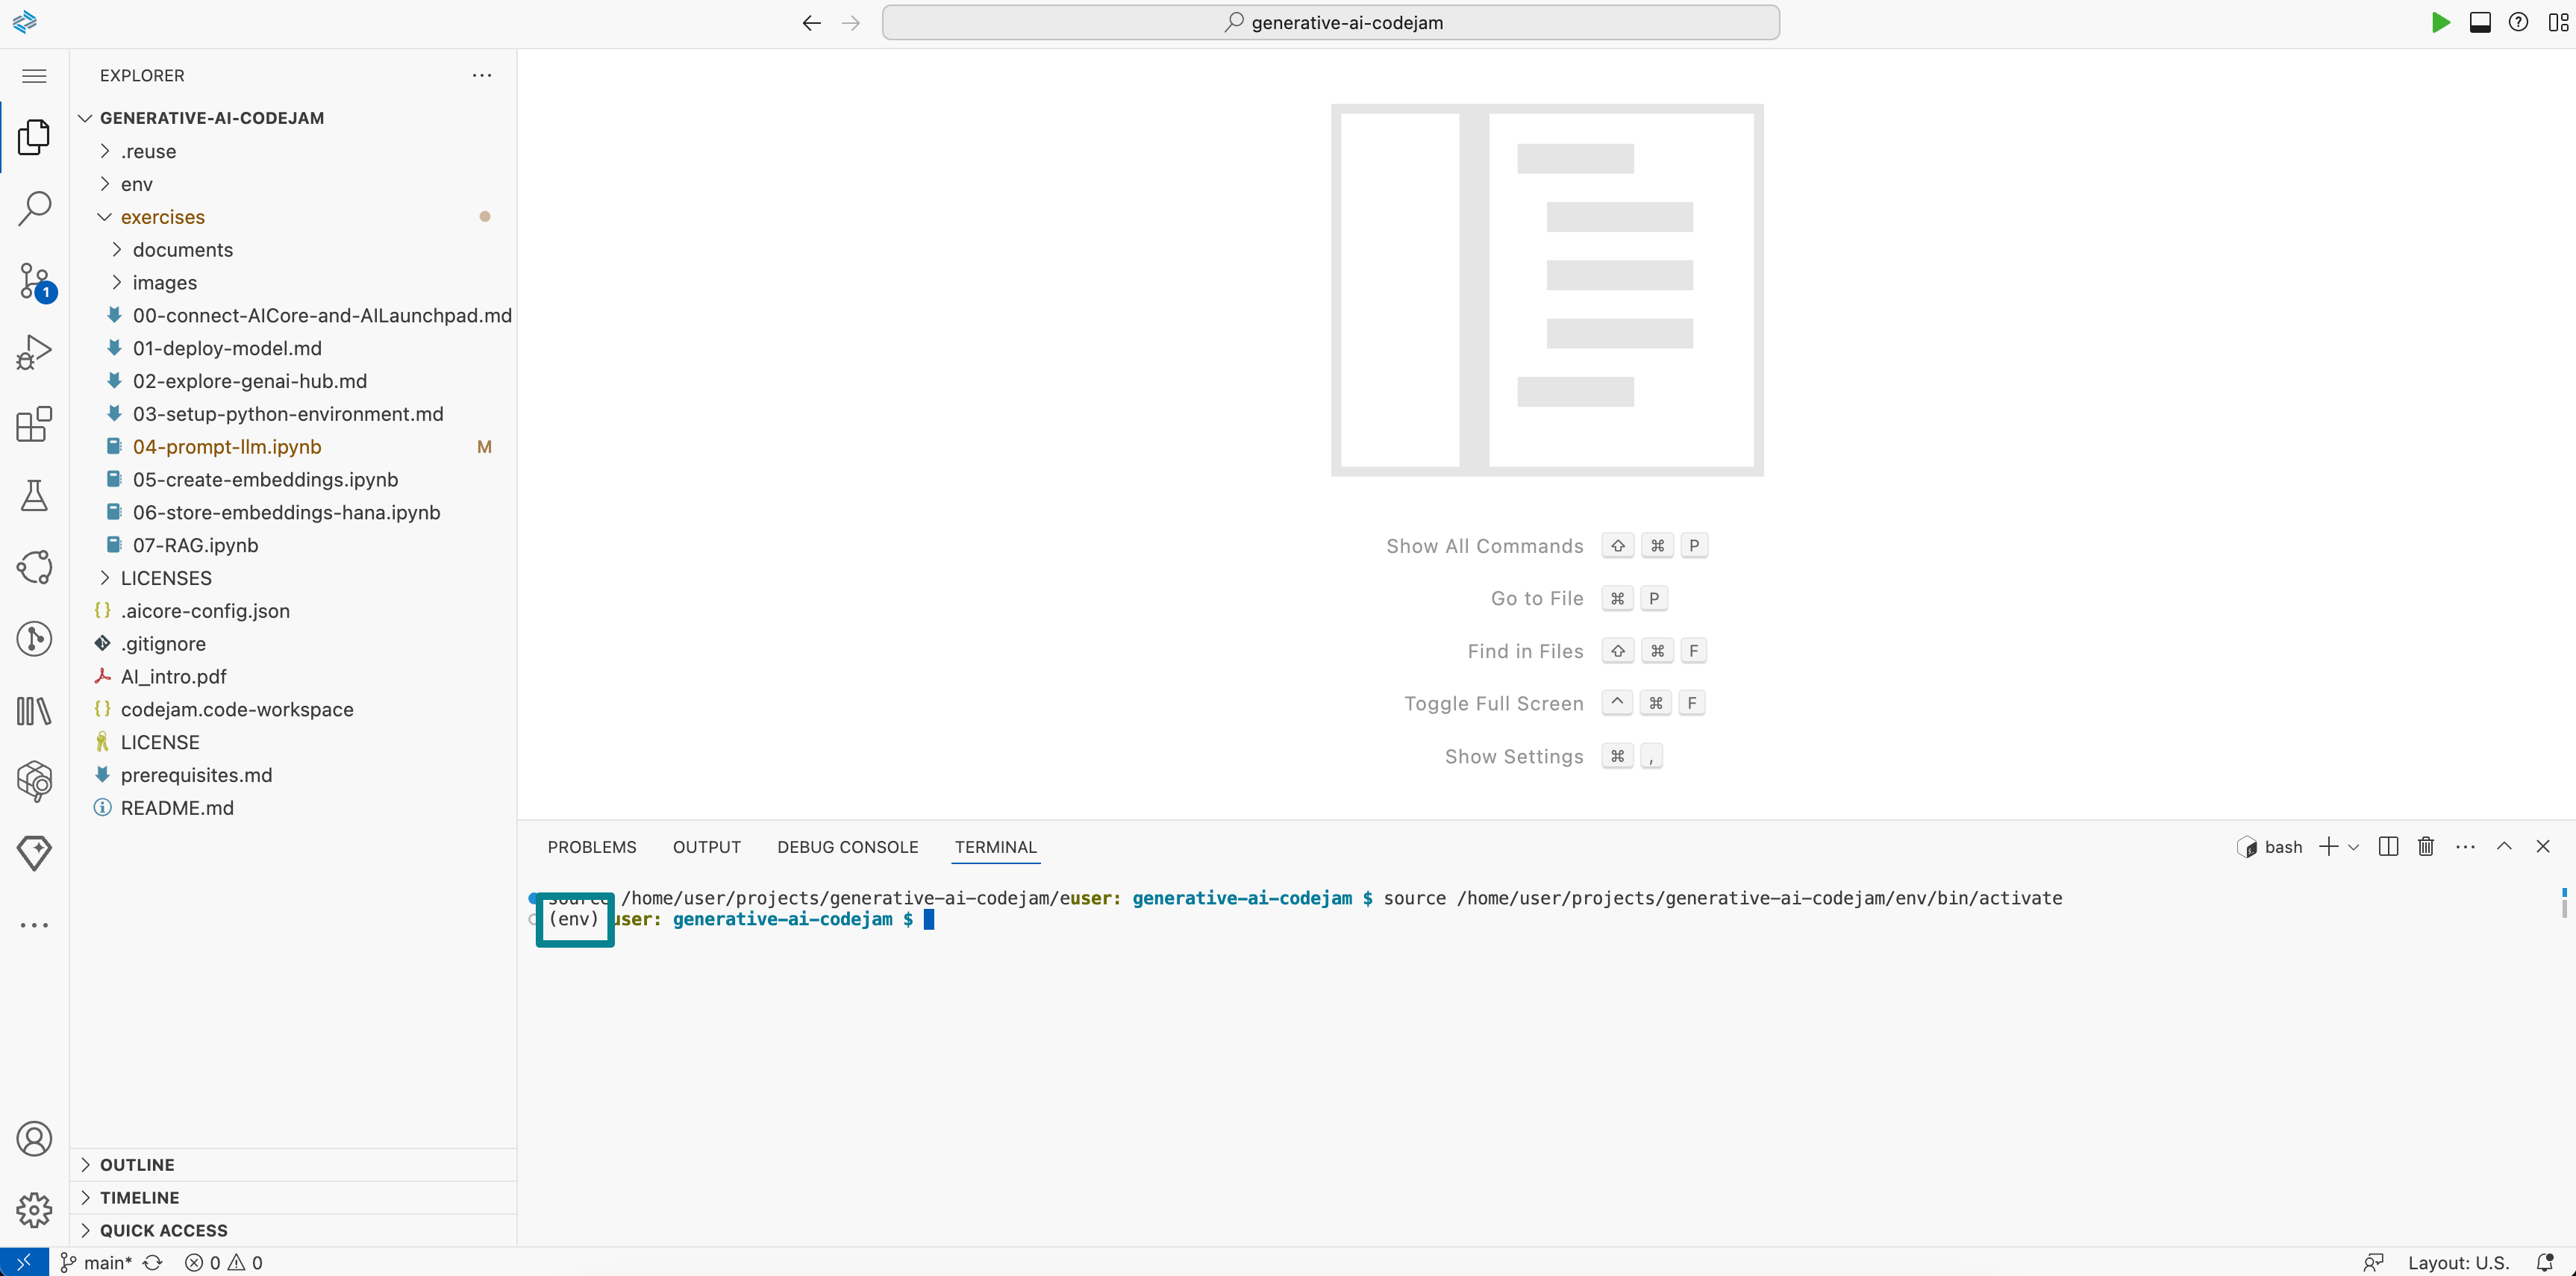
👉 用下面的 pip install 命令安装 Generative AI Hub 的 Python SDK(以及下面列出的其他包)。
pip install --require-virtualenv -U generative-ai-hub-sdk[all]
👉 我们还需要 HANA client for Python。
pip install --require-virtualenv -U hdbcli
👉 我们还需要 SciPy 包。
pip install --require-virtualenv scipy
pip install --require-virtualenv pypdf wikipedia
从现在开始,练习都在 BAS 中继续。
在 SAP AI Core 上部署 orchestration service
要使用 orchestration service,你需要创建一个部署 configuration。用该 configuration 就可以部署 orchestration service。部署成功后,你会得到一个部署 URL,可以用它通过 orchestration service 查询你想要的模型。
☝️ 有些人一开始就已经创建了 orchestration 部署。请到 SAP AI Launchpad 的 Deployments 下找到你的部署 URL。
创建 configuration,在 SAP AI Core 上部署 orchestration service
👉 打开 ML Operations 标签页,点击 Configurations。
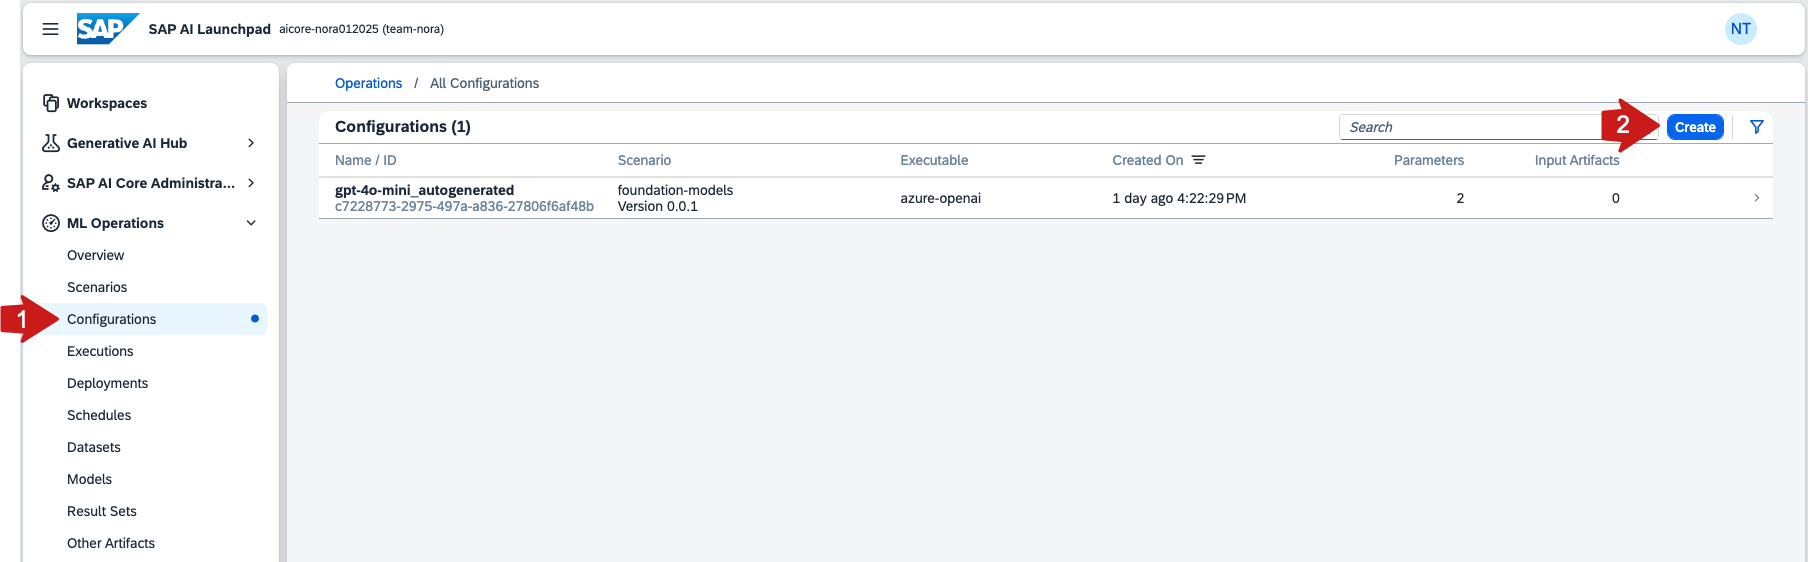
👉 Create 一个新的 configuration。
👉 输入 configuration 名称 orchestration-conf,选择 orchestration 场景、版本以及可执行项 orchestration。
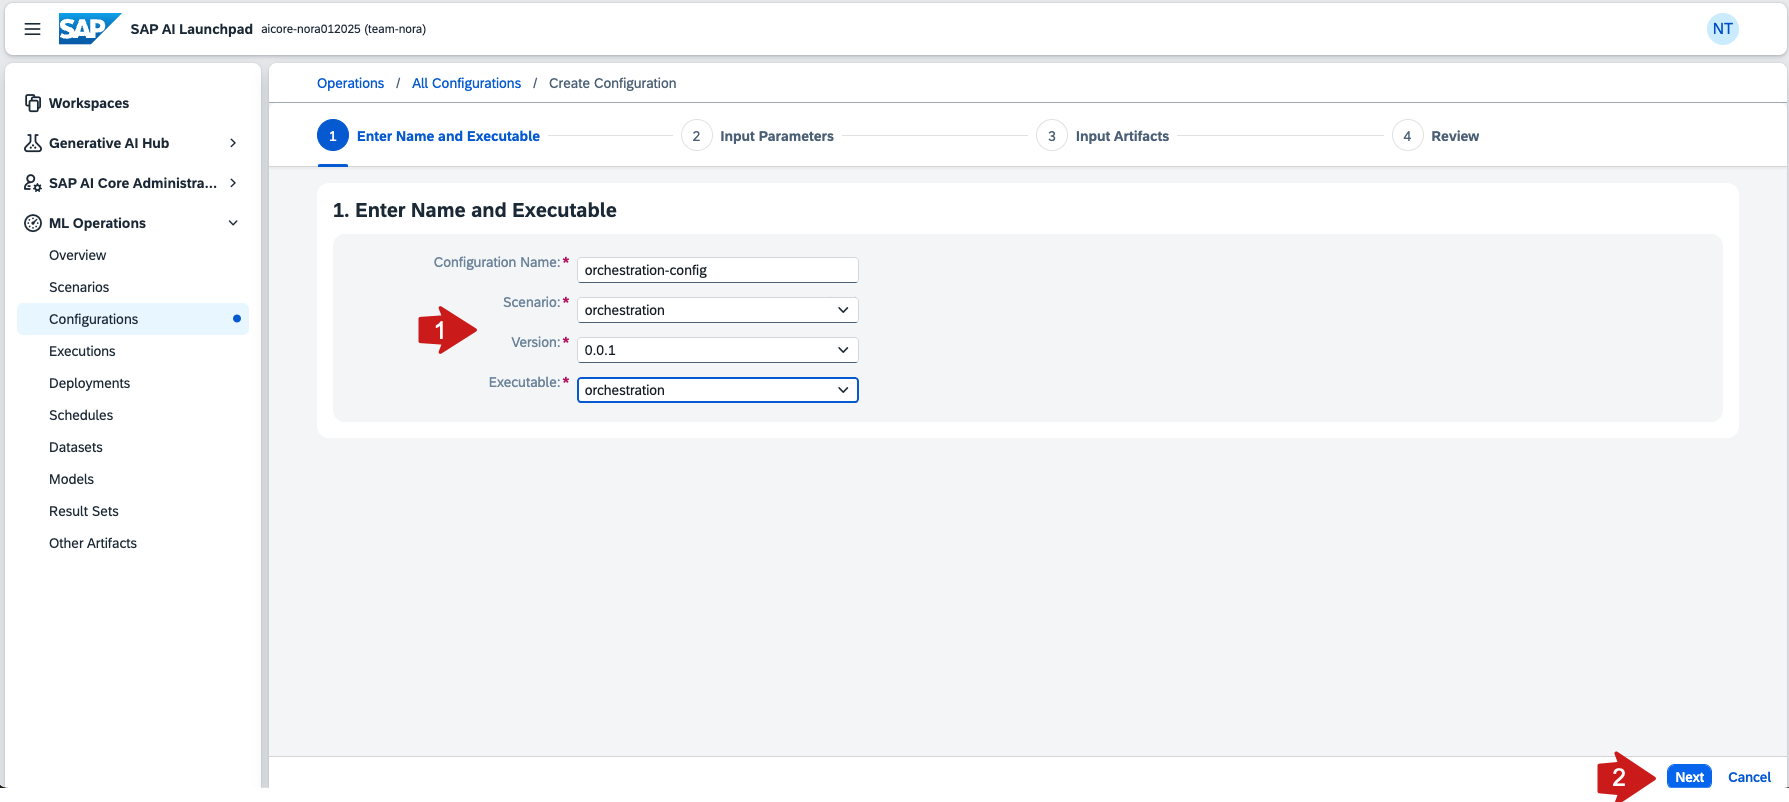
👉 依次点击 Next、Next、Review 与 Create。
在 SAP AI Core 上为大语言模型部署 proxy
👉 点击 Create Deployment 为该 configuration 创建部署。
这并不会真正部署所有模型,而是部署一个 proxy,它返回一个 URL,供你通过 orchestration service 查询模型。
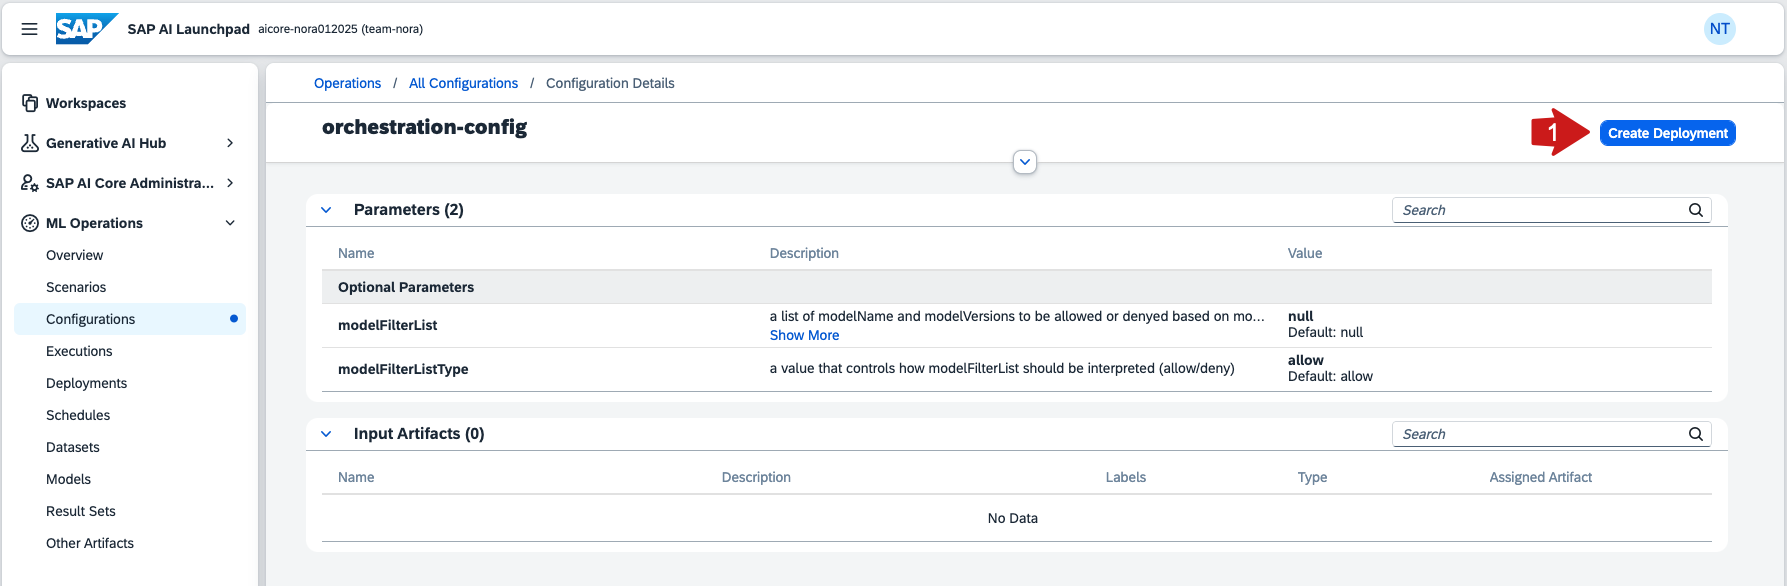
👉 点击 Review 与 Create。
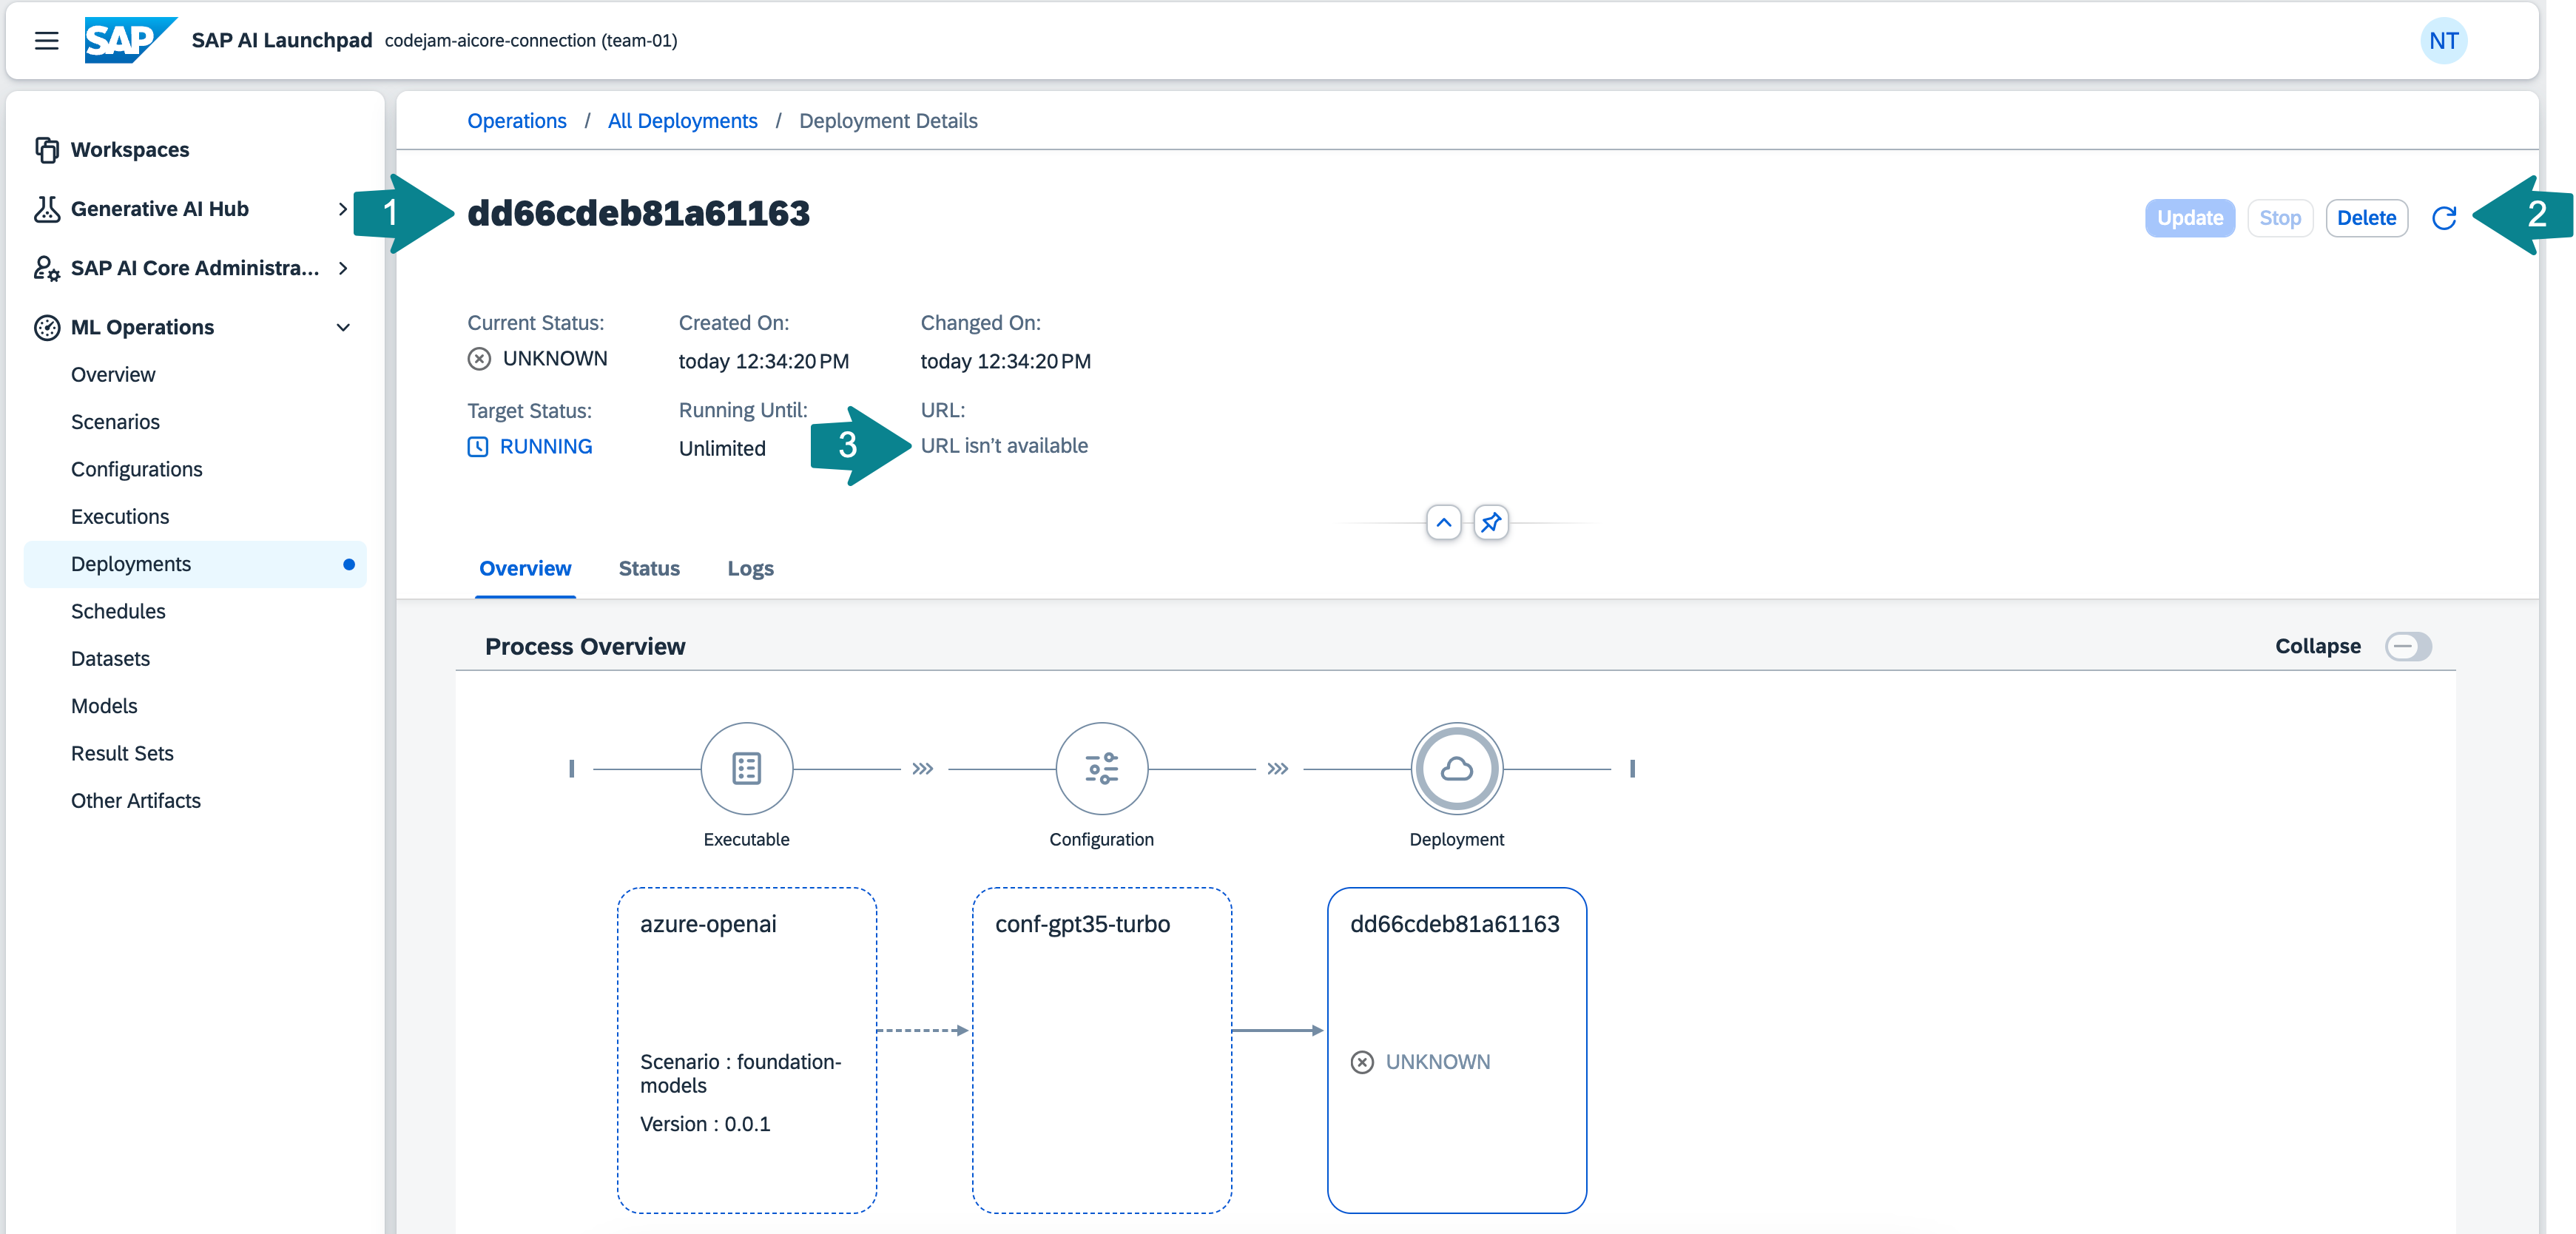
部署状态会从 UNKNOWN 变为 PENDING,然后变为 RUNNING。
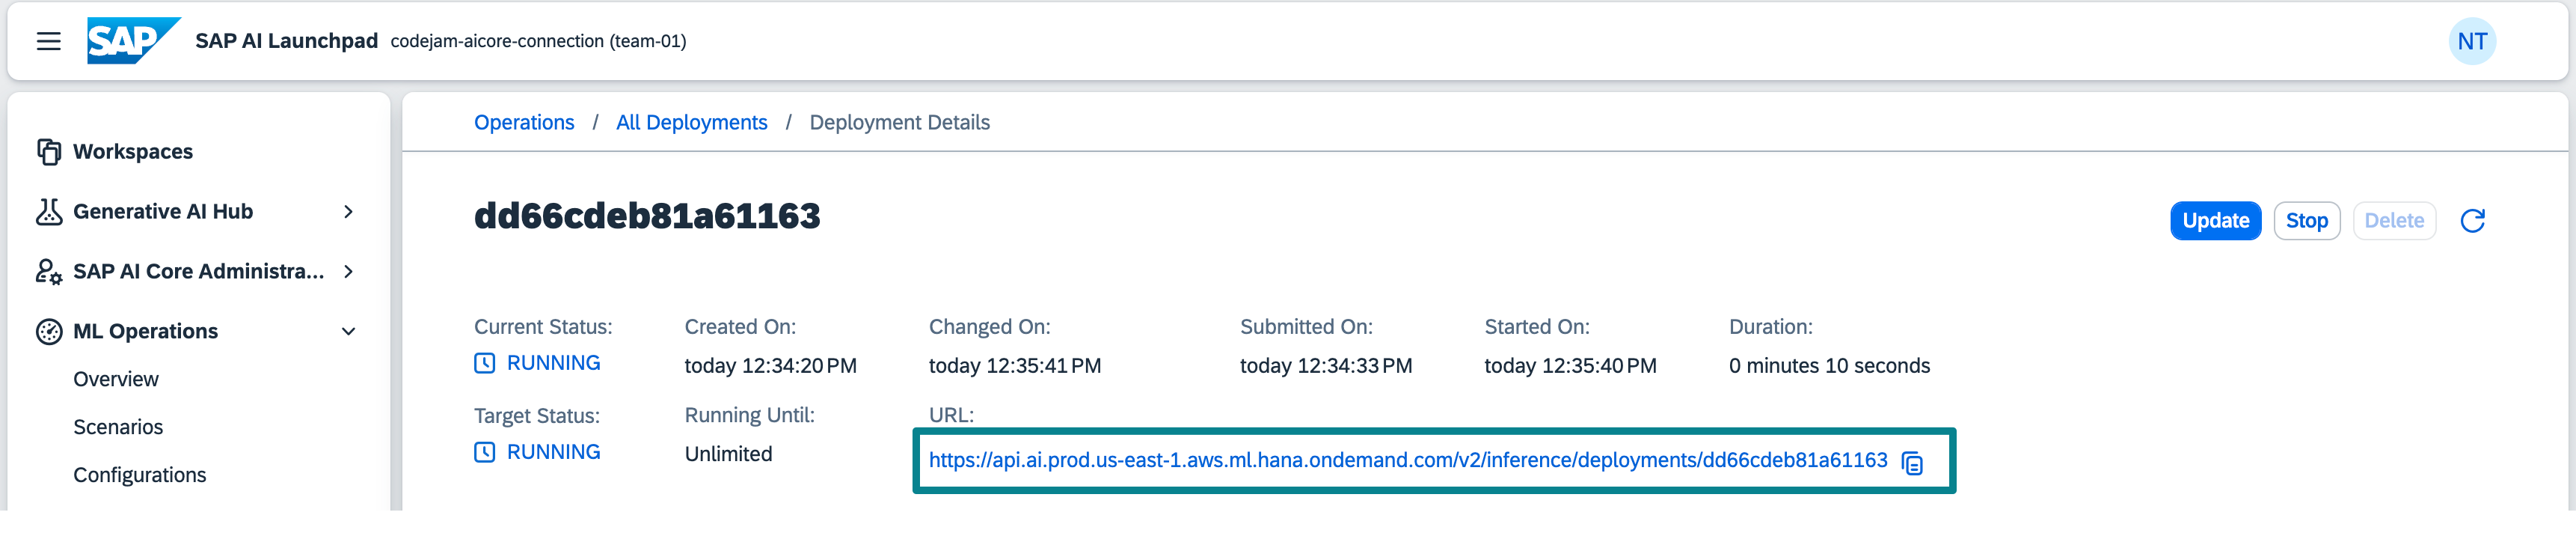
部署运行起来后,你会得到一个用于查询 orchestration service 的 URL。等待几分钟,然后点击页面上的刷新图标,URL 就会出现。
☝️ 下一个练习中你会用到这个部署 URL!
在 Deployments 下可以看到所有已部署的模型及其状态。
使用 SAP AI Core 服务密钥中的 URL、client ID 与 client secret,你现在可以用任意编程语言或 API 平台查询模型。
小结
到这里,你已经了解 Generative AI Hub 提供哪些模型,以及如何在 SAP AI Launchpad 中部署 orchestration service。
延伸阅读
搭建 SAP AI Launchpad 与 SAP AI Core
SAP AI Launchpad 是 SAP BTP 上的多租户 SaaS 应用。你可以用 SAP AI Launchpad 管理跨不同 AI 运行时的 AI 用例。SAP AI Launchpad 还通过 SAP AI Core 中的 Generative AI Hub 提供生成式 AI 能力,并在 Cloud Foundry 环境中可用。你也可以把 SAP HANA 数据库作为 AI 运行时接入,以使用 HANA 预测分析库(PAL),或接入 SAP AI Services 以使用 SAP AI Service 中的 Data Attribute Recommendation。
[1/4] 打开 SAP Business Technology Platform
👉 打开你的 BTP cockpit。
👉 导航到子账户:GenAI CodeJam。
[2/4] 打开 SAP AI Launchpad 并连接 SAP AI Core
👉 进入 Instances and Subscriptions,查看是否存在 SAP AI Core 实例与 SAP AI Launchpad 订阅。
借助 SAP AI Launchpad,你可以管理全部机器学习操作。☝️ 请确保你使用 SAP AI Core 的扩展计划(extended plan),以便使用 Generative AI Hub。要把 SAP AI Core 连接到 SAP AI Launchpad,需要 SAP AI Core 服务密钥。
☝️ 在该子账户中,SAP AI Core 服务实例与 SAP AI Launchpad 应用之间的连接已经建立。否则你需要用 SAP AI Core 服务密钥信息新增一个运行时。
👉 打开 SAP AI Launchpad。
[3/4] 为你的团队创建新的 resource group
SAP AI Core 租户使用 resource group 来隔离 AI 资源与工作负载。场景(例如 foundation-models)
与可执行项(训练模型或创建部署时用的模板)在所有 resource group 之间共享。
请务必为你的团队创建一个新的 resource group。 不要使用默认的 resource group!
👉 打开 SAP AI Core Administration 标签页,选择 Resource Groups。
👉 Create 一个新的 resource group,名称用你团队的名字。
👉 返回 Workspaces。
👉 选择你的连接与 resource group。
👉 确认它已被选中。它应显示在页面顶部 SAP AI Launchpad 旁边。
☝️ 在 Exercise 04-create-embeddings 中你会用到 resource group 的名称。
如果 resource group 没有显示出来,请使用**浏览器(!)**的刷新按钮刷新页面。
下一个练习
在 SAP AI Launchpad 中探索 Generative AI Hub
要在应用中使用大语言模型(LLM)或 foundation model,可以使用 SAP AI Core 上的 Generative AI Hub。与大多数 LLM 应用一样,Generative AI Hub 按使用量计费。
Generative AI Hub 提供市场上的所有主流模型。其中既有 SAP 自行部署的开源模型(例如 Falcon 模型),也有 SAP 作为代理提供的模型,例如 GPT 系列模型、Google 模型、Amazon Bedrock 提供的模型等等。你可以在它们之间轻松切换、对比结果,并选出最适合你用例的模型。
SAP 与 LLM 提供方签订了严格的数据隐私协议,确保你的数据安全。
要开始使用 Generative AI Hub 中的某个可用模型,你需要先部署它。你可以部署一个 orchestration service,然后通过它访问所有可用模型;也可以通过 Model Library 直接部署单个模型。你可以用 Python SDK、SAP Cloud SDK for AI(JavaScript SDK)、任意编程语言或 API 平台,或者 SAP AI Launchpad 的用户界面访问已部署的模型。SAP AI Launchpad 提供 Model Library、Chat 界面与 Prompt Editor,在 Prompt Editor 中还可以保存 prompt 与模型回答。
通过 Model Library 部署 proxy
👉 打开 Generative AI Hub 标签页,选择 Model Library。
👉 点击 GPT-4o Mini,这是一个文本生成模型,也能处理图片。
👉 点击 Deploy 一次,即可让模型端点对你可用。部署需要一分钟左右。
👉 你可以通过点击 ML Operations>Deployments 查看模型的部署状态。
👉 点击 Use in Chat 打开聊天界面,开始与模型交互。
☝️ 如果你的模型尚未部署,Chat 窗口会提示你启用 orchestration service。启用后你就可以与所有模型对话。如果你现在部署 orchestration service,在 07-deploy-orchestration-service.md 练习中就不必再部署一次了。
如果你的模型已部署,聊天界面会是这样:
使用 Generative AI Hub 中的 Chat
👉 如果你关掉了之前的聊天窗口,随时可以打开 Generative AI Hub 标签页并选择 Chat。
👉 点击 Configure,查看可用的字段。
在 Selected Model 下你可以看到所有已部署的模型。如果没有部署,这里为空,你也无法聊天。如果你部署了多个大语言模型,可以在这里选择要使用哪一个。
Frequency Penalty 参数用于惩罚在文本中出现过于频繁的词,帮助模型听起来不那么机械。
同样,Presence Penalty 越高,模型越有可能引入新话题,因为它会惩罚文本中已经出现过的词。
Max Tokens 参数用于设置模型输入与输出的规模。token 不是单个单词,通常长约 4-5 个字符。
Temperature 参数用于控制模型的创造性,决定它在选择序列中下一个 token 时的灵活程度。
在 Chat Context 标签页中,Context History 正下方可以设置发送给模型的消息条数,即每次新请求要提供多少聊天历史作为上下文。这基本上就是模型的记忆容量。
你还可以添加 System Message 来描述角色,或补充关于期望模型做什么的更多信息。此外,你还可以提供示例输入与输出。
Prompt Engineering
👉 参照下面的例子尝试不同的 prompt engineering 技巧:
Zero shot:
The capital of the U.S. is:
Few shot:
Germany - Berlin
India - New Delhi
France -
Chain of thought(把整段内容复制到聊天窗口):
1. What is the most important city of a country?
2. In which country was the hot air balloon originally developed?
3. What is the >fill in the word from step 1< of the country >fill in the word from step 2<.
👉 试着在 System Message 中加点有趣的内容,例如「always respond like a pirate」,然后再次尝试这些 prompt。你也可以要求它用更技术化的口吻(像开发者),或更精美的口吻(像营销文案)。
👉 让模型统计单词中的字母。例如字母 r 在 strawberry 中出现了几次。你能设计出一个能正确统计的 prompt 吗?
👉 在进入下一个练习之前,请确保也部署了
Text Embedding 3 Small模型,后面会用到!点击一次 deploy 按钮即可,之后可以在ML Operations>Deployments中看到你的部署。
使用 Generative AI Hub 中的 Prompt Editor
如果你想保存 prompt 及其回答以便日后回看或对比 prompt,Prompt Editor 会很有用。你常常会发现有些任务可以定期交给 LLM 处理。这种情况下,你还可以保存多个效果不错的 prompt 版本,省去每次重新编写的工作。
在 Chat 中能设置的参数在这里同样可以设置。此外,你还可以在回答下方查看 prompt 使用了多少 token。
👉 转到 Prompt Editor,选择模型,并把 Max Tokens 再次设置为最大值
👉 粘贴下面的示例,点击 Run 试用该示例。
👉 为你的 prompt 填写 Name、Collection 名称,然后保存该 prompt。
👉 如果你现在进入 Prompt Management,就能找到之前保存的 prompt。要再次运行该 prompt,点击 Open in Prompt Editor。你也可以点击 Select 选择其他已保存的 prompt。
Chain of thought prompt - 客户支持(把整段内容复制到 prompt editor):
You are working at a big tech company and you are part of the support team.
You are tasked with sorting the incoming support requests into: German, English, Polish or French.

Review the incoming query.
Identify the language of the query as either German, English, Polish, or French.
- Example: 'bad usability. very confusing user interface.' - English
Count the number of queries for each language: German, English, Polish, and French.
Summarize the key pain points mentioned in the queries in bullet points in English.

Queries:
- What are the shipping costs to Australia?
- Kann ich einen Artikel ohne Kassenbon umtauschen?
- Offrez-vous des réductions pour les achats en gros?
- Can I change the delivery address after placing the order?
- Comment puis-je annuler mon abonnement?
- Wo kann ich den Status meiner Reparatur einsehen?
- What payment methods do you accept?
- Czemu to tak długo ma iść do Wrocławia, gdy cena nie jest wcale niska?
- Quel est le délai de livraison estimé pour le Mexique?
- Gibt es eine Garantie auf elektronische Geräte?
- I’m having trouble logging into my account, what should I do?
👉 如果还有时间,可以让 LLM 再生成一些不同的支持请求,以增加数据量。
小结
到这里,你已经会使用 SAP AI Launchpad 中的 Generative AI Hub 用户界面查询 LLM 并保存重要的 prompt。你也会理解如何用 prompt engineering 技巧优化大语言模型的输出。
延伸阅读
下一个练习
搭建 SAP Business Application Studio 与 dev space
SAP Business Application Studio 基于 Code-OSS,这是用于构建 Visual Studio Code 的开源项目。SAP Business Application Studio 以云服务形式提供,具备与主流 IDE 类似的桌面级体验,配有命令行与优化过的编辑器。
SAP Business Application Studio 的核心是 dev space。dev space 相当于云端的隔离虚拟机,按业务场景预置了定制工具与运行时,例如 SAP Fiori、SAP S/4HANA 扩展、Workflow、Mobile 等。这简化并加速了开发环境的搭建,让你能高效地在本地或云端开发、测试、构建并运行解决方案。
打开 SAP Business Application Studio
👉 返回你的 BTP cockpit。
👉 导航到 Instances and Subscriptions,打开 SAP Business Application Studio。
为 CodeJam 练习创建新的 Dev Space
👉 创建一个新的 Dev Space。
👉 输入 Dev space 名称 GenAICodeJam,在 Additional SAP Extensions 中选择 Basic 类型的应用与 Python Tools。
👉 点击 Create Dev Space。
你应该会看到该 dev space 处于 STARTING 状态。
👉 等待 dev space 进入 RUNNING 状态,然后打开它。
从 Git 仓库克隆练习
👉 在 BAS 中打开 dev space 后,用下面 URL 通过任一可用方式克隆这个包含练习的 Git 仓库:
https://github.com/SAP-samples/generative-ai-codejam.git
👉 点击 Open,在 Explorer 视图中打开项目。
打开工作区
克隆下来的仓库中包含 codejam.code-workspace 文件,因此系统会询问你是否打开它。
👉 点击 Open Workspace。
☝️ 如果你错过了上一个对话框,可以进入 BAS 的 Explorer,打开 codejam.code-workspace 文件,再点击 Open Workspace。
你应该会看到:
项目层级根部的
CODEJAM工作区,以及顶层文件夹名
generative-ai-codejam。
👉 你可以关闭 Get Started 标签页。
配置到 Generative AI Hub 的连接
👉 返回你的 BTP cockpit。
👉 导航到 Instances and Subscriptions,打开 SAP AI Core 实例的服务绑定(service binding)。
👉 点击 Copy JSON。
👉 回到 BAS,在 generative-ai-codejam/ 目录下新建文件 .aicore-config.json。
👉 把服务密钥粘贴到 generative-ai-codejam/.aicore-config.json,内容大致如下。
{
  "appname": "7ce41b4e-e483-4fc8-8de4-0eee29142e43!b505946|aicore!b540",
  "clientid": "sb-7ce41b4e-e483-4fc8-8de4-0eee29142e43!b505946|aicore!b540",
  "clientsecret": "...",
  "identityzone": "genai-codejam-luyq1wkg",
  "identityzoneid": "a5a420d8-58c6-4820-ab11-90c7145da589",
  "serviceurls": {
    "AI_API_URL": "https://api.ai.prod.eu-central-1.aws.ml.hana.ondemand.com"
  },
  "url": "https://genai-codejam-luyq1wkg.authentication.eu10.hana.ondemand.com"
}
创建 Python 虚拟环境并安装 SAP 的 Python SDK for Generative AI Hub
👉 打开一个新的终端。
👉 用下面的命令创建虚拟环境:
python3 -m venv ~/projects/generative-ai-codejam/env --upgrade-deps
👉 像这样激活 env 虚拟环境,并确认它已激活:
source ~/projects/generative-ai-codejam/env/bin/activate
👉 用下面的 pip install 命令安装 Generative AI Hub 的 Python SDK(以及下面列出的其他包)。
pip install --require-virtualenv -U generative-ai-hub-sdk[all]
👉 我们还需要 HANA client for Python。
pip install --require-virtualenv -U hdbcli
👉 我们还需要 SciPy 包。
pip install --require-virtualenv scipy
pip install --require-virtualenv pypdf wikipedia
从现在开始,练习都在 BAS 中继续。
在 SAP AI Core 上部署 orchestration service
要使用 orchestration service,你需要创建一个部署 configuration。用该 configuration 就可以部署 orchestration service。部署成功后,你会得到一个部署 URL,可以用它通过 orchestration service 查询你想要的模型。
☝️ 有些人一开始就已经创建了 orchestration 部署。请到 SAP AI Launchpad 的 Deployments 下找到你的部署 URL。
创建 configuration,在 SAP AI Core 上部署 orchestration service
👉 打开 ML Operations 标签页,点击 Configurations。
👉 Create 一个新的 configuration。
👉 输入 configuration 名称 orchestration-conf,选择 orchestration 场景、版本以及可执行项 orchestration。
👉 依次点击 Next、Next、Review 与 Create。
在 SAP AI Core 上为大语言模型部署 proxy
👉 点击 Create Deployment 为该 configuration 创建部署。
这并不会真正部署所有模型,而是部署一个 proxy,它返回一个 URL,供你通过 orchestration service 查询模型。
👉 点击 Review 与 Create。
部署状态会从 UNKNOWN 变为 PENDING,然后变为 RUNNING。
部署运行起来后,你会得到一个用于查询 orchestration service 的 URL。等待几分钟,然后点击页面上的刷新图标,URL 就会出现。
☝️ 下一个练习中你会用到这个部署 URL!
在 Deployments 下可以看到所有已部署的模型及其状态。
使用 SAP AI Core 服务密钥中的 URL、client ID 与 client secret,你现在可以用任意编程语言或 API 平台查询模型。
小结
到这里,你已经了解 Generative AI Hub 提供哪些模型,以及如何在 SAP AI Launchpad 中部署 orchestration service。
延伸阅读
在 SAP Generative AI Hub 中用 prompt 与 LLM 解决业务问题
这个 仓库 是为特定赋能内容准备的示例:“Solving your business problems using prompts and LLMs in SAP Generative AI Hub”。
请在执行 notebook 之前下载整个仓库。 这也会同时下载 notebook 所需的数据集。 请确保把你从 BTP 下载的 ai-core service key(即 <key.json> 或你所命名的其他名字)的 json 文件放在你下载仓库的同一路径下,并把名字从 <key.json> 改为 config.json 并确保该 config.json 位于下载仓库中的 10_learning_journeys 文件夹内
文件
company-scope.md:一家虚构公司的简要说明service-categories.md:服务类别说明bootstrap_mails.py:生成支持邮件的脚本draft-mail.yaml:用于起草支持邮件的 promptevaluation.yaml:用于评估草稿邮件质量的 prompt
company-scope
公司名称:Facility Solutions Company
**说明:**Facility Solutions Company 是一家为住宅与商业物业提供综合设施管理、维护与清洁服务的领先供应商。我们的使命是让你的环境保持安全、高效、维护得当,使你能够专注于核心业务,不必为设施维护操心。
提供的服务:
设施管理
对所有设施运营进行全面监督与管理。
协调空间使用、安全与可持续性相关工作。
落实能效提升与减少环境影响的最佳实践。
维护服务
对建筑系统(包括 HVAC、给排水与电气)进行例行与预防性维护。
提供紧急维修服务,快速有效地处理突发问题。
按你设施的特定需求量身定制维护计划。
清洁服务
提供每日、每周与每月的清洁排班,保证环境整洁。
提供专项清洁服务,包括深度清洁、擦窗与地毯养护。
使用环保清洁产品与做法,营造健康的居住与工作环境。
培训与支持
提供设施管理最佳实践的综合培训项目。
支持建设内部维护团队与清洁人员队伍。
提供专属支持团队,持续提供指导与问题排查。
目标市场:
住宅物业: 豪华公寓、住宅小区与独立住宅。
商业物业: 办公楼、零售场所、工业设施与教育机构。
为什么选择 Facility Solutions Company?
专业能力与经验: 我们的专业团队在设施管理与维护方面拥有多年经验,确保提供一流的服务。
定制化方案: 我们按每位客户的独特需求定制服务,提供灵活且可扩展的方案。
对质量的承诺: 我们遵循最高的质量与安全标准,采用最新技术与做法交付卓越成果。
关注可持续性: 我们优先采用环保做法,帮助客户减少碳足迹、推动可持续发展。
在 Facility Solutions Company,我们深知设施维护得当的重要性。把细节交给我们,你就能享有干净、安全、高效的环境。
service-categories
一般咨询
关于服务、价格与公司信息的问题。
咨询或服务报价请求。
设施管理问题
空间使用协调。
安全与可持续性方面的顾虑。
能效与环影响相关的询问。
例行维护请求
HVAC、给排水与电气系统的计划性维护。
预防性维护规划。
紧急维修服务
针对突发问题的立即维修需求。
紧急维护请求。
清洁服务排期
安排每日、每周或每月的清洁排班。
一次性深度清洁、擦窗或地毯养护的请求。
专项清洁服务
关于环保清洁产品与做法的询问。
专项清洁服务请求。
培训与支持请求
报名参加设施管理培训项目。
为内部维护与清洁人员的发展提供支持。
获取持续指导与问题排查支持。
质量与安全顾虑
反馈与服务质量相关的问题。
安全顾虑与标准合规性。
可持续性与环保做法
关于环保做法与产品的询问。
减少碳足迹、推动可持续发展的支持。
客户反馈与投诉
提交对所获服务的反馈。
提出需要解决的投诉或问题。
urgency-description
High(高):
因安全顾虑或直接影响发件人健康与运营的关键问题而要求立即处理的请求。
构成健康风险、扰乱工作环境或影响基本服务的问题。
对发件人日常活动或专业工作至关重要的紧急维修或服务请求。
表达出沮丧、不耐烦或希望尽快解决问题的表述。
Medium(中):
例行维护请求或小问题,无需立即处理,但应及时跟进以防升级。
计划性维护上门请求,或关于重要但不紧急的服务询问。
可能影响发件人环境效率或舒适度,但不影响日常运营的问题。
表达出希望在一段合理时间内(通常一周左右)得到关注的表述。
Low(低):
关于服务、产品或一般信息的询问,无需立即处理。
为将来方便而安排常规服务或制定维护计划的请求。
对改进的反馈或建议,不具时效性。
语气轻松、不急迫,无需立即解决的表述。
使用 SAP Generative AI Hub 的高级 AI 技术
这个 仓库 是为特定赋能内容准备的示例:“Using Advanced AI techniques with SAP's Generative AI Hub”。
**请在执行 notebook 之前下载整个仓库。
这也会同时下载 notebook 所需的数据集。 请确保把你从 BTP 下载的 ai-core service key(即 <key.json> 或你所命名的其他名字)的 json 文件放在你下载仓库的同一路径下,并把名字从 <key.json> 改为 config.json 并确保该 config.json 位于下载仓库中的 10_learning_journeys 文件夹内**
文件
using_advanced_ai_techniques_with_sap_generative_ai_hub.ipynb- 用于 grounding 的 Jupyter notebookPrompt for emails generation.docx:该文件包含生成邮件所用的 prompt 以及生成的邮件。生成的邮件可用于创建 grounding 数据仓库。customer_emails_for_grounding- 该文件夹包含 grounding 所需的邮件文件。你可以把这些邮件文件上传到支持的数据仓库,并运行数据管道以生成 embedding 并把数据存入向量数据库。
Grounding 前置条件:
在运行 notebook 之前,你需要用相关文档创建 knowledge base。
使用 Prompt for emails generation.docx 文件中生成的邮件,通过 vector API 提供文档分块(chunks),并创建 grounding 所需的数据仓库。
详细步骤请参考 这篇文档。
Readme
请在执行 notebook 之前下载整个仓库。这也会同时下载 notebook 所需的数据集。请确保把你从 BTP 下载的 ai-core service key(即 <key.json>)的 json 文件放在你下载仓库的同一路径下,并把名字从 <key.json> 改为 config.json。并确保该 config.json 位于下载仓库中的 Orchestration 文件夹内