使用函数和正则表达式处理字符串
学习目标
描述 ABAP 中的内置字符串函数。
使用 ABAP 中的内置字符串函数。
介绍 ABAP 中正则表达式的使用。
内置字符串函数
除了使用 && 运算符进行字符串连接以及使用字符串模板进行格式化外,ABAP 还提供了大量内置字符串函数。根据结果的类型,我们区分三种类别的字符串函数:
视频:本节含 SAP 官方视频(视频 ID
1_3pvgwuut),需在 learning.sap.com 在线观看。
注意
如果内置字符串函数的输入由多个参数组成,则主输入参数的名称始终为 val。
字符串函数的参数
对于某些内置字符串函数,输入只包含一个字符型数据对象。这些函数不使用输入参数。直接在括号中指定输入。描述函数 NUMOFCHAR() 是这些类型函数的一个很好的示例。
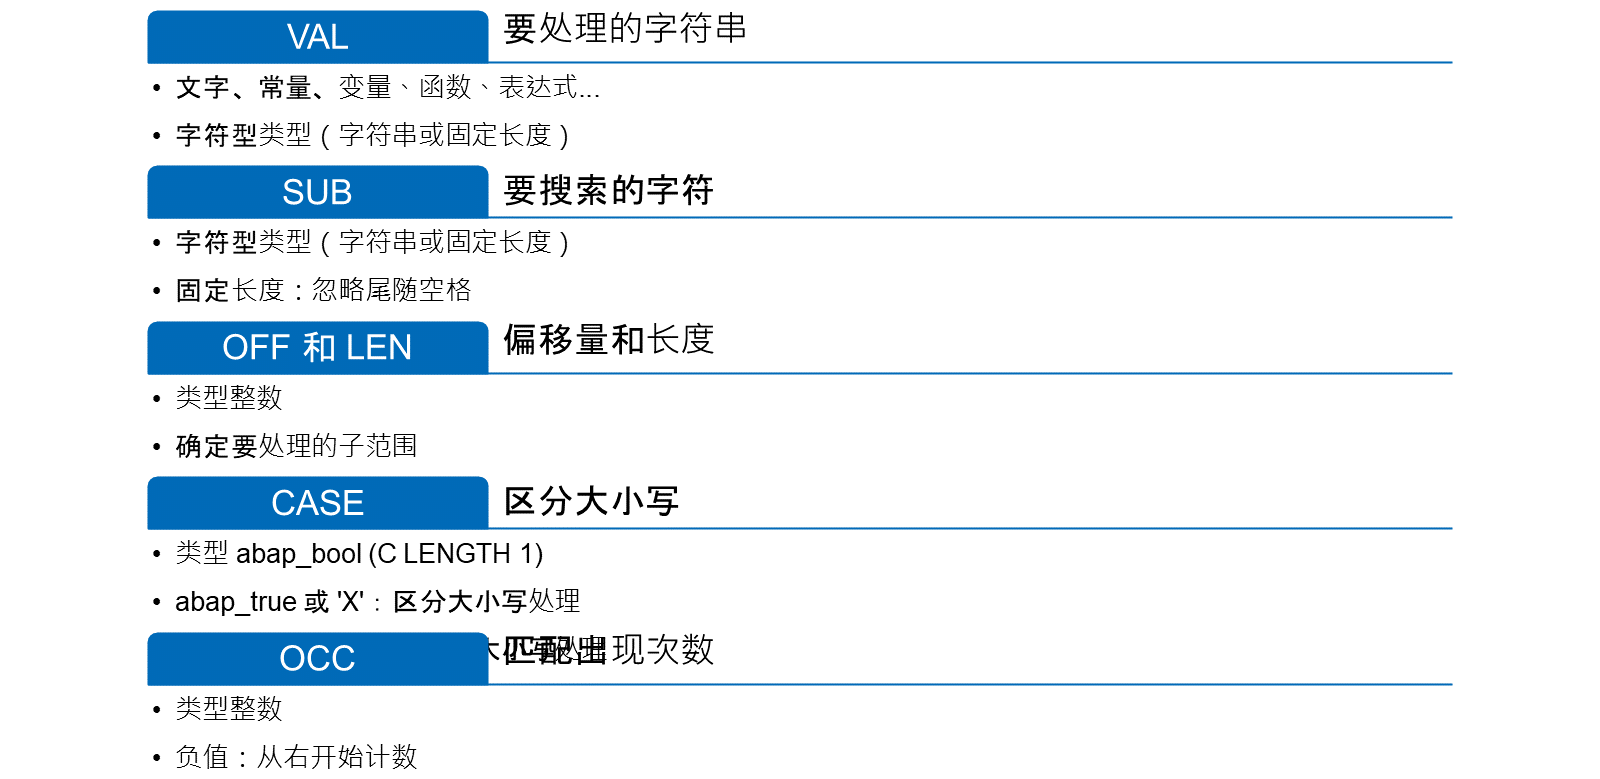
具有多个输入用途参数的函数(名称为 )并将输入分配给这些参数。许多参数是不同内置字符串函数之间的共同点。最重要的参数如下:
VAL
将要由 函数处理的文本字符串传递给 parameter val。您还可以指定返回值可转换为字符串类型的函数方法调用、表表达式和构造函数表达式。只能处理基本数据类型。如果指定了具有固定长度的字符型数据对象,则会忽略任何尾随空格。非字符型返回值将转换为字符串数据类型。
SUB
参数 sub 用于传递要搜索或插入其字符的字符串。只能指定具有基本类型的参数。如果指定了具有固定长度的字符型数据对象,则会忽略任何尾随空格。
CASE
缺省情况下,字符串函数中的搜索和比较区分大小写,但必要时可使用参数 case 将其覆盖。参数 case 需要具有常量 abap_true ('X') 或 abap_false (' ') 值的类型 abap_bool (C LENGTH 1) 的输入。如果 case 包含值 abap_true,则搜索区分大小写;如果其包含 abap_false 值,则不区分大小写。
OCC
在执行搜索的字符串函数中,参数 occ 指定匹配的出现。如果 occ 为正,则从左侧计算出现次数;如果 occ 为负,则从右侧开始计数。值 1、2、.... 指示第一个、第二个、...出现。值 -1、-2、.... 表示倒数第二次、...出现。occ 的缺省值为 1。
注意
除替换函数替换外,值 0 引发异常 CX_SY_STRG_PAR_VAL。如果使用 replace,则值 0 将替换出现的所有内容。
OFF 和 LEN
参数 off 用于传递偏移,参数 len 用于传递长度。在可以传递 off 和 len 的功能中,它们确定处理字符串的子范围。
off 的缺省值通常为 0, len 的缺省值设置为偏移后整个字符串的长度。
注意
不适当的值组合可能会导致异常 CX_SY_RANGE_OUT_OF_BOUNDS。
让我们看一些示例以查看这些参数的影响:
视频:本节含 SAP 官方视频(视频 ID
1_aejnm0dw),需在 learning.sap.com 在线观看。
试用:字符串函数的通用参数
创建实施接口 IF_OO_ADT_CLASSRUN 的新全局类。
将以下代码片段复制到方法 if_oo_adt_classrun~main() 的实施部分:
DATA text   TYPE string VALUE `  Let's talk about ABAP  `.
DATA result TYPE i.
out->write(  text ).
result = find( val = text sub = 'A' ).
*
*    result = find( val = text sub = 'A' case = abap_false ).
*
*    result = find( val = text sub = 'A' case = abap_false occ =  -1 ).
*    result = find( val = text sub = 'A' case = abap_false occ =  -2 ).
*    result = find( val = text sub = 'A' case = abap_false occ =   2 ).
*
*    result = find( val = text sub = 'A' case = abap_false occ = 2 off = 10 ).
*    result = find( val = text sub = 'A' case = abap_false occ = 2 off = 10 len = 4 ).
out->write( |RESULT = { result } | ).
选择 CTRL + F3 激活类,然后选择 F9 将其作为控制台应用执行。
分析控制台输出。
移除函数 FIND() 的不同调用前的注释,然后再次激活程序。
调试程序并在每次分配后分析数据对象 结果 的内容。你能理解不同的结果吗?
浏览不同的参数以熟悉其含义。
描述功能
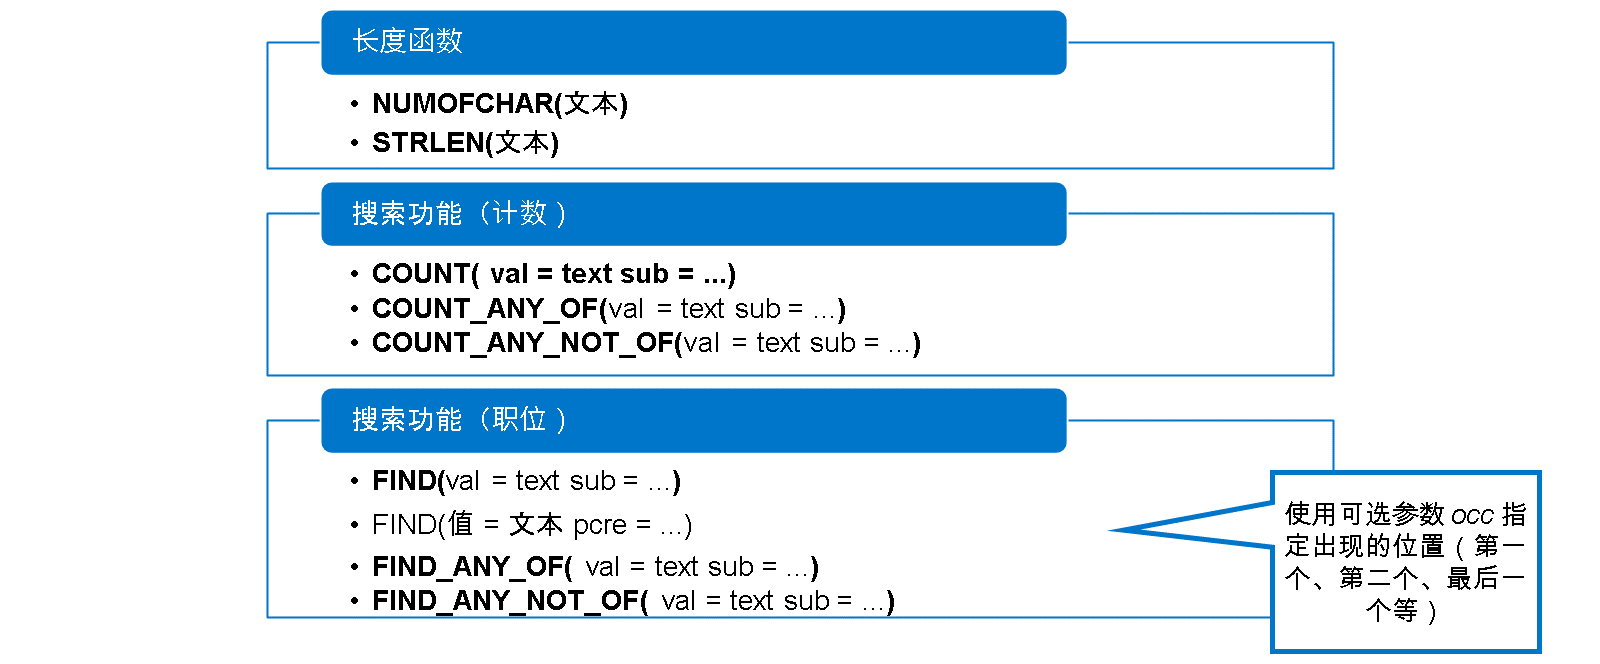
Length 函数
字符串的描述函数的一个重要组是长度函数 NUMOFCHAR( ) 和 STRLEN( )。大多数情况下,这两个函数返回相同的结果。但是,有一个例外:如果参数的类型为 string 并在末尾包含一个或多个空格,则 STRLEN() 的结果包括这些尾随空格,而 NUMOFCHAR( ) 忽略它们。对于长度固定的参数(例如 TYPE C 或 N 的参数),这两个函数都会忽略末尾的空格。
搜索功能组
有两组用于字符串的搜索函数:
函数 COUNT() 和以 COUNT_...() 开头的函数返回搜索参数的总出现次数。函数 FIND() 和以 FIND_() 开头的函数返回搜索参数一次特定出现的位置(偏移)。
搜索功能中的参数子
函数 COUNT() 和 FIND() 可以搜索子字符串(可选参数 sub)或正则表达式(可选参数 pcre)。我们稍后将在本课程中讨论正则表达式。
如果函数以 _ANY_OF 结尾,则参数 sub 的名称有点误解。在此,参数 sub 的值不是子字符串,而是字符列表。这些函数不是搜索子字符串(即确切的字符组合),而是评估各个字符,并考虑每个字符的匹配项,该匹配是所提供列表的一部分。以 _ANY_NOT_OF 结尾的函数的工作方式类似,但此处只会将那些与列表中所有字符不同的字符视为匹配。
观看描述函数的一些示例。
视频:本节含 SAP 官方视频(视频 ID
1_4ej15afx),需在 learning.sap.com 在线观看。
试用:描述功能
创建实施接口 IF_OO_ADT_CLASSRUN 的新全局类。
将以下代码片段复制到方法 if_oo_adt_classrun~main() 的实施部分:
DATA result TYPE i.
DATA text    TYPE string VALUE `  ABAP  `.
DATA substring TYPE string VALUE `AB`.
DATA offset    TYPE i      VALUE 1.
* Call different description functions
******************************************************************************
*    result = strlen(     text ).
*    result = numofchar(  text ).
result = count(             val = text sub = substring off = offset ).
*    result = find(             val = text sub = substring off = offset ).
*    result = count_any_of(     val = text sub = substring off = offset ).
*    result = find_any_of(      val = text sub = substring off = offset ).
*    result = count_any_not_of( val = text sub = substring off = offset ).
*    result = find_any_not_of(  val = text sub = substring off = offset ).
out->write( |Text      = `{ text }`| ).
out->write( |Substring = `{ substring }` | ).
out->write( |Offset    = { offset } | ).
out->write( |Result    = { result } | ).
选择 Ctrl + F3 激活类,然后选择 F9 将其作为控制台应用执行。
分析控制台输出。
移除变量 结果 的不同值分配前的注释,然后再次激活程序。
设置断点,并在每次分配后分析数据对象 结果 的内容。你能理解不同的结果吗?
围绕 文本和 子字符串 的起始值进行播放以熟悉函数。
处理功能
观看以下视频,了解有关处理功能的详细信息。
视频:本节含 SAP 官方视频(视频 ID
1_9py1qgjx),需在 learning.sap.com 在线观看。
提示
SEGMENT() 的一个良好用例是以逗号分隔值格式 (csv) 导入和处理数据。
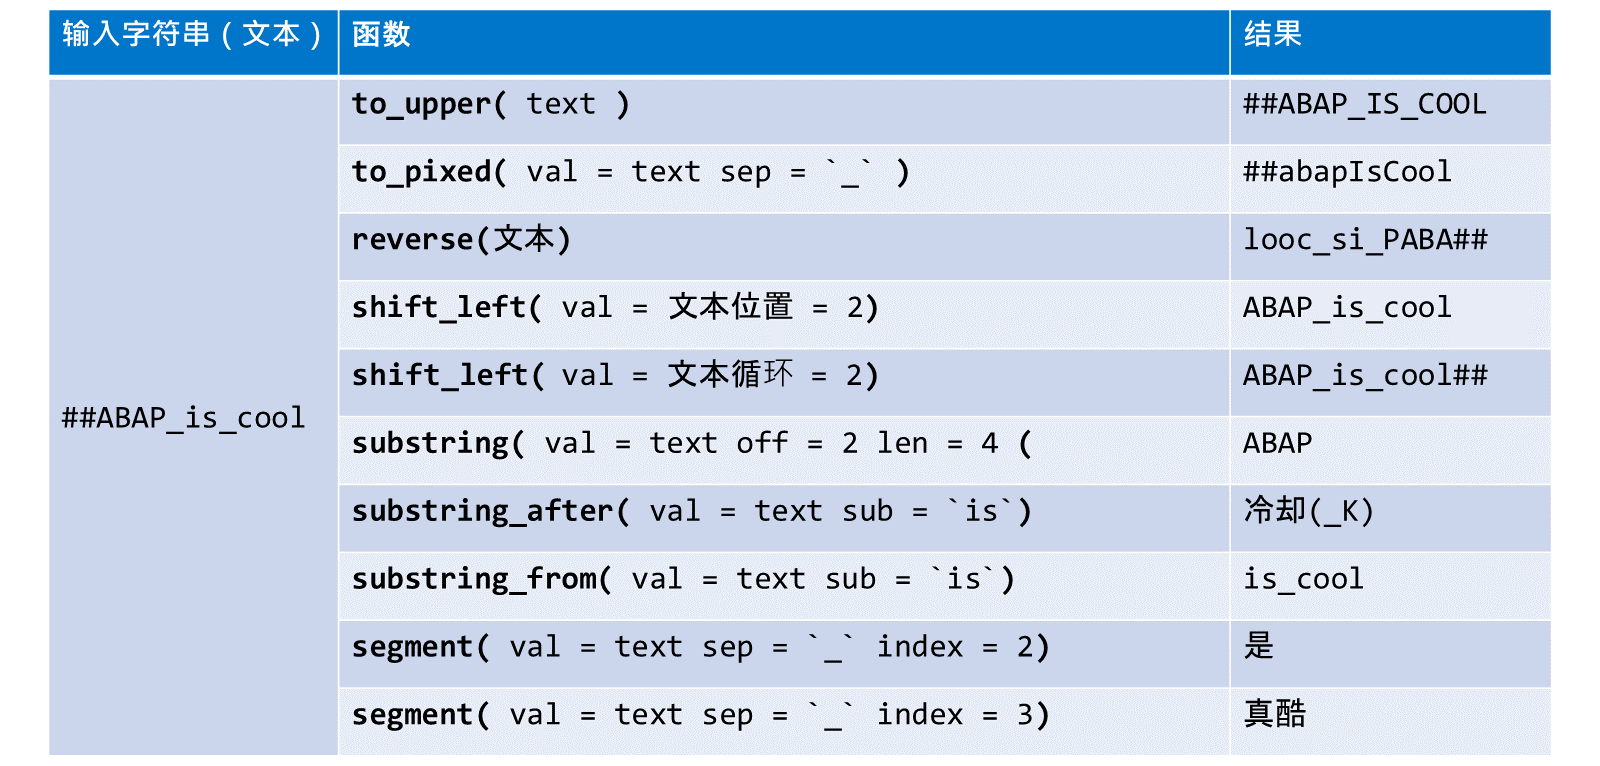
让我们看几个示例,以说明一些字符串处理函数的结果:
在此示例中,输入字符串混合了大写和小写字母。函数 TO_UPPER() 将它们全部转换为大写字母。
函数 TO_MIXED() 将字符串混合为大写和小写字母。它搜索分隔符字符串,将其移除,并将分隔符后的第一个字符转换为大写。所有其他字符均转换为小写。请注意,参数 sep 是可选的,下划线符号 (_) 作为其缺省值。
函数 REVERSE() 按相反顺序返回字符。
SHIFT_LEFT( ) 函数的第一个示例指定 places = 2 。因此,前两个字符 (##) 将从结果中移除。
SHIFT_LEFT() 的第二个示例指定参数 circular = 2 。因此,前两个字符不会删除,而是移动到末尾。
函数 SUBSTRING() 的示例提取长度为 4 的子字符串,以 2 个字符的偏移开头,这意味着它返回位置 3、4、5 和 6 处的字符。
函数 SUBSTRING_AFTER() 搜索子字符串 "is" 并返回此结果之后的所有字符。
函数 SUBSTRING_FROM() 执行相同,但结果还包含子字符串 "is"。
函数 SEGMENT() 的第一个示例查找分隔符字符串的所有匹配项,即单个下划线。它找到两个,并将输入字符串拆分为三个段。然后返回第二个段。
第二个示例执行相同操作,但返回第三个段。请注意,分隔符字符串本身不是结果的一部分。
试用:处理功能
创建实施接口 IF_OO_ADT_CLASSRUN 的新全局类。
将以下代码片段复制到方法 if_oo_adt_classrun~main() 的实施部分:
DATA text TYPE string      VALUE ` SAP BTP,   ABAP Environment  `.
* Change Case of characters
**********************************************************************
out->write( |TO_UPPER         = {   to_upper(  text ) } | ).
out->write( |TO_LOWER         = {   to_lower(  text ) } | ).
out->write( |TO_MIXED         = {   to_mixed(  text ) } | ).
out->write( |FROM_MIXED       = { from_mixed(  text ) } | ).
* Change order of characters
**********************************************************************
out->write( |REVERSE             = {  reverse( text ) } | ).
out->write( |SHIFT_LEFT  (places)= {  shift_left(  val = text places   = 3  ) } | ).
out->write( |SHIFT_RIGHT (places)= {  shift_right( val = text places   = 3  ) } | ).
out->write( |SHIFT_LEFT  (circ)  = {  shift_left(  val = text circular = 3  ) } | ).
out->write( |SHIFT_RIGHT (circ)  = {  shift_right( val = text circular = 3  ) } | ).
* Extract a Substring
**********************************************************************
out->write( |SUBSTRING       = {  substring(        val = text off = 4 len = 10 ) } | ).
out->write( |SUBSTRING_FROM  = {  substring_from(   val = text sub = 'ABAP'     ) } | ).
out->write( |SUBSTRING_AFTER = {  substring_after(  val = text sub = 'ABAP'     ) } | ).
out->write( |SUBSTRING_TO    = {  substring_to(     val = text sub = 'ABAP'     ) } | ).
out->write( |SUBSTRING_BEFORE= {  substring_before( val = text sub = 'ABAP'     ) } | ).
* Condense, REPEAT and Segment
**********************************************************************
out->write( |CONDENSE         = {   condense( val = text ) } | ).
out->write( |REPEAT           = {   repeat(   val = text occ = 2 ) } | ).
out->write( |SEGMENT1         = {   segment(  val = text sep = ',' index = 1 ) } |  ).
out->write( |SEGMENT2         = {   segment(  val = text sep = ',' index = 2 ) } |  ).
选择 Ctrl + F3 激活类,然后选择 F9 将其作为控制台应用执行。
分析控制台输出。您能否了解不同功能的结果?
围绕起始值执行不同功能,以熟悉其结果。
使用 文本 、 子字符串 的起始值和不同参数的值来熟悉函数。
谓词函数
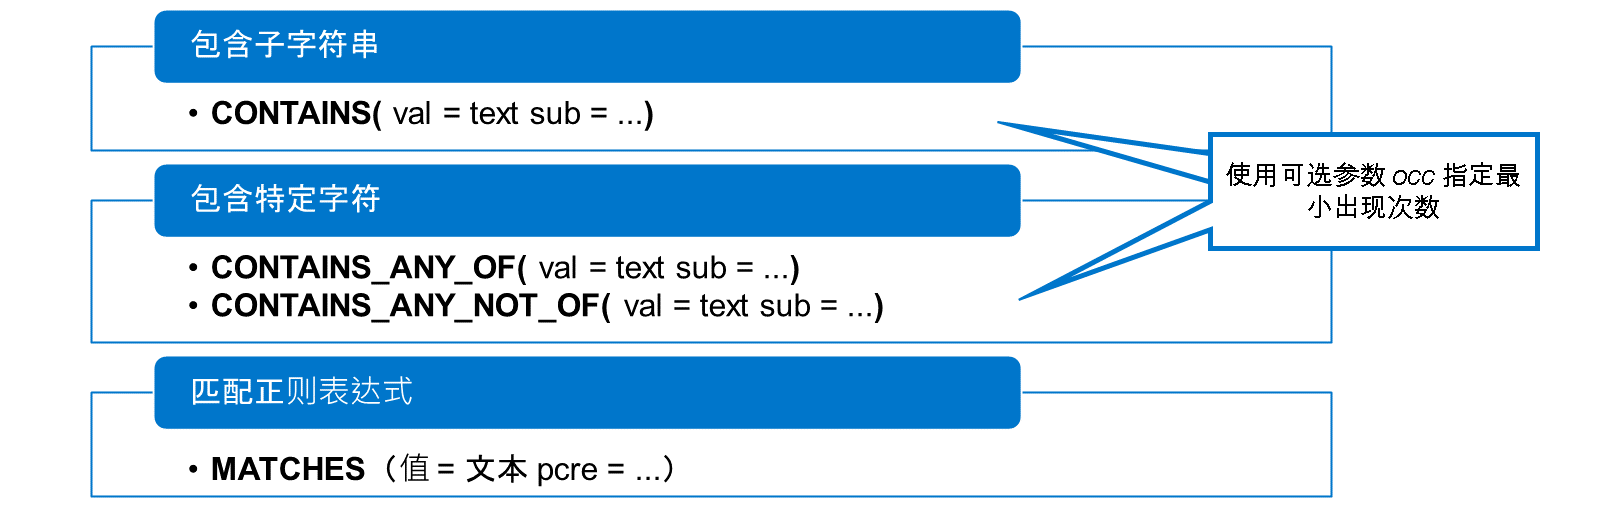
如果指定的子字符串在输入字符串中至少出现一次,则谓词函数 CONTAINS() 为真。换句话说,如果 CONTAINS() 为 true,则函数 COUNT( ) 返回大于 0 的结果。
谓词功能 CONTAINS_ANY_OF() 和 CONTAINS_ANY_NOT_OF() 与相应的描述功能 COUNT_ANY_OF() 和 COUNT_ANY_NOT_OF() 之间存在相同的关系。
MATCHES() 是一个专用的谓词函数,用于将完整的输入字符串与正则表达式进行比较。我们将在下一节中查看正则表达式。
ABAP 中的正则表达式
正则表达式(简称 Regex)是描述字符串集的文字和特殊字符的模式。正则表达式通常用于文本搜索、"搜索和替换"操作或验证字符型字段的内容。使用正则表达式的搜索比搜索简单字符串更强大,因为正则表达式表示更大(潜在无限)数量的字符串并同时搜索。
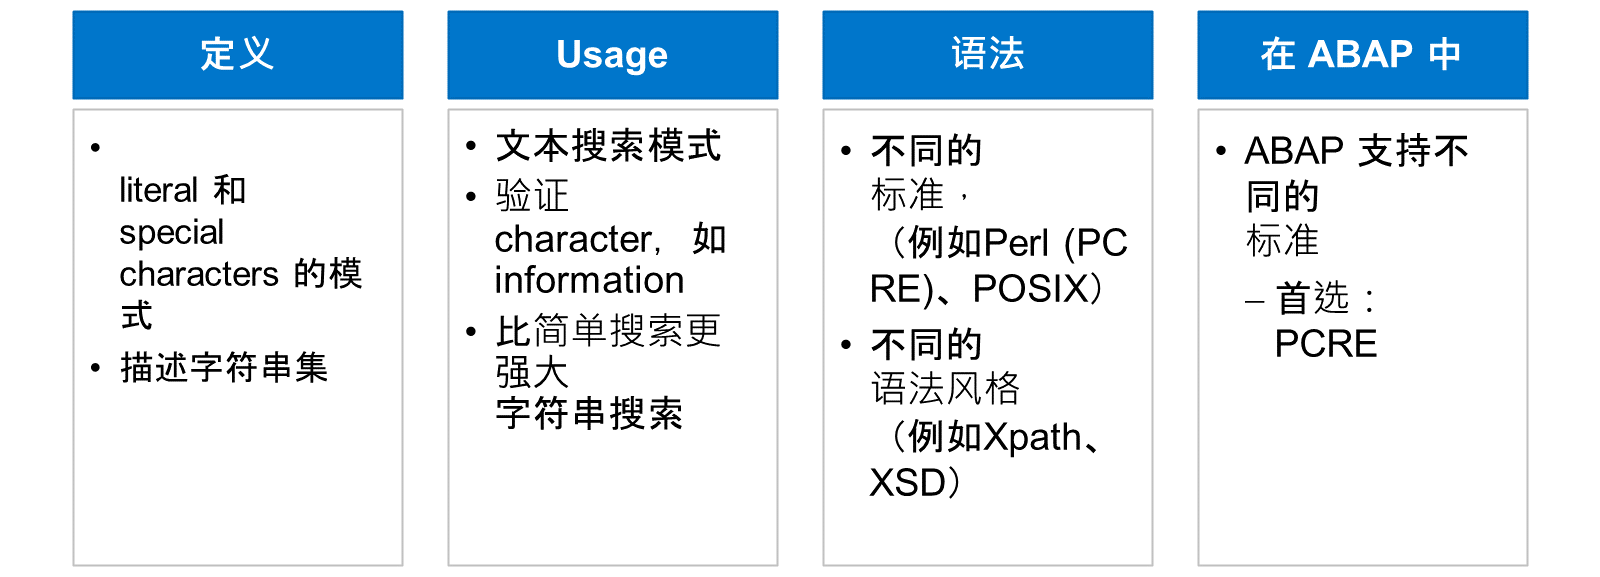
正则表达式的语法已广泛标准化,但 Perl 或 POSIX 等通用标准与不同语法风格(如 XPath 或 XSD 正则表达式)之间存在差异。
在 ABAP 中,首选标准是 Perl 兼容正则表达式 (PCRE),但 ABAP 还支持一些其他标准和风格。
注意
本课程中的示例遵循 PCRE 标准。有关其他标准和语法风格,请参阅 ABAP 关键字文档。
正则表达式的例子
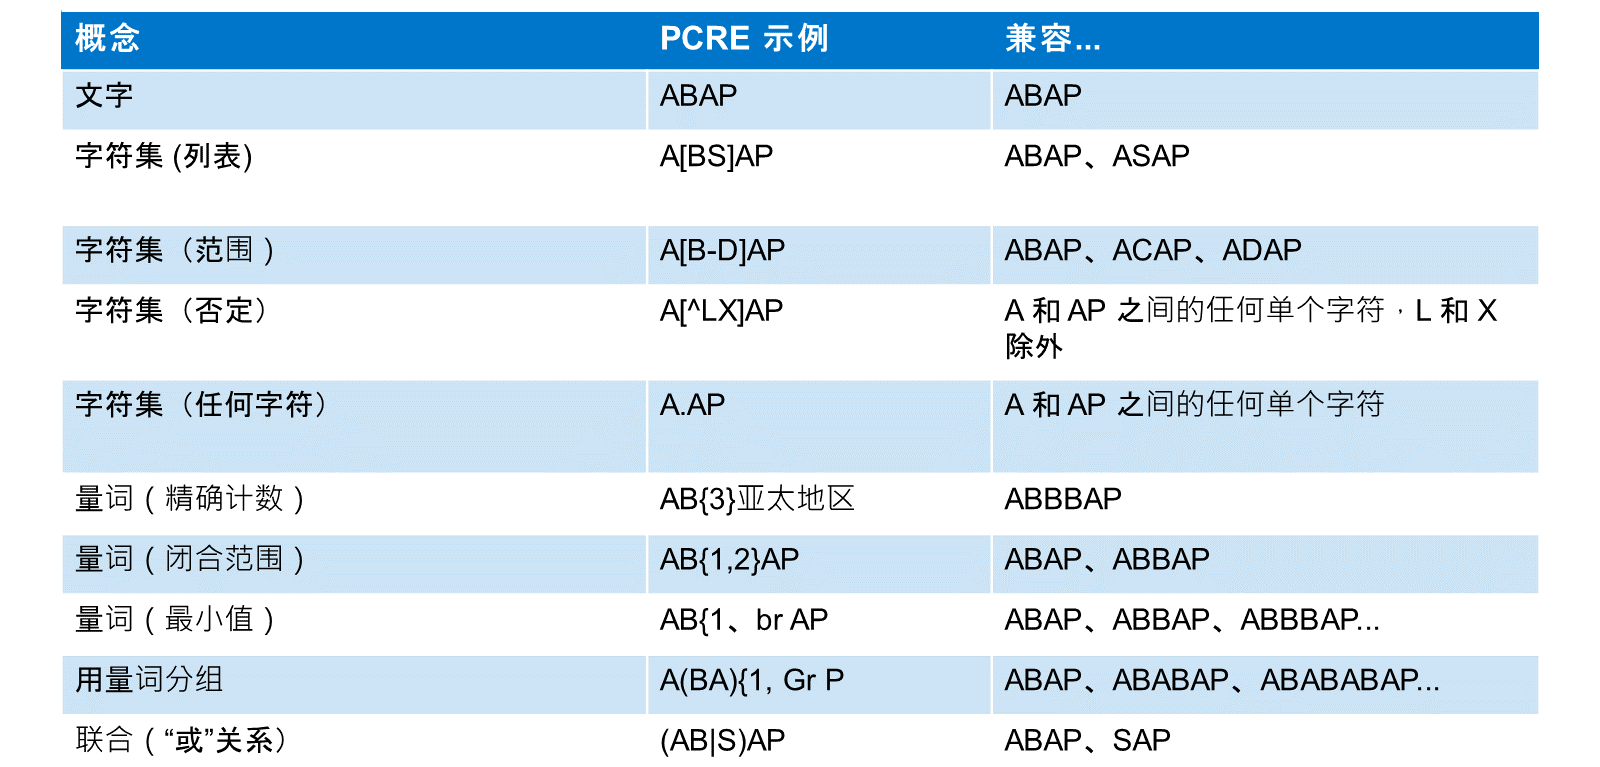
让我们看一下正则表达式的一些示例:
最简单的正则表达式是文字。
通过使用一对方括号 ([ ]),可以指定特定位置允许的字符集。第一个示例指定由两个单独的字符 B 和 S 组成的字符集。因此,字母 B 或 S 允许介于两个字母 A 之间。
下一示例使用连字符 (-) 指定允许的字符范围。B-D 定义了一个字符集,该字符集包括 B、D 以及它们之间的所有字符(按词典顺序)。当然,可以组合单个值和多个范围。例如 [AL-NRX-Z] 定义由字母 A、L、M、N、R、X、Y、Z 组成的字符集。
下一个示例在左括号后使用 ^ 符号来定义排除列表,而不是准许列表。[^LX] 不包括字符 L 和 X,但允许所有其他字符。
要指定包含所有可用字符并排除 none 的字符集,正则表达式使用单个句号符号 (.)。在此示例中,两个 As 之间允许有任何字符,但该字符是必需的,并且仅允许一个此类字符。
为了提高灵活性,可以引入量词。量词是一对花括号 ({})。它指定左侧元素必须重复的频率。在此示例中,量词中的 3 表示两个 A 之间恰好需要 3 个字母 B。
量词可以指定重复的下限值和上限值,而不是一个固定值。在此示例中,两个 A 之间至少需要一个 B,但也允许两个 B。
离开上限值时,仅设置最小值。在此示例中,两个 A 之间可以有任意数量的字母 B,但必须至少有一个。
使用普通括号 (),将多个元素组合在一起。好的用例是量词左侧的组。根据量词中的数字重复整个组,而不是单个字符。在此示例中,组 BA 在字母 A 和 P 之间重复。
最后,我们想查看 union 运算符 | 。在组外,它合并两个模式并组合两个模式的结果集。在此示例中,我们使用组内的 union 运算符。在关账文字 AP 的左侧,允许两种模式:存在文字 AB 或单个字母 S。
注意
这些示例相当简单,目的是说明一些基本概念。还有许多其他概念,通过组合所有这些概念,您可以构建极其强大的表达。有关完整图片,请从 ABAP 文档开始,从中可以导航到更多信息源。
内置字符串函数和正则表达式
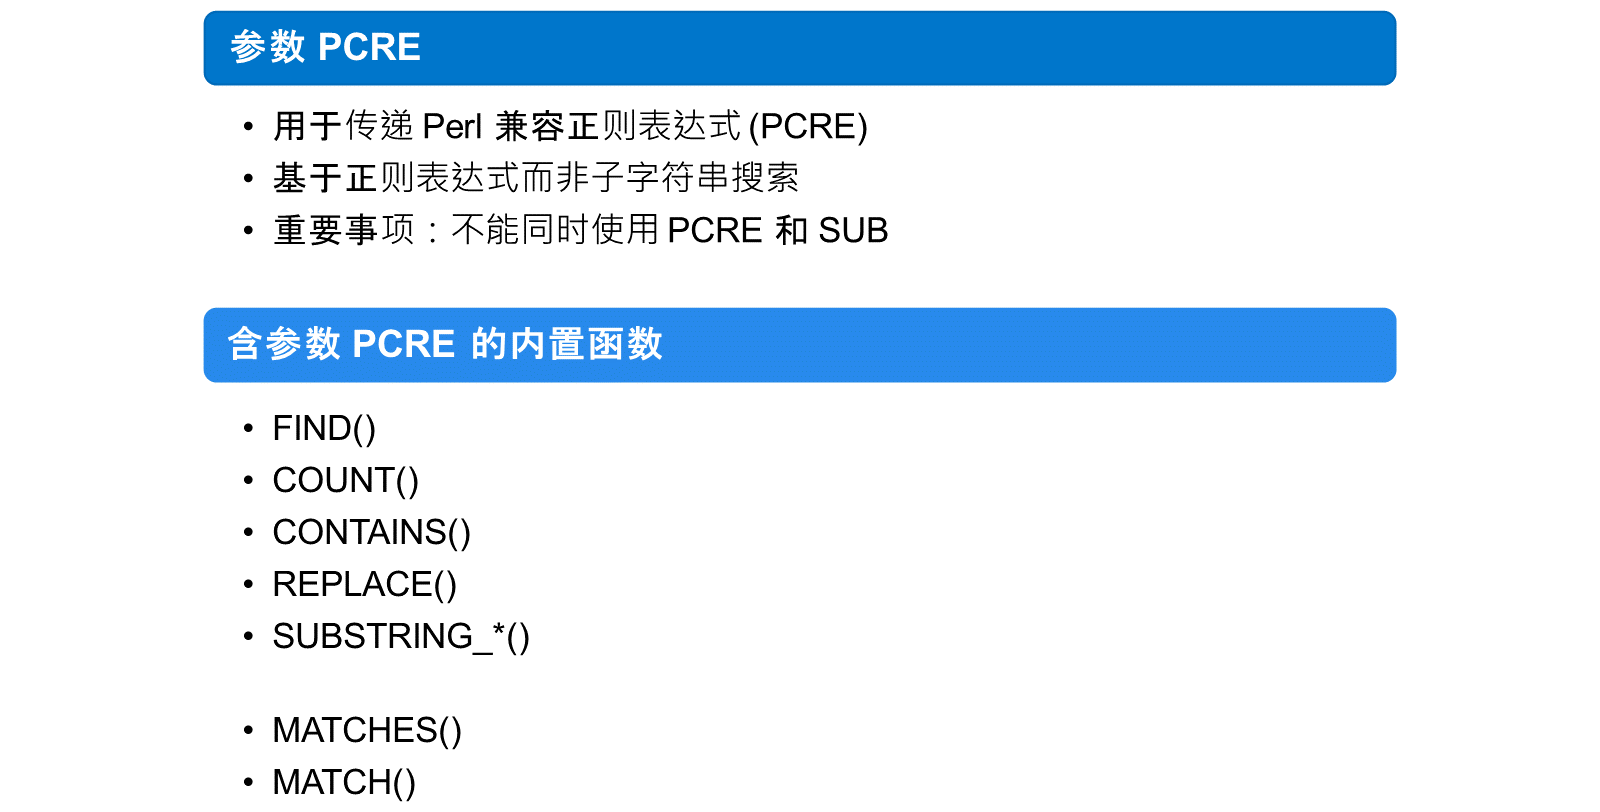
许多内置字符串函数提供参数 pcre,尤其是在执行搜索时。Pcre 通常是参数 sub 的备选项。向参数 pcre 传递一系列字符时,函数会将输入解释为 Perl Compatible Regular Expression (PCRE),并搜索与此模式匹配的子字符串。如果函数同时具有参数 sub 和 pcre,则只能提供其中一个。
注意
在 ABAP 文档中,您可以找到正则表达式的更多参数。其中一个参数正则表达式用于 POSIX 正则表达式。它已过时,不应使用。
对于 FIND() 和 COUNT() 等函数,很明显它们执行子字符串搜索。但其他功能也执行搜索。例如,谓词函数 CONTAINS() 和处理函数 REPLACE( )、SUBSTRING_FROM( )、SUBSTRING_AFTER() 等。
还有一些内置字符串函数仅适用于正则表达式。如果完整字符串与正则表达式匹配,则谓词函数 MATCHES( ) 为 true。MATCH() 的工作原理类似于 FIND()。它在字符串中搜索与正则表达式匹配的子字符串。但是,如果 FIND( ) 返回结果的 offset,则 MATCH( ) 返回找到的子字符串。
此视频介绍了一些参数 PCRE 的示例。
视频:本节含 SAP 官方视频(视频 ID
1_rqvczi1v),需在 learning.sap.com 在线观看。
注意
如果必须对字符型输入字段实施复杂的验证,则 matches() 函数是一种尖锐而优雅的工具。
使用字符串处理功能
在本练习中,在将文本符号添加到控制台输出之前,使用字符串处理函数通过变量内容丰富文本符号。
模板:
/LRN/CL_S4D401_TCS_TEXT_POOL(全局类)
解决方案:
/LRN/CL_S4D401_TCS_STRING_PROC(全局类)
任务 1: 复制模板(可选)
复制模板类 /LRN/CL_S4D401_TCS_TEXT_POOL。如果已完成上一练习,则可以跳过此任务并继续编辑类 ZCL_##_SOLUTION。
步骤
将类
/LRN/CL_S4D401_TCS_TEXT_POOL复制到您自己的包中的类(建议名称:ZCL_##_SOLUTION,其中 ## 代表组编号)。在项目浏览器中,右键单击类
/LRN/CL_S4D401_TCS_TEXT_POOL以打开上下文菜单。从上下文菜单中,选择复制....
在包字段中输入包的名称。在名称字段中,输入
ZCL_##_SOLUTION,其中 ## 代表组编号。选择下一步。
确认传输请求并选择完成。
激活复制。
按
Ctrl + F3激活类。
任务 2: 使用字符串处理功能
确保使用全局类的原始语言登录。然后调整本地类 LCL_PASSENGER_FLIGHT 的方法 GET_DESCRIPTION 的实施。将字符串模板中的文字文本替换为文本池中的可翻译文本。对于第一个文本,使用占位符创建单个文本符号,并使用字符串处理函数将占位符替换为属性值。
步骤
显示 ABAP 类的原始语言,并确保您以相同的语言登录。
打开全局类
ZCL_##_SOLUTION的源代码。从编辑器下方的选项卡中,选择属性选项卡。
记录原始语言属性。应将其设置为 EN。
在项目浏览器中,分析 ABAP 云项目的描述。在系统标识、登录客户端和用户标识之后,将显示登录语言。
如果登录语言与 ABAP 类的原始语言不匹配,则使用正确的登录语言创建新项目。
导航到本地类
LCL_PASSENGER_FLIGHT中方法GET_DESCRIPTION的实施。例如,您可以在编辑器中打开局部类型标签并搜索
METHOD get_description。或者,您可以在左侧的概要视图中展开 ZCL_##_SOLUTION→LCL_PASSENGER_FLIGHT,然后选择 GET_DESCRIPTION。
注释掉第一个 APPEND 语句,并将其替换为 STRING 类型的局部变量的 APPEND(建议名称:
txt)。选择属于第一个 APPEND 语句的所有代码行,然后按
Ctrl + <。如下调整代码:
*  APPEND |Flight { carrier_id } { connection_id } on { flight_date DATE = USER } | &&
*         |from { connection_details-airport_from_id } to { connection_details-airport_to_id }|
*         TO r_result.
DATA txt TYPE string.
APPEND txt TO r_result.
在 APPEND 语句之前,用反映先前字符串模板的文本文字填充数据对象。使用字符串模板包含嵌入式表达式的合适占位符,例如
&carrid&、&connid&、&date&、&from&和&to&。如下调整代码:
DATA text TYPE string.
txt = 'Flight &carrid& &connid& on &date& from &from& to &to&'.
APPEND text TO r_result.
将文本文字链接到新文本符号(文本符号的建议标识:
005)。如下调整代码:
txt = 'Flight &carrid& &connid& on &date& from &from& to &to&'(005).
使用快速修复在文本池中创建最大长度为
132的新文本。将光标置于
(005)上并按Ctrl + 1。选择 在文本池中创建文本 005 。
使用滑块将最大长度设置为
132,然后选择完成。返回到 ABAP 代码。在 APPEND 语句之前,使用合适的字符串处理函数将字符串变量
txt中的占位符&carrid&替换为实例属性carrier_id的内容。如下调整代码:
txt = 'Flight &carrid& &connid& on &date& from &from& to &to&'(005).
txt = replace( val = txt sub = '&carrid&' with = carrier_id ).
APPEND txt TO r_result.
针对其他占位符相应地重复上述步骤。不要忘记根据用户首选日期格式,设置航班日期的格式。
如下调整代码:
txt = 'Flight &carrid& &connid& on &date& from &from& to &to&'(005).
txt = replace( val = txt sub = '&carrid&' with = carrier_id ).
txt = replace( val = txt sub = '&connid&' with = connection_id ).
txt = replace( val = txt sub = '&date&'   with = |{ flight_date DATE = USER }| ).
txt = replace( val = txt sub = '&from&'   with = connection_details-airport_from_id ).
txt = replace( val = txt sub = '&to&'     with = connection_details-airport_to_id ).
APPEND txt TO r_result.
可选:将
GET_DESCRIPTION方法中的剩余文字文本替换为文本符号。照常执行该步骤。
最后,您的代码应如下所示:
METHOD get_description.
*    APPEND |Flight { carrier_id } { connection_id } on { flight_date DATE = USER } | &&
*           |from { connection_details-airport_from_id } to { connection_details-airport_to_id }|
*           TO r_result.
DATA txt TYPE string.
txt = 'Flight &carrid& &connid& on &date& from &from& to &to&'(005).
txt = replace( val = txt sub = '&carrid&' with = carrier_id ).
txt = replace( val = txt sub = '&connid&' with = connection_id ).
txt = replace( val = txt sub = '&date&'   with = |{ flight_date DATE = USER }| ).
txt = replace( val = txt sub = '&from&'   with = connection_details-airport_from_id ).
txt = replace( val = txt sub = '&to&'     with = connection_details-airport_to_id ).
APPEND txt TO r_result.
APPEND |{ 'Planetype:'(006)      } { planetype  }| TO r_result.
APPEND |{ 'Maximum Seats:'(007)  } { seats_max  }| TO r_result.
APPEND |{ 'Occupied Seats:'(008) } { seats_occ  }| TO r_result.
APPEND |{ 'Free Seats:'(009)     } { seats_free }| TO r_result.
APPEND |{ 'Ticket Price:'(010)   } { price CURRENCY = currency } { currency }| TO r_result.
APPEND |{ 'Duration:'(011)       } { connection_details-duration } { 'minutes'(012) }| TO r_result.
ENDMETHOD.
激活全局类并将其作为控制台应用进行测试。
注意
您不应注意到任何差异。改进是文本现在可翻译。但是,这只有在系统管理员实际创建翻译项目时才会起作用。这超出了本课程的范围。
按
Ctrl + F3。按
F9。