跨分组时间序列预测
学习目标
使用 SAP HANA PAL 跨分组时间序列实施预测逻辑。
在实际预测场景中,通常为国家/地区、商店或产品线等多个类别生成单独的预测。本课将介绍如何使用 SAP HANA PAL 中的 group_key 参数和自定义循环逻辑跨多个此类组扩缩时间序列预测。
使用 AdditiveModelForecast 算法训练模型
面向 SAP HANA 的 Python 机器学习客户端 (hana-ml) 公开所有 SAP HANA 预测分析库 (PAL) 函数以及 Python 中的自动预测库 (APL) 函数,以便基于 SAP HANA DataFrame 输入数据使用。
接下来,我们使用相同的 AdditiveModelForecast 算法 [1] 训练单个模型 - 与单变量时间序列模型场景相同。
但是,我们现在将居住国指定为组代码,为每个国家/地区提供单独的模型。
amf = AdditiveModelForecast(massive=True)
amf.fit(data=hdf_overnightstays_agg, group_key='COUNTRYOFRESIDENCE')
<hana_ml.algorms.pal.tsa.additive_model_forecast.AdditiveModelForecast,网址为 0x1d9c79d7020>
时间序列预测 - 按国家/地区单独进行
我们创建一个 SAP HANA 数据框架,其中包含要为其创建预测的日期/月份。
接下来,我们从训练历史记录中确定最近一个月。
str_lastdate = hdf_overnightstays_agg.tail(1, ref_col='MONTH').collect().iloc[0,0]
str_lastdate = str(str_lastdate)[0:10]

print(str_lastdate)
2024-05-01
现在,我们创建一个 SAP HANA 数据框架,其中包含要预测的所需月份的第一天。
months_to_forecast=12

hdf_overnightstays_future = binomial(conn, n=1, p=1, num_random=months_to_forecast)
hdf_overnightstays_future = hdf_overnightstays_future.select('*', (f'''ADD_MONTHS(TO_DATE ('{str_lastdate}', 'YYYY-MM-DD'), ID+1)''', 'MONTH') )
hdf_overnightstays_future = hdf_overnightstays_future.select('MONTH', ('0', 'TARGET'))
hdf_overnightstays_future.head(10).collect()
月份 |
目标 |
|
|---|---|---|
0 |
2024-06-01 |
0 |
1 |
2024-07-01 |
0 |
2 |
2024-08-01 |
0 |
3 |
2024-09-01 |
0 |
4 |
2024-10-01 |
0 |
5 |
2024-11-01 |
0 |
6 |
2024-12-01 |
0 |
7 |
2025-01-01 |
0 |
8 |
2025-02-01 |
0 |
9 |
2025-03-01 |
0 |
然后,我们创建一个 SAP HANA 数据框架,其中包含应交付预测的国家/地区。
hdf_overnightstays_countries = hdf_overnightstays.agg([('sum', 'OVERNIGHTSTAYS', 'TOTAL'  )], group_by='COUNTRYOFRESIDENCE' ) \
.sort('TOTAL', desc=True).select('COUNTRYOFRESIDENCE').head(10)
hdf_overnightstays_countries.collect()
COUNTRYOFRESIDENCE |
|
|---|---|
0 |
瑞士 |
1 |
德国 |
2 |
美国 |
3 |
英国 |
4 |
法国 |
5 |
意大利 |
6 |
荷兰 |
7 |
比利时 |
8 |
印度 |
9 |
西班牙 |
接下来,我们将上述两个 SAP HANA 数据框架相结合,创建一个新的 DataFrame,其中包含每个国家/地区的未来日期/月份。
hdf_overnightstays_topredict = hdf_overnightstays_future.add_id().set_index('ID').join(hdf_overnightstays_countries.add_id('ID').set_index('ID'), how='cross' )
hdf_overnightstays_topredict = hdf_overnightstays_topredict.drop('ID')
hdf_overnightstays_topredict.head(10).collect()
月份 |
目标 |
COUNTRYOFRESIDENCE |
|
|---|---|---|---|
0 |
2024-06-01 |
0 |
瑞士 |
1 |
2024-06-01 |
0 |
德国 |
2 |
2024-06-01 |
0 |
美国 |
3 |
2024-06-01 |
0 |
英国 |
4 |
2024-06-01 |
0 |
法国 |
5 |
2024-06-01 |
0 |
意大利 |
6 |
2024-06-01 |
0 |
荷兰 |
7 |
2024-06-01 |
0 |
比利时 |
8 |
2024-06-01 |
0 |
印度 |
9 |
2024-06-01 |
0 |
西班牙 |
应用模型以生成预测
接下来,我们对训练的时间序列模型进行评分,为指定日期的各个国家/地区创建预测。
hdf_overnightstays_pred = amf.predict(data=hdf_overnightstays_topredict, group_key='COUNTRYOFRESIDENCE')
hdf_overnightstays_predicted = hdf_overnightstays_pred[0]
我们可以查看预测组件的详细信息,即趋势、季节性,如下所示:
hdf_overnightstays_pred[1].collect()
组标识 |
月份 |
趋势 |
SEASONAL |
HOLIDAY |
EXOGENOUS |
|
|---|---|---|---|---|---|---|
0 |
比利时 |
2024-06-01 |
46941.398949 |
{"季节性":3149.2922197280824} |
{} |
{} |
1 |
比利时 |
2024-07-01 |
46645.399501 |
{"季节性":53969.69442748901} |
{} |
{} |
2 |
比利时 |
2024-08-01 |
46339.533404 |
{"季节性":47670.95477129075} |
{} |
{} |
3 |
比利时 |
2024-09-01 |
46033.667307 |
{"季节性":-10867.900939089028} |
{} |
{} |
4 |
比利时 |
2024-10-01 |
45737.667859 |
{"季节性":-35024.826999824596} |
{} |
{} |
... |
... |
... |
... |
... |
... |
... |
115 |
美国 |
2025-01-01 |
256174.088611 |
{"季节性":-105260.40367463966} |
{} |
{} |
116 |
美国 |
2025-02-01 |
255710.827254 |
{"季节性":-107113.21705733694} |
{} |
{} |
117 |
美国 |
2025-03-01 |
255292.397641 |
{"季节性":-63771.189585235305} |
{} |
{} |
118 |
美国 |
2025-04-01 |
254829.136284 |
{"季节性":-74262.95570659888} |
{} |
{} |
119 |
美国 |
2025-05-01 |
254380.818842 |
{"季节性":35157.57804977409} |
{} |
{} |
120 行 × 6 列
评估准确性
我们检查是否存在任何错误,如下所示:
hdf_overnightstays_pred[2].collect()
GROUP_ID ERROR_TIMESTAMP ERRORCODE MESSAGE
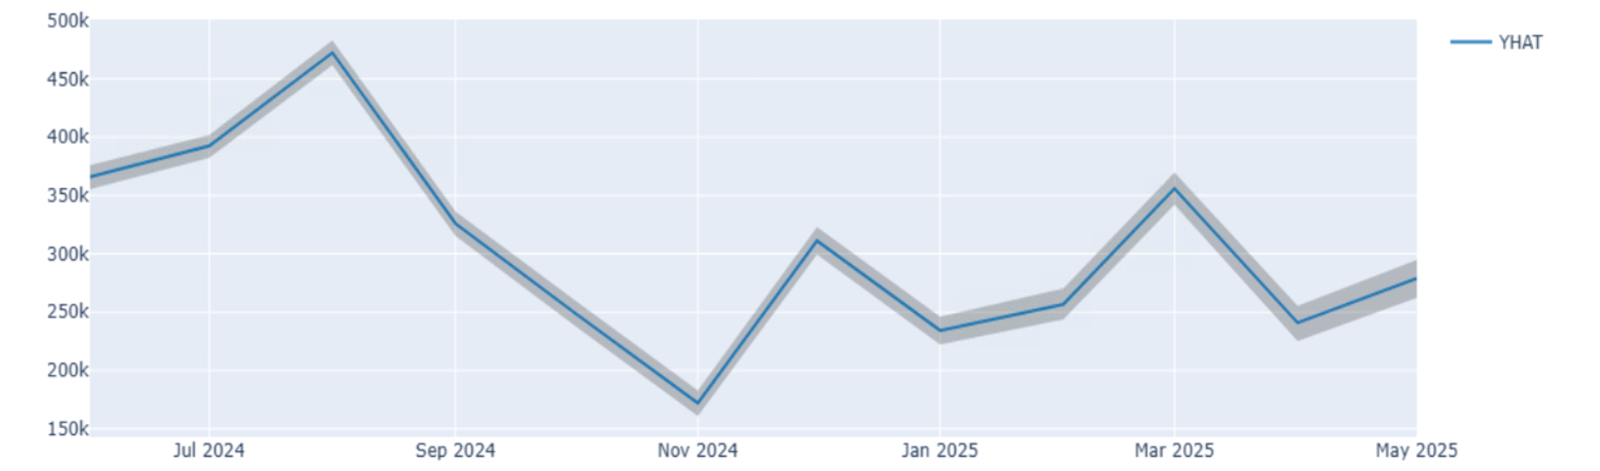
我们专门为德国绘制预测,如下所示:
forecast_line_plot(pred_data=hdf_overnightstays_predicted.filter(''' "GROUP_ID" = 'Germany' ''').drop('GROUP_ID').set_index('MONTH'),
confidence=("YHAT_LOWER", "YHAT_UPPER"), enable_plotly=True)
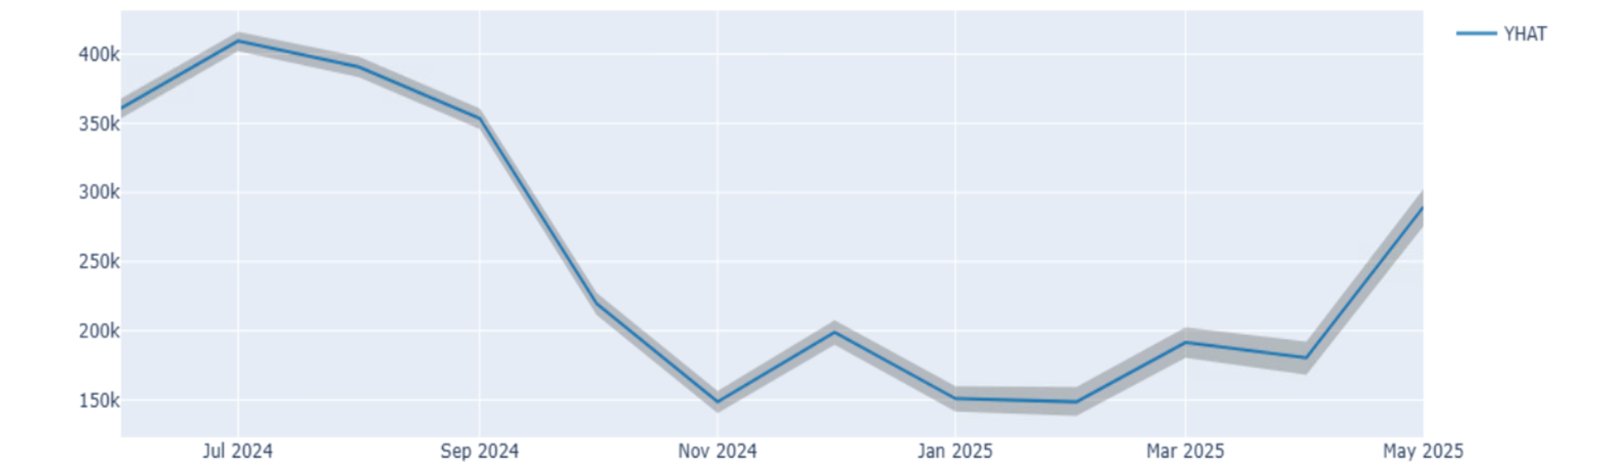
现在,我们按如下方式绘制美国的预测:
forecast_line_plot(pred_data=hdf_overnightstays_predicted.filter(''' "GROUP_ID" = 'United States' ''').drop('GROUP_ID').set_index('MONTH'),
confidence=("YHAT_LOWER", "YHAT_UPPER"), enable_plotly=True)
我们可以将用于训练模型的历史数据集和预测值合并到单个 SAP HANA 数据框架中,如下所示:
hdf_overnightstays_predicted = hdf_overnightstays_predicted.select(
'MONTH',
('GROUP_ID', 'COUNTRYOFRESIDENCE'),
('NULL', 'OVERNIGHTSTAYS_SUM'),
('YHAT', 'FORECAST'),
('YHAT_LOWER', 'FORECAST_LOWER'),
('YHAT_UPPER', 'FORECAST_UPPER')
)
hdf_overnightstays_predicted.head(10).collect()
月份 |
COUNTRYOFRESIDENCE |
OVERNIGHTSTAYS_SUM |
预测 |
FORECAST_LOWER |
FORECAST_UPPER |
|
|---|---|---|---|---|---|---|
0 |
2024-06-01 |
比利时 |
无 |
50090.691169 |
47179.354589 |
52902.229641 |
1 |
2024-07-01 |
比利时 |
无 |
100615.093928 |
97772.912096 |
103203.241535 |
2 |
2024-08-01 |
比利时 |
无 |
94010.488175 |
91129.243296 |
96876.143447 |
3 |
2024-09-01 |
比利时 |
无 |
35165.766368 |
32295.303313 |
38081.503388 |
4 |
2024-10-01 |
比利时 |
无 |
10712.840859 |
7792.914224 |
13545.382103 |
5 |
2024-11-01 |
比利时 |
无 |
15575.706973 |
12869.710511 |
18361.714953 |
6 |
2024-12-01 |
比利时 |
无 |
43761.773402 |
40908.291509 |
46512.689291 |
7 |
2025-01-01 |
比利时 |
无 |
22965.282178 |
20305.025961 |
25710.640517 |
8 |
2025-02-01 |
比利时 |
无 |
36852.832053 |
33948.725286 |
39735.768094 |
9 |
2025-03-01 |
比利时 |
无 |
42565.990727 |
39522.284487 |
45665.217573 |
hdf_overnightstays_agg = hdf_overnightstays_agg.select('*', ('NULL', 'FORECAST'),
('NULL', 'FORECAST_LOWER'),
('NULL', 'FORECAST_UPPER')
)
hdf_overnightstays_all = hdf_overnightstays_predicted.union(hdf_overnightstays_agg)
hdf_overnightstays_all.sort('MONTH').tail(20).collect()
月份 |
COUNTRYOFRESIDENCE |
OVERNIGHTSTAYS_SUM |
预测 |
FORECAST_LOWER |
FORECAST_UPPER |
|
|---|---|---|---|---|---|---|
0 |
2025-04-01 |
意大利 |
无 |
7.301358e+04 |
6.667947e+04 |
7.887995e+04 |
1 |
2025-04-01 |
美国 |
无 |
1.805662e+05 |
1.680320e+05 |
1.921834e+05 |
2 |
2025-04-01 |
英国 |
无 |
9.9774975e+04 |
9.186932e+04 |
1.070457e+05 |
3 |
2025-04-01 |
比利时 |
无 |
2.574547e+04 |
2.259784e+04 |
2.862533e+04 |
4 |
2025-04-01 |
瑞士 |
无 |
1.378666e+06 |
1.322983e+06 |
1.430933e+06 |
5 |
2025-04-01 |
西班牙 |
无 |
3.213217e+04 |
2.940963e+04 |
3.476349e+04 |
6 |
2025-04-01 |
印度 |
无 |
6.515502e+04 |
5.293711e+04 |
7.653153e+04 |
7 |
2025-04-01 |
德国 |
无 |
2.407886e+05 |
2.251664e+05 |
2.552813e+05 |
8 |
2025-04-01 |
法国 |
无 |
1.020115e+05 |
9.917646e+04 |
1.046622e+05 |
9 |
2025-04-01 |
荷兰 |
无 |
3.838326e+04 |
3.441906e+04 |
4.207428e+04 |
10 |
2025-05-01 |
美国 |
无 |
2.895384e+05 |
2.755186e+05 |
3.024338e+05 |
11 |
2025-05-01 |
意大利 |
无 |
6.399058e+04 |
5.780458e+04 |
6.952312e+04 |
12 |
2025-05-01 |
英国 |
无 |
1.080254e+05 |
9.963275e+04 |
1.155868e+05 |
13 |
2025-05-01 |
瑞士 |
无 |
1.502996e+06 |
1.445847e+06 |
1.553558e+06 |
14 |
2025-05-01 |
印度 |
无 |
1.180078e+05 |
1.052617e+05 |
1.293825e+05 |
15 |
2025-05-01 |
法国 |
无 |
1.204332e+05 |
1.173433e+05 |
1.233076e+05 |
16 |
2025-05-01 |
西班牙 |
无 |
3.689542e+04 |
3.382324e+04 |
3.98797e+04 |
17 |
2025-05-01 |
荷兰 |
无 |
5.181526e+04 |
4.768336e+04 |
5.550257e+04 |
18 |
2025-05-01 |
德国 |
无 |
2.789746e+05 |
2.621818e+05 |
2.946275e+05 |
19 |
2025-05-01 |
比利时 |
无 |
1.842008e+04 |
1.533416e+04 |
2.117920e+04 |
或者,我们可以将合并的数据集保存到 SAP HANA Cloud 中的表。例如,SAP Analytics Cloud 可以访问此类数据。
hdf_overnightstays_all.save('OVERNIGHTSTAYS_FORECAST_COUNTRIES', force=True)
<0x1d9c79d69f0 上的 <hana_ml.dataframe.DataFrame>
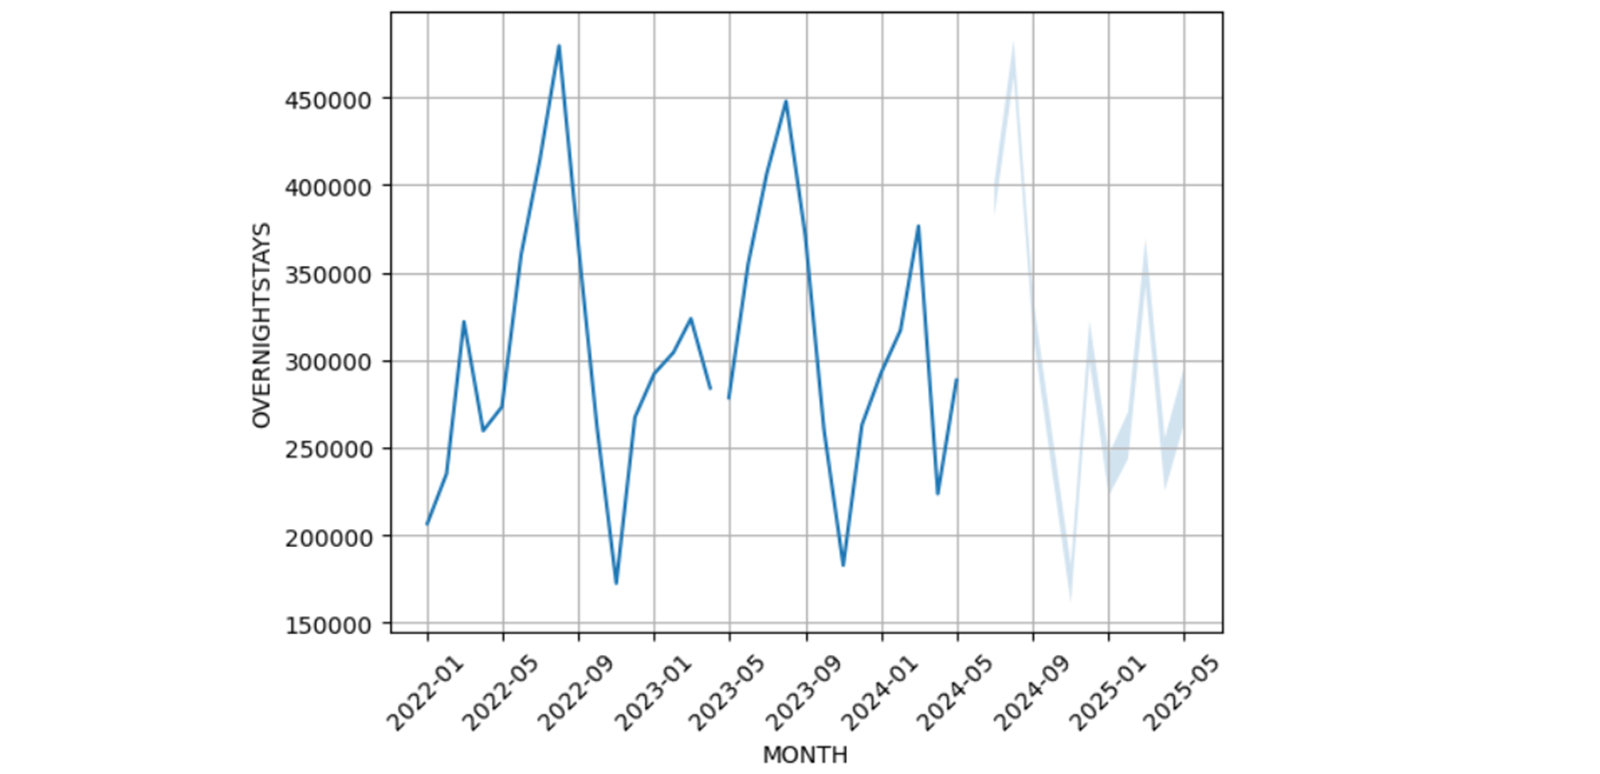
最后,为单个国家/地区(在本例中为德国)绘制整个数据集,即历史值和预测。
hdf_overnightstays_data = hdf_overnightstays_all.filter('''"COUNTRYOFRESIDENCE" = 'Germany' ''').collect()
fig, ax = plt.subplots()
ax.fill_between(hdf_overnightstays_data['MONTH'].values,
hdf_overnightstays_data['FORECAST_LOWER'].values,
hdf_overnightstays_data['FORECAST_UPPER'].values, alpha=0.2)

ax.plot(hdf_overnightstays_data['MONTH'].values,
hdf_overnightstays_data['OVERNIGHTSTAYS_SUM'].values, '-')

plt.xticks(rotation=45)
plt.xlabel("MONTH")
plt.ylabel("OVERNIGHTSTAYS")
plt.grid()
plt.show()