准备多个时间序列预测的数据
学习目标
说明如何组织和分组数据集以支持多个时间序列预测。
在单变量预测中,我们将所有过夜时间建模为一个组合时间序列。但是,实际场景通常需要对每个子组(例如地区、产品,或在本例中为居住国家/地区)进行单独预测。在本课中,你将了解如何准备数据集,以通过按国家/地区过滤和聚合数据来支持分组时间序列预测。
准备多变量场景的数据集
在上一节中,我们重点介绍了单变量时间序列建模场景,在该场景中,我们将所有余夜汇总为每月值,并预测接下来的 12 个月。
在本节中,我们将重点介绍多变量时间序列建模场景,在该场景中,我们为大多数访客来自的国家/地区创建单独的预测。
因此,让我们来了解过夜次数最多的前 10 个国家/地区。
hdf_overnightstays = conn.table('OVERNIGHTSTAYS')
hdf_overnightstays.agg([('sum', 'OVERNIGHTSTAYS', 'TOTAL')], group_by='COUNTRYOFRESIDENCE' ).sort('TOTAL', desc=True).head(10).collect()
COUNTRYOFRESIDENCE |
TOTAL |
|
|---|---|---|
0 |
瑞士 |
50087144 |
1 |
德国 |
8885041 |
2 |
美国 |
6365130 |
3 |
英国 |
3726785 |
4 |
法国 |
3279915 |
5 |
意大利 |
2027511 |
6 |
荷兰 |
1676202 |
7 |
比利时 |
1282186 |
8 |
印度 |
1210124 |
9 |
西班牙 |
1056512 |
我们需要使用上述国家/地区的清单作为整个表的过滤器。
可通过为"where 子句"创建逗号分隔的值列表来完成此操作,如下所示:
countries = hdf_overnightstays.agg([('sum', 'OVERNIGHTSTAYS', 'TOTAL')], group_by='COUNTRYOFRESIDENCE') \
.sort('TOTAL', desc=True).select('COUNTRYOFRESIDENCE').head(10).collect() \
.iloc[:,0].tolist()

countries = str(countries)
countries = countries.replace('[', '(')
countries = countries.replace(']', ')')
countries
"('瑞士', '德国', '美国', '英国', '法国', '意大利', '荷兰', '比利时', '印度', '西班牙')"
目前,SAP HANA 数据框架仅保存上述前 10 个国家/地区的相关信息。
接下来,我们再次聚合数据集,但这次按月份和国家/地区聚合。因此,我们能够创建国家/地区特定的预测。
hdf_overnightstays = hdf_overnightstays.filter(f'''"COUNTRYOFRESIDENCE" IN {countries}''')
hdf_overnightstays.head(10).collect()
月份 |
地区 |
COUNTRYOFRESIDENCE |
OVERNIGHTSTAYS |
|
|---|---|---|---|---|
0 |
2022-01-01 |
弗里堡州 |
印度 |
0 |
1 |
2022 年 1 月 1 日 |
格劳宾登州 |
意大利 |
10083 |
2 |
2022 年 1 月 1 日 |
格劳宾登州 |
西班牙 |
1586 |
3 |
2022 年 1 月 1 日 |
瑞士东部 |
意大利 |
1167 |
4 |
2022 年 1 月 1 日 |
瑞士东部 |
西班牙 |
212 |
5 |
2022 年 1 月 1 日 |
苏黎世州 |
西班牙 |
2949 |
6 |
2022 年 1 月 1 日 |
卢塞恩/卢塞恩湖 |
西班牙 |
523 |
7 |
2022 年 1 月 1 日 |
巴塞尔地区 |
意大利 |
1356 |
8 |
2022 年 1 月 1 日 |
巴塞尔地区 |
西班牙 |
672 |
9 |
2022 年 1 月 1 日 |
伯尔尼州 |
意大利 |
2724 |
现在,我们按月和国家汇总过夜,如下所示:
hdf_overnightstays_agg = hdf_overnightstays.agg([('sum', 'OVERNIGHTSTAYS', 'OVERNIGHTSTAYS_SUM')], group_by=['MONTH', 'COUNTRYOFRESIDENCE'])
hdf_overnightstays_agg = hdf_overnightstays_agg.sort('MONTH')
hdf_overnightstays_agg.head(5).collect()
月份 |
COUNTRYOFRESIDENCE |
OVERNIGHTSTAYS_SUM |
|
|---|---|---|---|
0 |
2022 年 1 月 1 日 |
印度 |
4701 |
1 |
2022 年 1 月 1 日 |
法国 |
63084 |
2 |
2022 年 1 月 1 日 |
意大利 |
43065 |
3 |
2022 年 1 月 1 日 |
德国 |
206477 |
4 |
2022 年 1 月 1 日 |
比利时 |
26172 |
之后,让我们准备数据集以绘制每个国家/地区随时间变化的过夜,如下所示:
hdf_overnightstays_plot = hdf_overnightstays_agg.pivot_table(values='OVERNIGHTSTAYS_SUM', index='MONTH', columns='COUNTRYOFRESIDENCE', aggfunc='sum').collect()
hdf_overnightstays.collect()
月份 |
地区 |
COUNTRYOFRESIDENCE |
OVERNIGHTSTAYS |
|
|---|---|---|---|---|
0 |
2022 年 1 月 1 日 |
弗里堡州 |
印度 |
0 |
1 |
2022 年 1 月 1 日 |
格劳宾登州 |
意大利 |
10083 |
2 |
2022 年 1 月 1 日 |
格劳宾登州 |
西班牙 |
1586 |
3 |
2022 年 1 月 1 日 |
瑞士东部 |
意大利 |
1167 |
4 |
2022 年 1 月 1 日 |
瑞士东部 |
西班牙 |
212 |
... |
... |
... |
... |
... |
3765 |
2024-05-01 |
日内瓦 |
印度 |
6887 |
3766 |
2024-05-01 |
瓦莱州 |
印度 |
4866 |
3767 |
2024-05-01 |
提契诺 |
印度 |
2215 |
3768 |
2024-05-01 |
弗里堡州 |
印度 |
157 |
3769 |
2024-05-01 |
阿尔高-索洛图恩州 |
印度 |
3954 |
3770 行 × 4 列
我们按如下方式生成绘图:
hdf_overnightstays_plot.plot(x='MONTH').legend(loc='center left',bbox_to_anchor=(1.0, 0.5));

plt.xticks(rotation='vertical')
plt.grid()
plt.show()
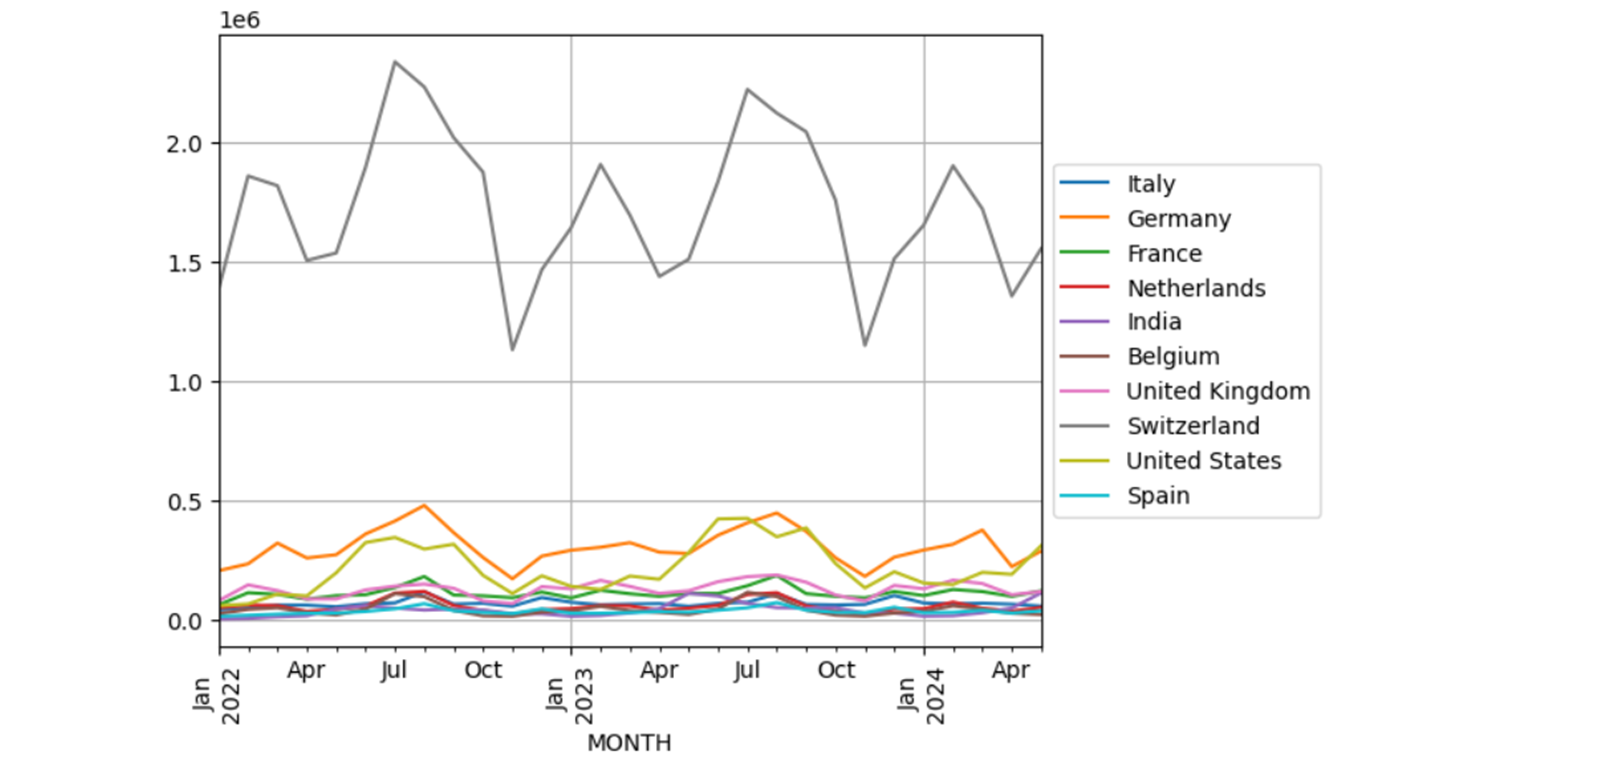
上一图人口密集。因此,我们决定关注最热门的两个外国。
接下来,我们只为德国和美国创造情节。
hdf_overnightstays_plot[['MONTH', 'Germany', 'United States']].plot(x='MONTH').legend(loc='center left',bbox_to_anchor=(1.0, 0.5));

plt.xticks(rotation='vertical')
plt.grid()
plt.show()
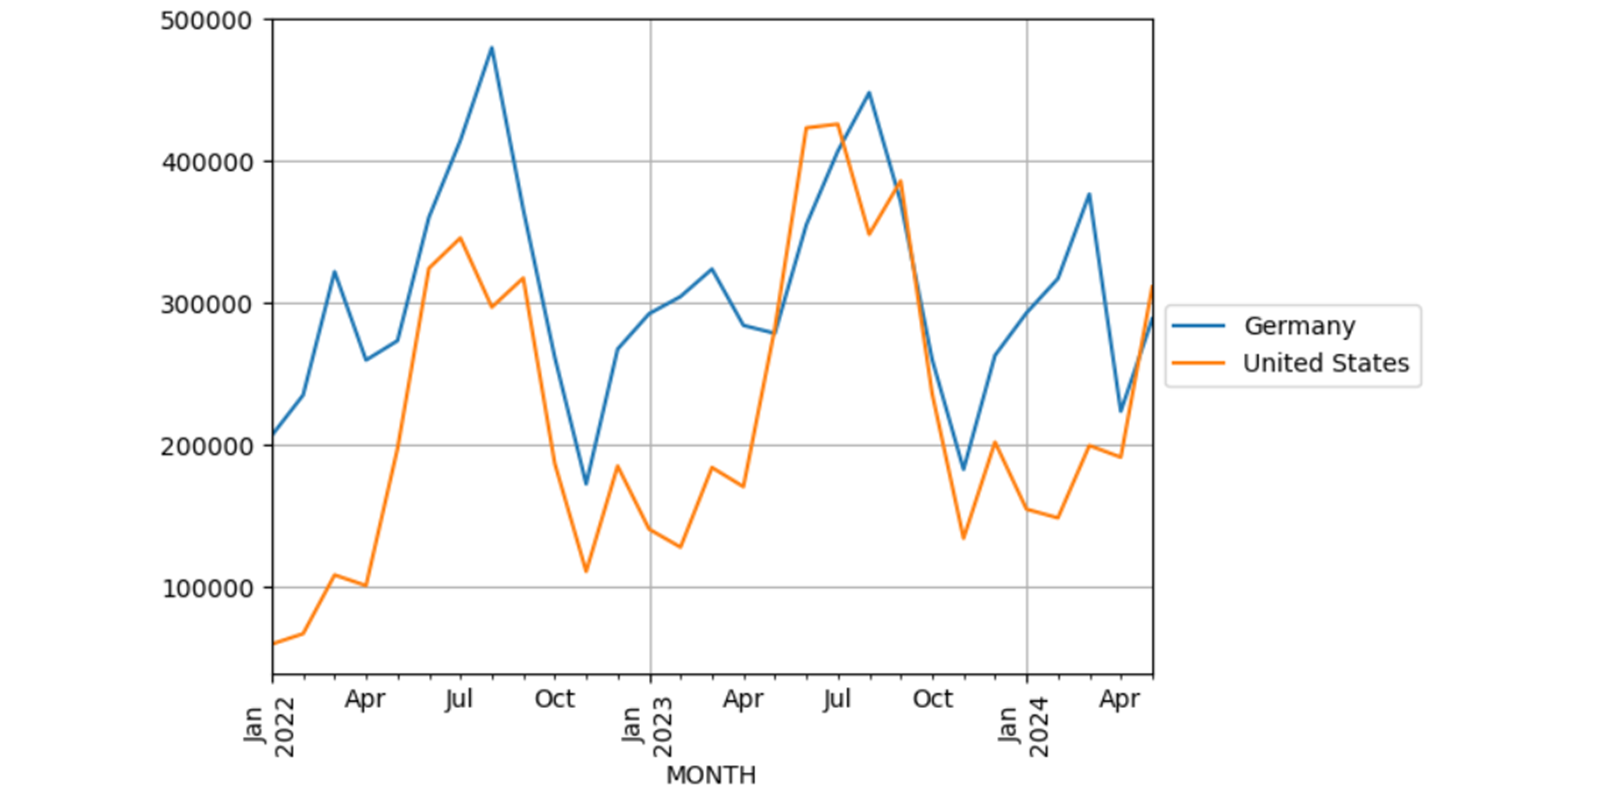
通过查看上面的情节,我们确定了两个国家/地区过夜停留中的相似之处,其中夏季更明显。
每个国家/地区的单独预测可以捕获此类单独的模式。