使用 SAP HANA 数据框架浏览和处理数据
学习目标
演示如何使用 SAP HANA DataFrame 对时间序列预测数据集进行格式设置、聚合和准备。
在构建预测模型之前,必须以与时间序列建模要求一致的方式准备和塑造数据。这包括将数据集加载到 SAP HANA,将字段转换为时间感知格式,以及执行基本聚合 - 全部使用 SAP HANA DataFrame API,从而在 Python 中启用 SQL 类操作。
加载时间序列数据集
过夜数据集可自由使用,可以从 [1] 上载,如下所示。使用以下代码,我们显示新创建的 Pandas DataFrame 的前五个观察。
更多与过夜场景相关的材料可以在同一个文件夹 [2] 中找到.
df_data= pd.read_csv('./OVERNIGHTSTAYS.csv', sep = ',')
df_data.MONTH = pd.to_datetime(df_data.MONTH, format='%d/%m/%Y')
df_data.head(5)
月份 |
地区 |
COUNTRYOFRESIDENCE |
OVERNIGHTSTAYS |
|
|---|---|---|---|---|
0 |
2022-01-01 |
格劳宾登州 |
瑞士 |
392805 |
1 |
2022 年 1 月 1 日 |
格劳宾登州 |
波罗的海国家 |
0 |
2 |
2022 年 1 月 1 日 |
格劳宾登州 |
德国 |
80648 |
3 |
2022 年 1 月 1 日 |
格劳宾登州 |
法国 |
4229 |
4 |
2022 年 1 月 1 日 |
格劳宾登州 |
意大利 |
10083 |
创建 SAP HANA 数据框架
SAP 函数 hana_ml.dataframe.create_dataframe_from_pandas() [3] 从 Pandas DataFrame 中创建 SAP HANA DataFrame 并在 SAP HANA 中创建表,即 table_name = 'OVERNIGHTSTAYS'。
然后,我们显示 SAP HANA DataFrame 的前五个观察,然后 DataFrame.collect() 将当前 DataFrame 复制到新的 Python Pandas DataFrame [4]。
df_remote = dataframe.create_dataframe_from_pandas(connection_context = conn,
pandas_df = df_data,
table_name = 'OVERNIGHTSTAYS',
force = True,
replace = False)
display(df_remote.head(5).collect())
100%|&1[00:01<00:00:00, 1.44s/it]
月份 |
地区 |
COUNTRYOFRESIDENCE |
OVERNIGHTSTAYS |
|
|---|---|---|---|---|
0 |
2022 年 1 月 1 日 |
格劳宾登州 |
瑞士 |
392805 |
1 |
2022 年 1 月 1 日 |
格劳宾登州 |
波罗的海国家 |
0 |
2 |
2022 年 1 月 1 日 |
格劳宾登州 |
德国 |
80648 |
3 |
2022 年 1 月 1 日 |
格劳宾登州 |
法国 |
4229 |
4 |
2022 年 1 月 1 日 |
格劳宾登州 |
意大利 |
10083 |
然后,我们按如下方式显示已创建表的结构:
输出:
[('MONTH', 'TIMESTAMP', 27, 27, 27, 0), ('REGION', 'NVARCHAR', 5000, 5000, 5000, 0), ('COUNTRYOFRESIDENCE', 'NVARCHAR', 5000, 5000, 5000, 0), ('OVERNIGHTSTAYS', 'INT', 10, 10, 0)]
将数据加载到 SAP HANA 数据框架
我们还可以显式将过夜数据加载到 SAP HANA DataFrame 中,如下所示。
然后,我们显示支持 DataFrame 的 SQL 查询。
最后,我们显示 DataFrame 的前六个观测对象。
hdf_overnightstays = conn.table('OVERNIGHTSTAYS')
display(hdf_overnightstays.select_statement)
display(hdf_overnightstays.head(6).collect())
'SELECT * FROM ''OVERNIGHTSTAYS'' '
月份 |
地区 |
COUNTRYOFRESIDENCE |
OVERNIGHTSTAYS |
|
|---|---|---|---|---|
0 |
2022 年 1 月 1 日 |
格劳宾登州 |
波罗的海国家 |
0 |
1 |
2022 年 1 月 1 日 |
格劳宾登州 |
澳大利亚、新西兰、大洋洲 |
0 |
2 |
2022 年 1 月 1 日 |
瑞士东部 |
波罗的海国家 |
0 |
3 |
2022 年 1 月 1 日 |
瑞士东部 |
澳大利亚、新西兰、大洋洲 |
0 |
4 |
2022 年 1 月 1 日 |
苏黎世州 |
波罗的海国家 |
0 |
5 |
2022 年 1 月 1 日 |
苏黎世州 |
澳大利亚、新西兰、大洋洲 |
0 |
计算数据集中的行数
接下来,DataFrame.count()****[5] 计算 SAP HANA DataFrame 中的行数并显示。
display(hdf_overnightstays.count())
29029
数据框架分析
数据操作和分析在数据科学领域至关重要。SAP 类方法 DataFrame.describe() 返回包含数据属性/列的各种统计信息的 DataFrame [6]。
此类描述性统计信息包括汇总数据集分布的中心趋势、分散和形状的统计信息。这有助于以有意义的方式组织和呈现数据。
例如,在下图中,标记为 3 的行显示 COUNTRYOFRESIDENCE 列的统计。此栏表示访客的居住国家/地区。我们注意到它有 29029 个观测项作为数据集的其他列。它没有空值,我们可能会记住它是基于字符的数据类型;但是,数值属性是第一列,即 OVERNIGHTSTAYS 列,可为其计算多个统计信息,即最小值、最大值、平均值、中值等。我们可能会记得,中间值是从数据集下半部分拆分后半部分的值 [7]。
hdf_overnightstays.describe().head(10).collect()
列 |
计数 |
唯一 |
空值 |
平均值 |
标准 |
分钟 |
最大 |
中值 |
25_percent_cont |
25_percent_disc |
50_percent_cont |
50_percent_disc |
75_percent_cont |
75_percent_disc |
|
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
0 |
OVERNIGHTSTAYS |
29029 |
5596 |
0 |
3307.070585 |
19415.55791 |
0.0 |
583762.0 |
269.0 |
58.0 |
58.0 |
269.0 |
269.0 |
1066.0 |
1066.0 |
1 |
月份 |
29029 |
29 |
0 |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
2 |
地区 |
29029 |
13 |
0 |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
3 |
COUNTRYOFRESIDENCE |
29029 |
77 |
0 |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
NaN |
4 行 × 15 列
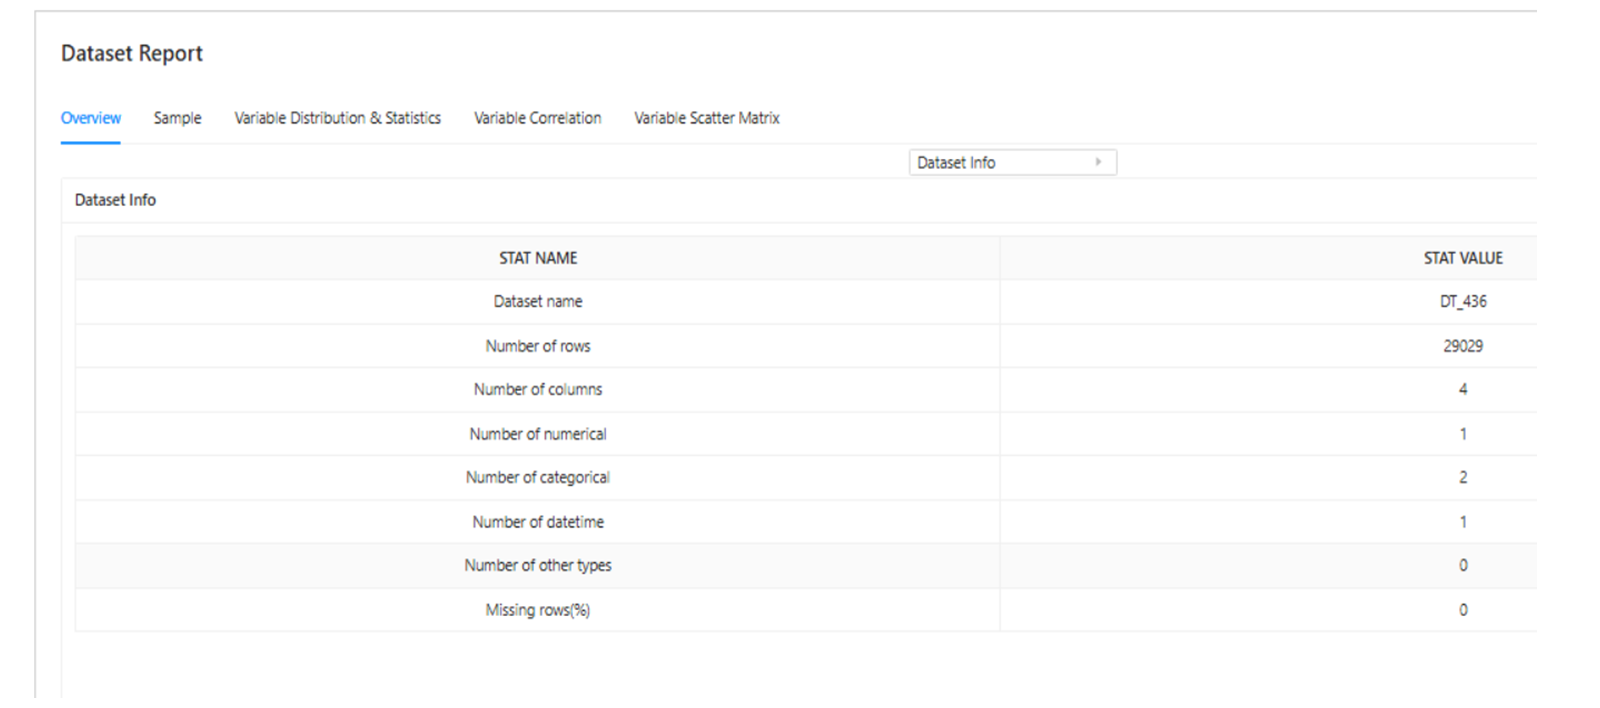
我们可以通过查看如下所示的图形报表浏览数据:
UnifiedReport(hdf_overnightstays).build().display()
警告:hana_ml.visualizers.unified_report: key 未设置。已将第一列视为索引列。
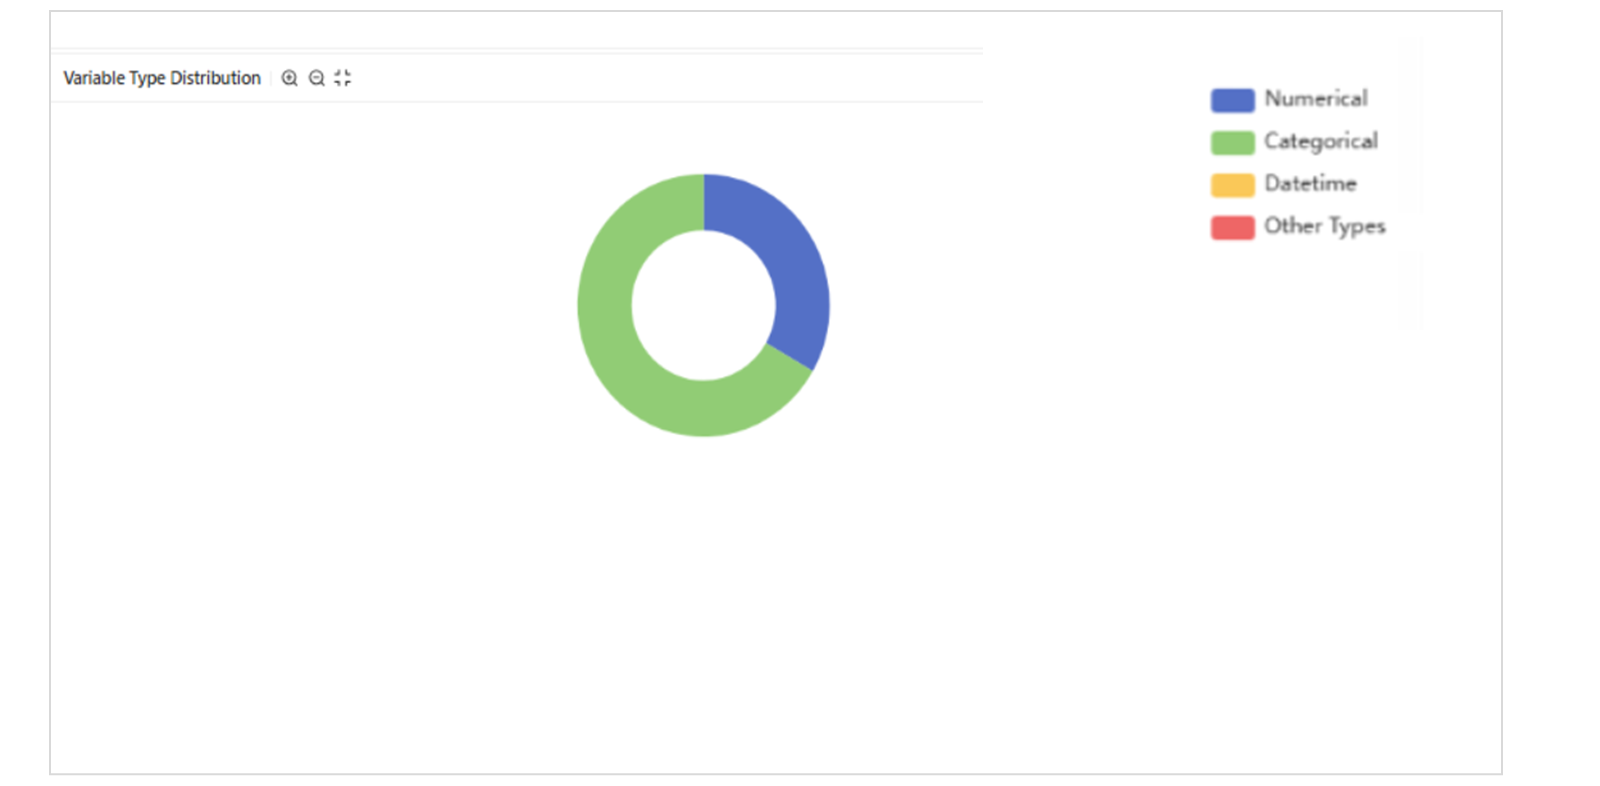
下图显示了"变量类型分布"图。
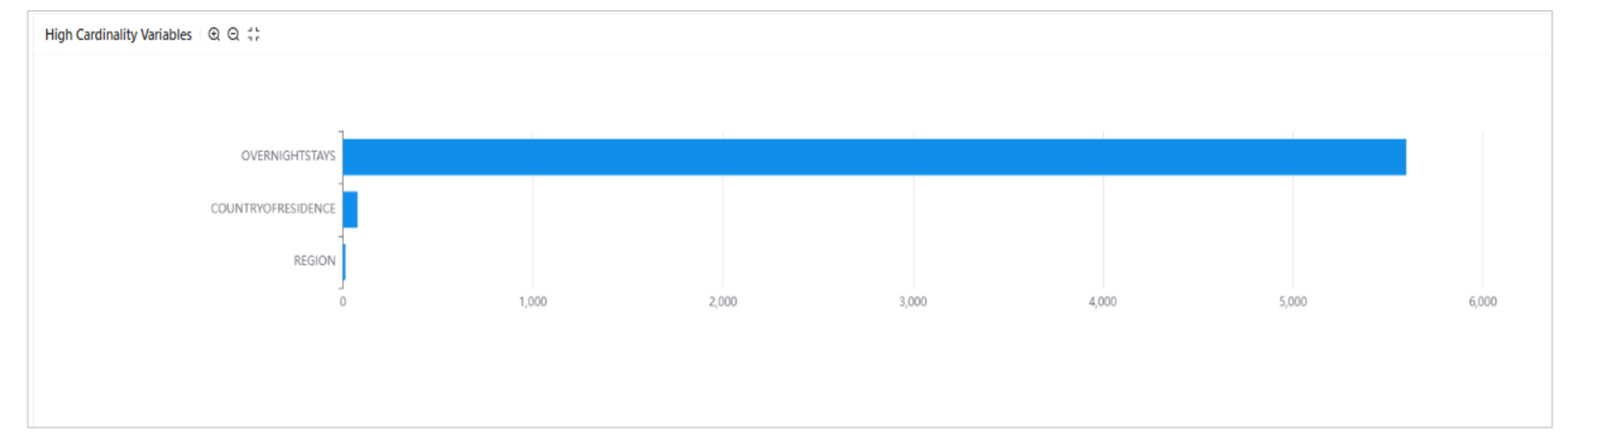
下图显示了"**高基数变量"**统计图。
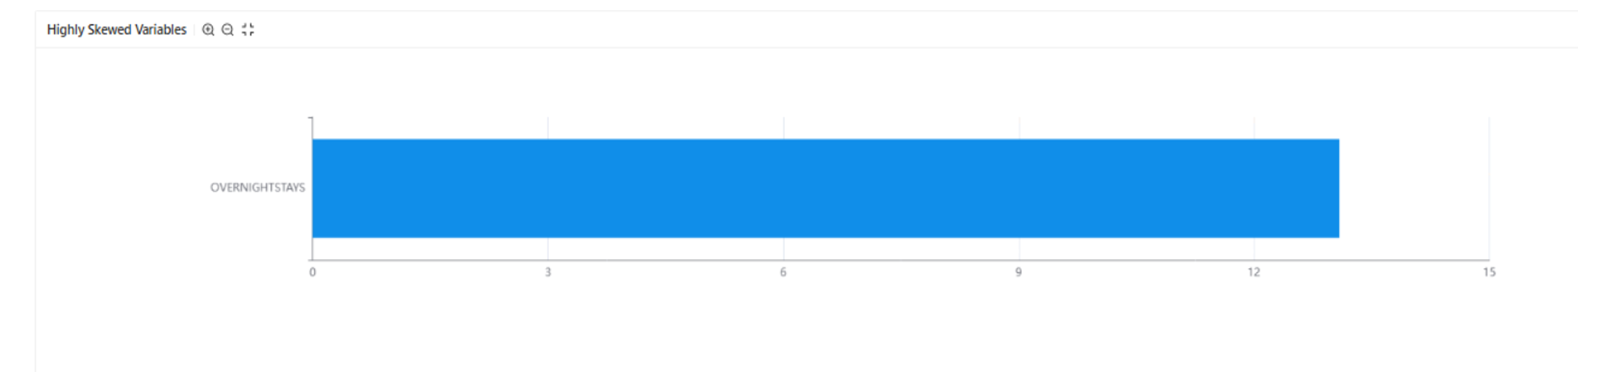
下图显示了"高度倾斜变量"统计图。
通过数据聚合进一步分析
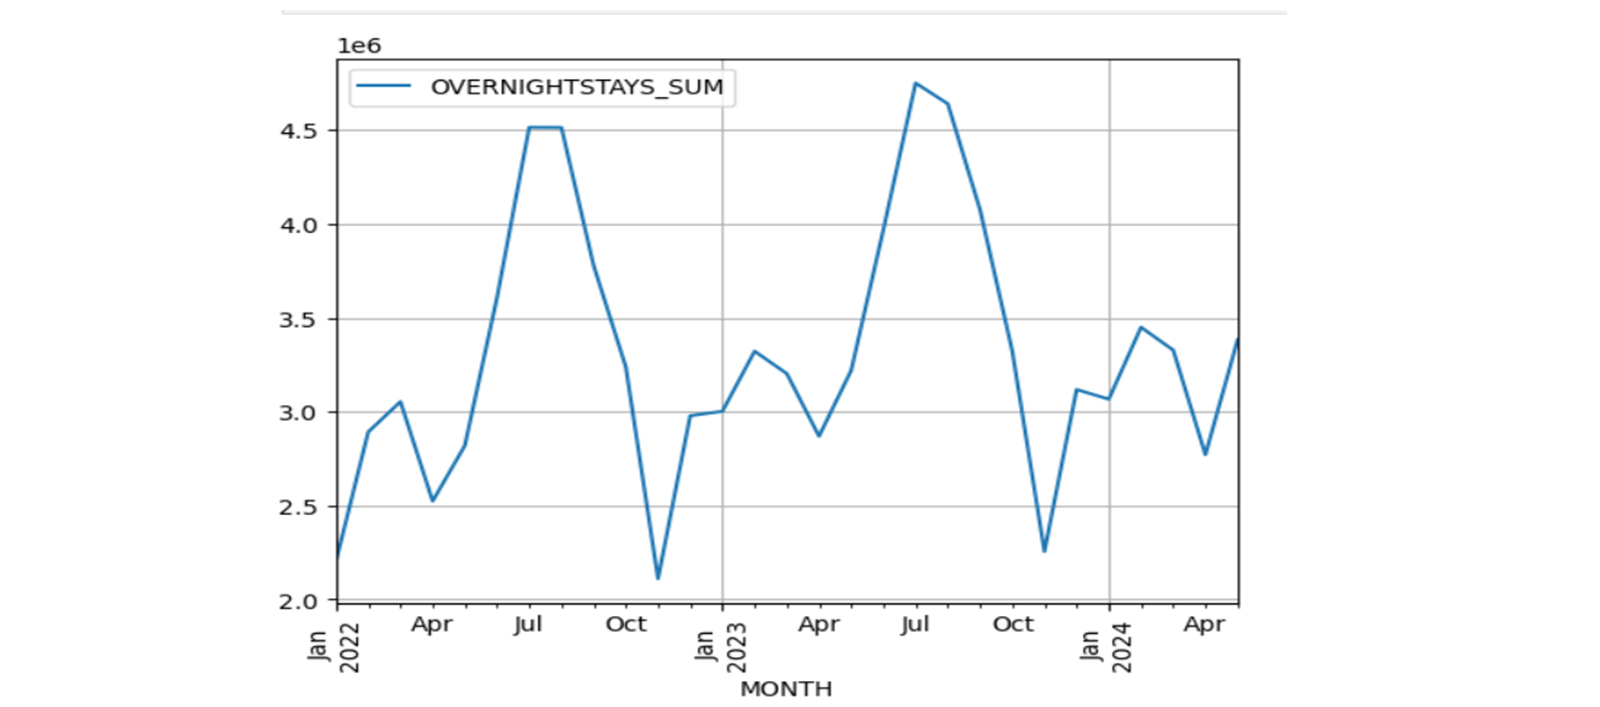
为了执行进一步的数据分析,我们需要按月汇总过夜,如下所示:
hdf_overnightstays_agg = hdf_overnightstays.agg([('sum', 'OVERNIGHTSTAYS', 'OVERNIGHTSTAYS_SUM')], group_by='MONTH')
hdf_overnightstays_agg = hdf_overnightstays_agg.sort('MONTH')
hdf_overnightstays_agg.head(5).collect()
月份 |
OVERNIGHTSTAYS_SUM |
|
|---|---|---|
0 |
2022 年 1 月 1 日 |
2204984 |
1 |
2022-02-01 |
2892697 |
2 |
2022-03-01 |
3053960 |
3 |
2022-04-01 |
2523861 |
4 |
2022-05-01 |
2820085 |
我们继续按如下方式绘制每月数据:
df_data = hdf_overnightstays_agg.collect()

df_data.plot(x='MONTH')
plt.xticks( rotation='vertical')
plt.show()
参考
[1]过夜住宿数据集
[2]过夜停留场景
[3]SAP 函数 hana_ml.dataframe.create_dataframe_from_pandas()
[4]SAP hana_ml.dataframe-DataFrame.collect()
[5]SAP hana_ml.dataframe-DataFrame.count()
[6]SAP hana.ml.dataframe-DataFrame.describe()
[7]统计信息:中值