在编排服务中实现文档基础化
学习目标
演示文档基础化在生成式 AI hub 中的实际应用。
您已经探索了文档基础化、向量嵌入和 SAP HANA 向量引擎的基础概念。
在本课中,您将了解如何利用生成式 AI hub 的编排服务来实现文档基础化。使用 RAG 方法,您将看到设置知识库并配置基础化模块以生成高度准确且与上下文相关的 AI 响应的分步过程。
在生成式 AI Hub 中实现文档基础化
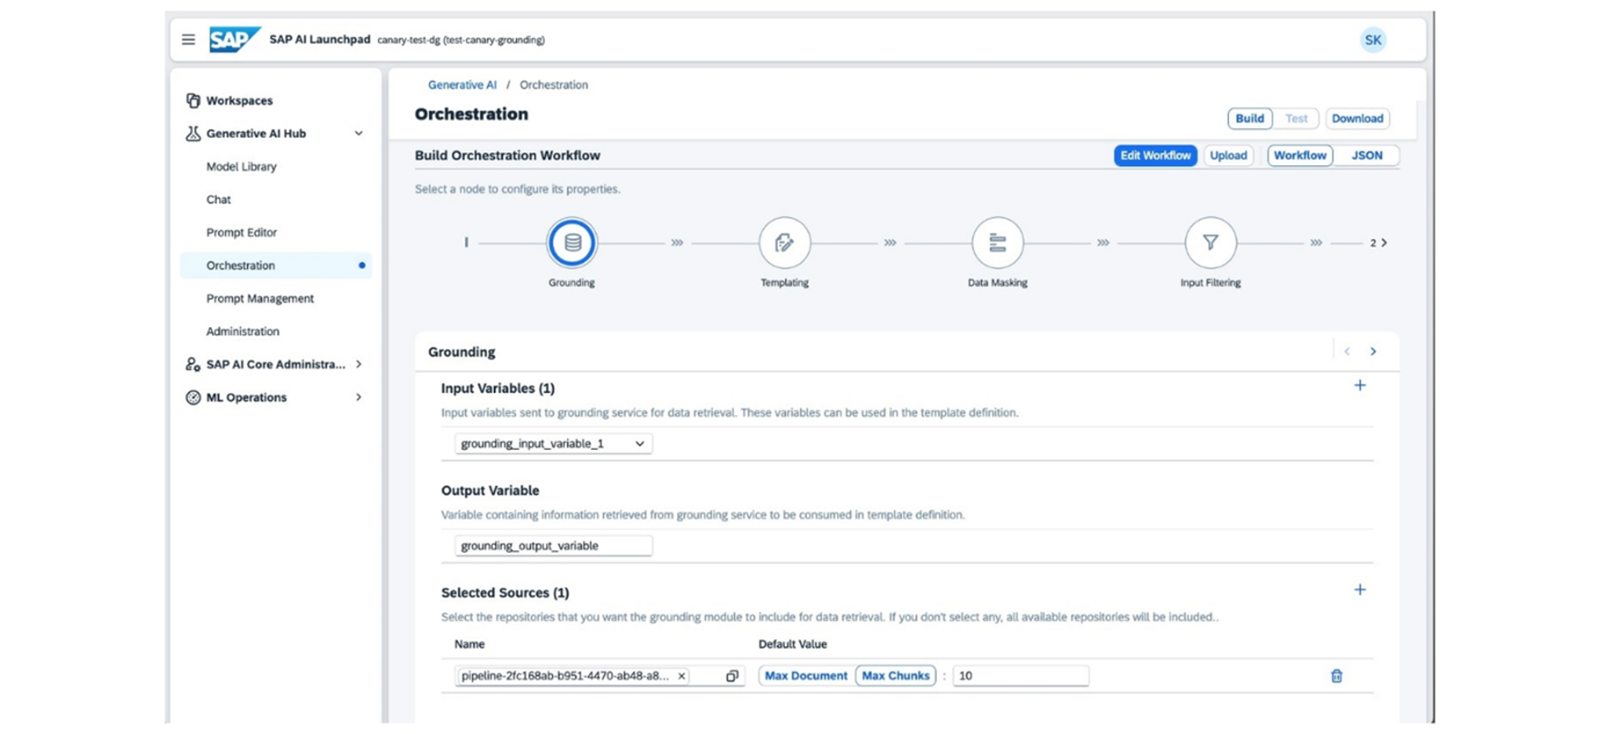
基础化能力是生成式 AI hub 的编排模块中不可或缺的一部分。该模块促进从向量数据库中进行专门的数据检索,确保 AI 的响应以外部、与上下文相关的信息为基础。此外,Pipeline API 集成了诸如托管式 SAP HANA 数据库之类的向量存储,后者可通过 SAP AI Core 在 SAP Generative AI Hub 中直接访问并运行。
SAP AI Launchpad 还提供 grounding management 应用,让您管理数据管道的生命周期。
生成式 AI hub 通过若干关键功能和精简的流程支持稳健的文档基础化:
访问多样的 LLM: 生成式 AI hub 提供对来自各提供者的广泛 LLM 的即时访问,包括 Azure OpenAI 模型(gpt-5)、Anthropic 模型(anthropic--claude-4-sonnet),以及 Mistral 和 Meta 模型等开源模型。这种广泛的访问使您能够编排多个 LLM,以最好地满足基础化和内容生成需求。要查看所有可用模型,请参阅 3437766 - Availability of Generative AI Models 。
与 SAP AI Launchpad 的无缝集成: 您可以直接在 SAP AI Launchpad 中执行和监控基础化的提示。这种集成展示了生成式 AI 结合您的业务数据如何直接协助业务流程,同时利用底层 SAP AI Core 基础设施进行安全运营。
高效的文档索引: 非结构化和半结构化文档会被预处理、划分为分块,并使用嵌入模型转换为数值嵌入。这些嵌入被高效地存储在 SAP HANA Vector Engine 中,以实现快速精确的查询,这是将 AI 响应建立在真实、相关数据之上的基础。
这些集成功能使您能够构建生成式 AI 解决方案,利用您组织可信的文档存储库,并提供可靠、透明且上下文准确的响应。
用于内容生成的基础化
使用 RAG 方法,您将利用编排服务中的文档基础化模块来有效地生成内容。该模块通过从知识库中检索相关文档,将用户查询与这些文档对齐。该知识库可以来自各种存储库,包括 SharePoint 文件夹、Elasticsearch 引擎或专用的向量数据存储库。
您需要执行以下步骤:
创建包含相关文档的知识库。
在编排服务中配置文档基础化模块。
基于知识库使用 RAG 方法生成内容。
前提条件
使用以下命令安装 SAP Cloud SDK for AI (Python) - generative:
%pip install "sap-ai-sdk-gen[all]"
为 SDK 设置凭证。
详细步骤
步骤 1:创建向量知识库
在编排管道中使用基础化模块之前,先准备好您的知识库。
生成式 AI hub 为用户提供了若干选项来准备其知识库数据:
将文档上传到受支持的数据存储库,然后运行数据管道以向量化这些文档。有关更多详细信息,请参阅 Pipeline API 。
使用 Vector API 直接提供文档的分块。有关更多信息,请参阅 Vector API 。
基础化模块选项
选择以下选项之一来使用基础化:
选项 1:将文档上传到受支持的数据存储库并运行数据管道
管道收集文档并将数据切分为分块。
它生成嵌入(即文本信息的多维表示),并将它们高效地存储在向量数据库中。
该过程包含以下步骤:
执行一次性的初始管理步骤: 为基础化创建资源组和通用密钥。有关更多信息,请参阅:
Create a Resource Group for Grounding
Grounding Generic Secrets for Microsoft SharePoint
准备向量知识库: 配置 Pipeline API 以从数据存储库读取非结构化数据并将其存储到向量数据库中。使用 Pipeline API 来:
从各种数据存储库读取非结构化文档。将数据切分为分块并创建嵌入。
将文本信息的多维表示存储到向量数据库中。
提供一个存储库 ID 以访问数据。 有关更多信息,请参阅Preparing Data Using the Pipeline API。
选项 2:直接通过 Vector API 提供文档分块
直接提供数据分块并使用 Vector API 存储它们。该过程包含以下步骤:
执行一次性的初始管理步骤: 创建用于基础化的资源组 。
准备向量知识库: 直接提供信息分块,并使用 Vector API 将数据存储到向量数据库中。使用 Vector API 来:
创建集合。
直接使用用户提供的数据分块创建文档。
将数据存储到向量数据库中。
分配存储库 ID 以访问数据。
有关更多信息,请参阅 Preparing Data Using the Vector API 。
在编排中配置基础化模块: 在编排管道中,为基础化请求添加配置:
使用存储库 ID 和过滤器在编排管道中创建基础化请求配置。
运行编排管道并检查响应是否引用了用户数据。有关更多信息,请参阅 Using the Grounding Module 。
步骤 2:配置文档基础化模块
现在,您必须为文档基础化模块定义配置,包括设置过滤器和指定数据存储库。
orchestration_service_url = <your url code from deployment of the orchestration service>
您必须至少有一个正在运行的、与编排兼容的生成式 AI 模型部署。有关更多信息,请参阅 Create a Deployment for Orchestration in SAP AI Core。
接下来,您必须导入所有相关库。请在此处的代码存储库中查看代码。
# Set up the Orchestration Service
aicore_client = get_proxy_client().ai_core_client
orchestration_service = OrchestrationService(api_url=orchestration_service_url)
llm = LLM(
name="gpt-4o",
parameters={
'temperature': 0.0,
}
)
template = Template(
messages=[
SystemMessage("""Facility Solutions Company provides services to luxury residential complexes, apartments,
individual homes, and commercial properties such as office buildings, retail spaces, industrial facilities, and educational institutions.
Customers are encouraged to reach out with maintenance requests, service deficiencies, follow-ups, or any issues they need by email.
"""),
UserMessage("""You are a helpful assistant for any queries for answering questions.
Answer the request by providing relevant answers that fit to the request.
Request: {{ ?user_query }}
Context:{{ ?grounding_response }}
"""),
]
)
这段 Python 代码设置了一个对处理复杂任务至关重要的编排服务。它初始化 AI Core 客户端,并使用给定的 URL 配置编排服务。代码随后设置带有特定参数的 LLM,以确保响应一致。最后,它创建一个消息模板,以帮助高效且有效地回答客户咨询。
接下来,我们设置基础化服务。
# Set up Document Grounding
filters = [DocumentGroundingFilter(id="vector",
data_repositories=["<add your data repository ID>"],  ,
search_config=GroundingFilterSearch(max_chunk_count=15),
data_repository_type=DataRepositoryType.VECTOR.value
)
]

grounding_config = GroundingModule(
type="document_grounding_service",
config=DocumentGrounding(input_params=["user_query"], output_param="grounding_response", filters=filters)
)

config = OrchestrationConfig(
template=template,
llm=llm,
grounding=grounding_config
)
这段 Python 代码设置并配置文档基础化服务。它定义文档存储库的过滤器并指定搜索参数。基础化配置随后被集成到编排系统中,该系统使用模板和语言模型来处理并响应用户查询。此设置确保基于用户输入进行高效准确的文档检索。
步骤 3:生成与上下文相关的答案
使用配置好的设置运行编排服务,以基于用户查询生成答案。
response = orchestration_service.run(config=config,
template_values=[
TemplateValue("user_query", "List the issues that are reported by customers."),
])
print(response.orchestration_result.choices[0].message.content)
这段 Python 代码向编排服务发送请求以运行特定配置。它包含一个模板值,其中的用户查询要求列出客户报告的问题。运行服务后,它打印编排结果中的响应,具体是第一个选择项的消息内容。这有助于高效地自动获取客户问题数据。
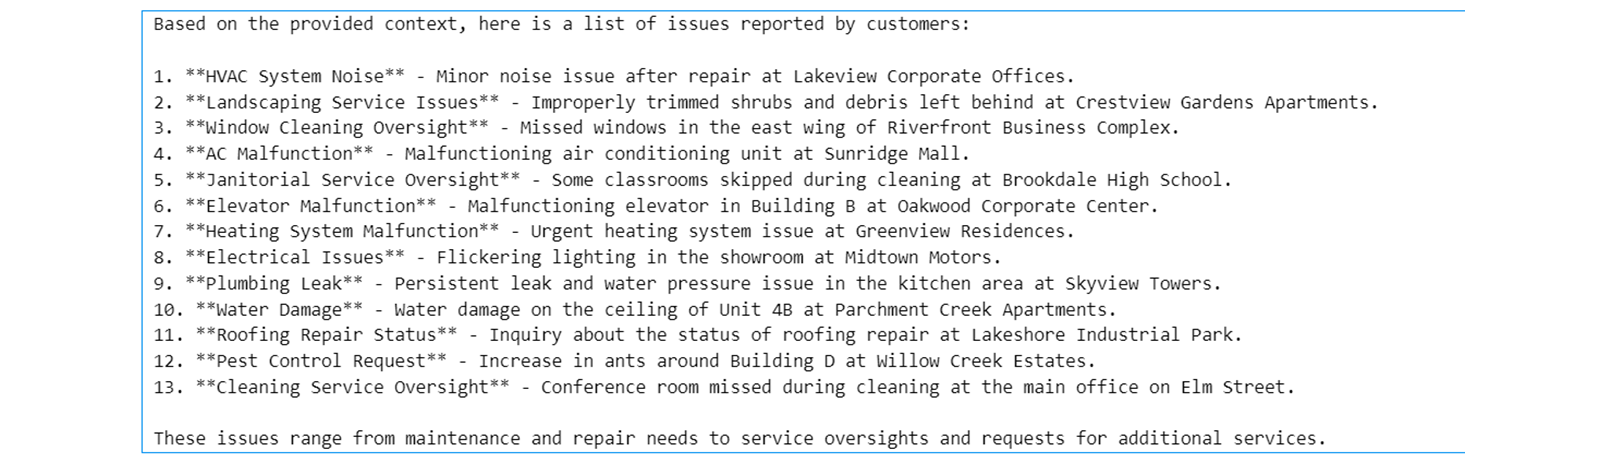
您会得到以下输出:
您可以看到客户报告的问题列表,它以客户提供的邮件为基础。
您可以看到从数据存储库中为上下文检索到的文档。
print(response.module_results.grounding.data['grounding_result'])
这段代码从 'response' 对象内的嵌套数据结构中提取并显示 'grounding_result' 的值。这项特定数据对于理解基础化模块的结果可能至关重要,使该代码对调试或分析必不可少。
输出列出了先前用于响应的所有相关邮件,提供了对基础化技术上下文的深入洞察。您可以在存储库中看到此输出。
结论
在本课中,您完成了以下关键任务:
建立向量知识库: 您学会了上传文档并将其向量化,形成一个稳健、可搜索的知识库。
配置文档基础化模块: 您在编排服务中设置了该模块,以基于用户查询智能地检索相关文档。
生成有依据的 AI 响应: 您利用编排服务生成了准确且与上下文相关的答案,展示了基础化的强大能力。
本课小结
在您对文档基础化的基础概念、向量嵌入、SAP HANA 向量引擎和 RAG 的理解之上,本课提供了对实现过程的实用深入探讨。您成功学会了建立向量知识库、在生成式 AI Hub 的编排服务中配置文档基础化模块,并生成准确、与上下文相关的 AI 响应。这一端到端的体验巩固了基础化如何通过将精确的外部数据集成到您的解决方案中,显著增强 AI 的可靠性与相关性。
本课程提供了对一种用于解决业务问题的基础化技术的全面概念与实践覆盖。
学习之旅小结
在整个学习之旅中,您首先发现了 SAP Business AI 的重要性,以及它如何通过自动化流程、增强决策和支持可扩展、负责任的创新来应对业务挑战。
随后您探索了 LLM 的基础知识、它们如何运作、其显著优势和固有限制。您看到了 LLM 如何大规模地自动化任务、生成内容和综合信息,也看到了为什么必须有意识地使用它们,并意识到幻觉、偏见和数据隐私等风险。您发现实用的提示工程是引导 LLM 提供相关且可靠结果的关键。
接着您深入了解了 SAP 的生成式 AI hub——AI Foundation 的一部分,理解了它如何成为通往企业级 AI 的安全网关。该 hub 使您能够访问和编排领先的 LLM、管理提示,并自信地将 AI 集成到业务流程中。它确保您的解决方案以真实业务上下文为基础、通过稳健的安全与合规而可靠,并且设计上负责任。
在此基础上,您学习了使用 LLM 解决真实业务问题的实用技术,从提示开发和改进,到使用 SDK 将提示集成到应用程序中。您理解了提示工程、版本控制和评估的艺术,确保您的 AI 解决方案准确、可操作且可扩展。这种可扩展性通过在生成式 AI hub 中创建和管理提示模板来支持。少样本提示和元提示等高级技术进一步提升了 AI 输出的质量和一致性,使您能够应对更复杂的场景。
最后,您发现了文档基础化如何将 LLM 连接到您组织可信的知识源,确保响应准确且具备上下文感知。通过利用 SAP HANA Vector Engine 和嵌入模型,您可以将文档转换为可搜索的向量,从而实现语义搜索和 RAG。基础化将幻觉降至最低,并使 AI 输出与真实业务事实保持一致,让您的解决方案更加可信和有效。
总之,您现在已具备设计、构建和部署智能、可靠且面向业务的 AI 解决方案的能力,将 LLM 的强大能力、稳健的提示工程和 SAP Business AI 结合起来,以推动真正的价值与创新。
本课其余配图