使用 SAP HANA PAL 构建单变量预测模型
学习目标
应用 SAP HANA PAL 在过夜数据集上训练单变量时间序列模型。
在本课中,您将使用 SAP HANA 预测分析库 (PAL) 中的 AdditiveModelForecast 算法训练单变量时间序列预测模型。您将使用每月聚合过夜作为输入数据,并使用训练的 SAP HANA PAL 模型预测未来值。这是使用 SAP HANA 进行操作时间序列预测的基础步骤。
面向 SAP HANA 的 Python 机器学习客户端 (hana-ml) 公开所有 SAP HANA 预测分析库 (PAL) 函数以及 Python 中的自动预测库 (APL) 函数,以便基于 SAP HANA DataFrame 输入数据使用。
接下来,我们通过使用 AdditiveModelForecast 算法 [1] 在每月聚合上训练时间序列模型。
amf = AdditiveModelForecast()
amf.fit(data=hdf_overnightstays_agg)
<hana_ml.algorms.pal.tsa.additive_model_forecast.AdditiveModelForecast,网址为 0x1d9bdeefb00>
附加模型时间序列分析使用附加模型来预测时间序列数据。它处理具有强烈季节性影响的数据,并可用于改变历史趋势。
相加模型时间序列分析(也称为"先知")使用具有三个主要组件的可分解时间序列模型:趋势、季节性和假期或事件。
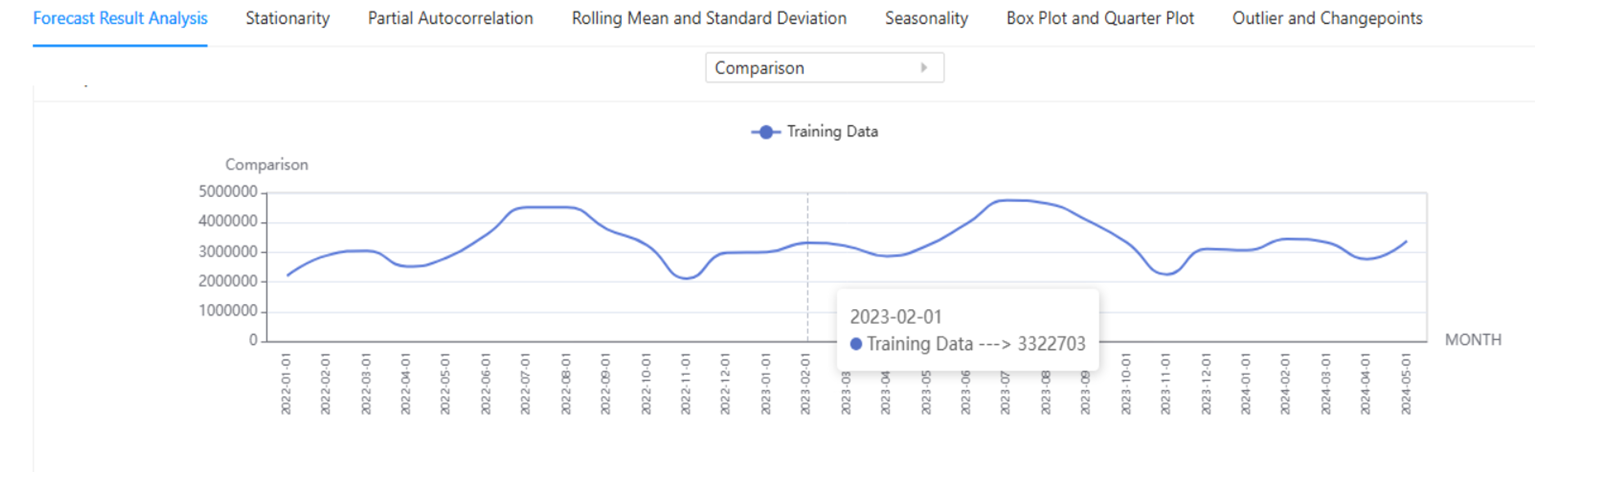
我们可以通过查看如下所示的图形报表来浏览经过训练的模型:
UnifiedReport(amf).build().display()
100%|&1,&3,8.57 年
创建用于预测的 SAP HANA 数据框架
到目前为止,我们未创建预测。为了创建预测,我们首先需要创建一个 SAP HANA DataFrame,其中包含我们希望预测的日期/月份。
因此,我们需要了解下面显示的训练数据集的最近日期。
str_lastdate = hdf_overnightstays_agg.tail(1, ref_col='MONTH').collect().iloc[0,0]
str_lastdate = str(str_lastdate)[0:10]
print(str_lastdate)
2024-05-01
接下来,根据上面显示的上一个已知日期/月份,我们创建了一个新的 SAP HANA 数据框架,其中显示接下来的 12 个月。
months_to_forecast=12

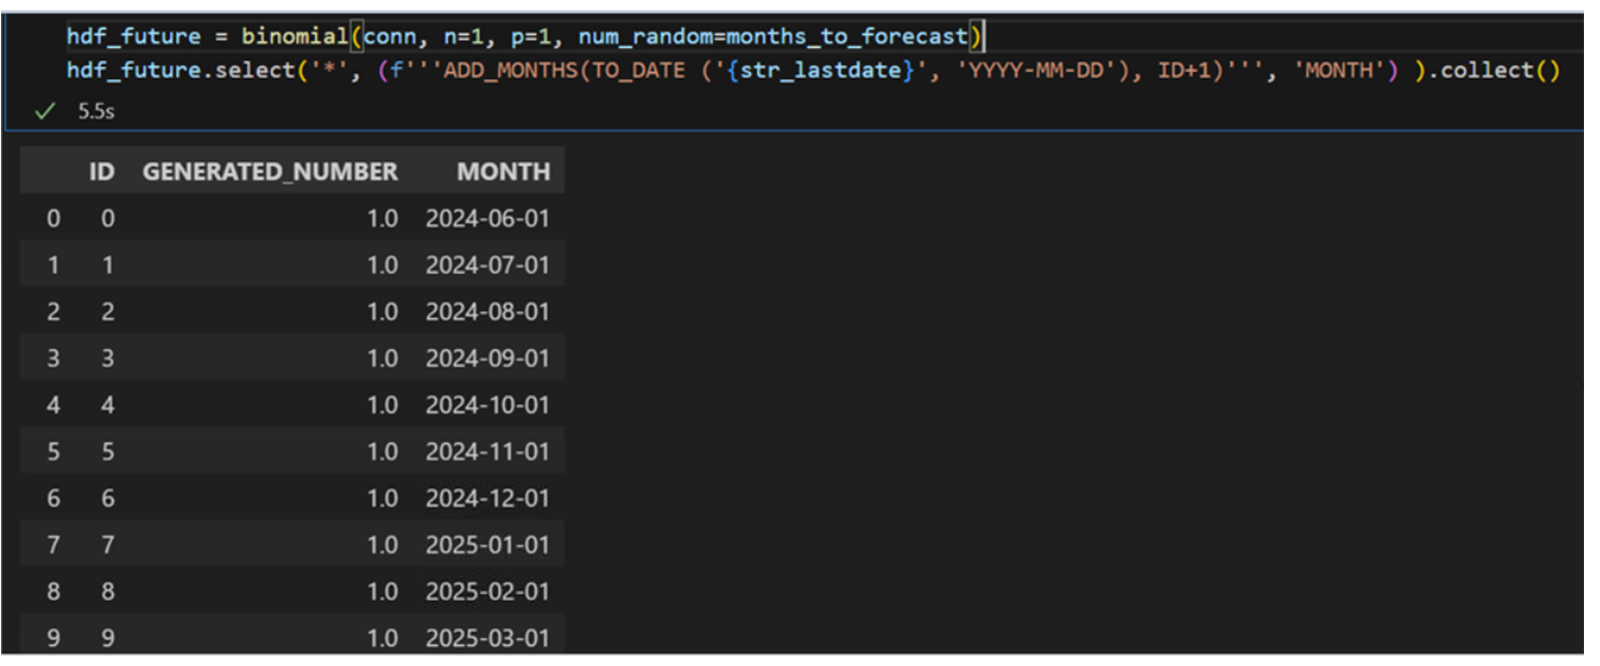
hdf_future = binomial(conn, n=1, p=1, num_random=months_to_forecast)
hdf_future = hdf_future.select('*', (f'''ADD_MONTHS(TO_DATE ('{str_lastdate}', 'YYYY-MM-DD'), ID+1)''', 'MONTH') )
hdf_future = hdf_future.select('MONTH', ('0', 'TARGET'))
hdf_future.head(20).collect()
月份 |
目标 |
|
|---|---|---|
0 |
2024-06-01 |
0 |
1 |
2024-07-01 |
0 |
2 |
2024-08-01 |
0 |
3 |
2024-09-01 |
0 |
4 |
2024-10-01 |
0 |
5 |
2024-11-01 |
0 |
6 |
2024-12-01 |
0 |
7 |
2025-01-01 |
0 |
8 |
2025-02-01 |
0 |
9 |
2025-03-01 |
0 |
10 |
2025-04-01 |
0 |
11 |
2025-05-01 |
0 |
请注意在代码中使用二进制:
二项式是一个函数,旨在直接在 SAP HANA 数据库中按照二项分布生成随机数。生成的两列为 ID 和 GENERATED_NUMBER。
根据赋予函数的参数,我们可以理解生成的数字始终为 1.0,这实际上不用于我们在此单元格中的目的。有用的列是 ID,它是从 0 到 11 的连续编号(与 12 个生成的随机数相关联)。
列标识很有用,因为该数字汇总为训练数据集的 last_date,因此用于计算预测日期。可以看到由"ID+1"汇总的训练数据集的 last_date 成为 MONTH 列中的值,然后用于预测。
总之,二项式的使用是创建预测时戳的中间步骤(技术步骤,而非科学步骤)。
应用训练模型
之后,我们应用训练的时间序列模型来预测未来 12 个月的过夜。
hdf_predicted = amf.predict(data=hdf_future)
hdf_predicted.head(5).collect()
月份 |
YHAT |
YHAT_LOWER |
YHAT_UPPER |
|
|---|---|---|---|---|
0 |
2024-06-01 |
3.892362e+06 |
3.818124e+06 |
3.963618e+06 |
1 |
2024-07-01 |
4.786169e+06 |
4.713556e+06 |
4.852429e+06 |
2 |
2024-08-01 |
4.817140e+06 |
4.743560e+06 |
4.891867e+06 |
3 |
2024-09-01 |
3.776572e+06 |
3.702854e+06 |
3.850597e+06 |
4 |
2024-10-01 |
3.535125e+06 |
3.459114e+06 |
3.610827e+06 |
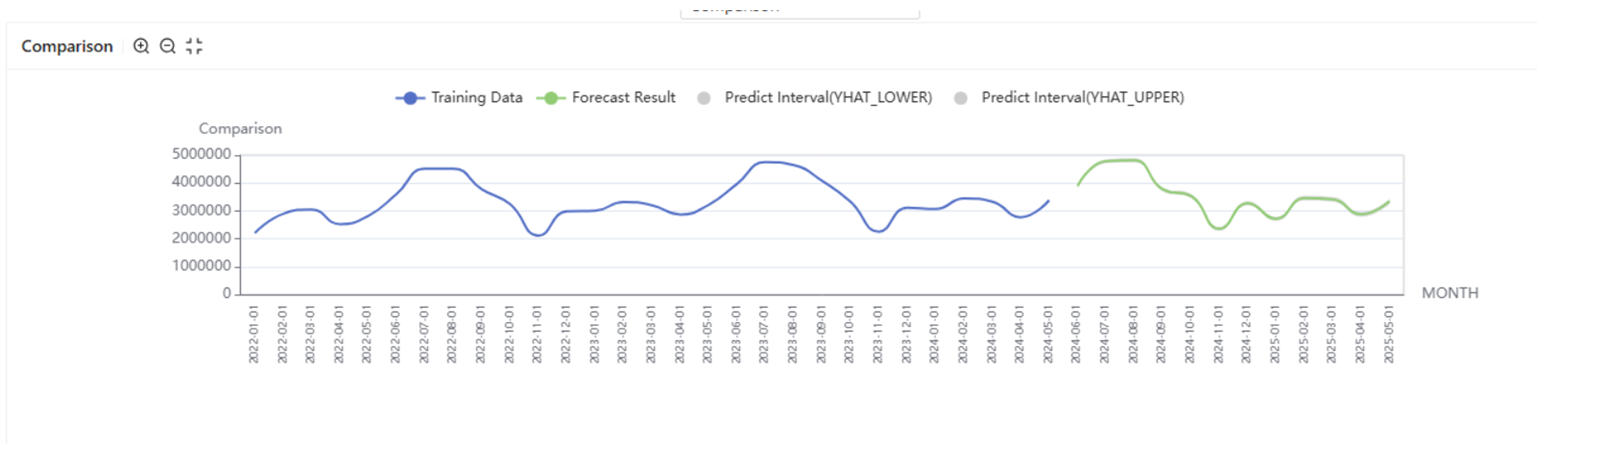
我们在图形报表中可视化预测,如下所示。
我们清楚地观察到训练数据集中识别的重复模式。大部分过夜都在夏天,但冬季也有它的峰值。
UnifiedReport(amf).build().display()
100%|&1&3,&3,&3,8.44 秒
在 SAP HANA 数据框架中组合历史值和预测值
最后,我们将历史数据集和预测值合并到单个 SAP HANA DataFrame 中,如下所示。
要创建时间序列的完整连续视图,可以将历史数据与未来的预测相结合。此合并数据集可用于可视化趋势、与业务利益相关方共享或使 SAP Analytics Cloud 等系统可以访问数据。
hdf_predicted = hdf_predicted.select('MONTH',
('NULL', 'OVERNIGHTSTAYS_SUM'),
('YHAT', 'FORECAST'),
('YHAT_LOWER', 'FORECAST_LOWER'),
('YHAT_UPPER', 'FORECAST_UPPER'))
hdf_overnightstays_agg = hdf_overnightstays_agg.select('*',
('NULL', 'FORECAST'),
('NULL', 'FORECAST_LOWER'),
('NULL', 'FORECAST_UPPER'))
hdf_all = hdf_predicted.union(hdf_overnightstays_agg)
hdf_all.sort('MONTH').tail(5).collect()
月份 |
OVERNIGHTSTAYS_SUM |
预测 |
FORECAST_LOWER |
FORECAST_UPPER |
|
|---|---|---|---|---|---|
0 |
2025-01-01 |
无 |
2.719344e+06 |
2.644614e+06 |
2.794261e+06 |
1 |
2025-02-01 |
无 |
3.456029e+06 |
3.376482e+06 |
3.543326e+06 |
2 |
2025-03-01 |
无 |
3.412205e+06 |
3.326795e+06 |
3.500738e+06 |
3 |
2025-04-01 |
无 |
2.878771e+06 |
2.786906e+06 |
2.965247e+06 |
4 |
2025-05-01 |
无 |
3.346712e+06 |
3.245006e+06 |
3.435816e+06 |
或者,我们可以将合并的数据集保存到 SAP HANA Cloud 中的表。例如,SAP Analytics Cloud 可以访问此类数据。
hdf_all.save('OVERNIGHTSTAYS_FORECAST_TOTAL', force=True)
<0x1d9c242e0c0 上的 <hana_ml.dataframe.DataFrame>