在 ABAP SQL 中排序和压缩数据集
学习目标
从数据库请求排序的结果集。
检索压缩数据集和聚合数据集。
排序的结果集
在本视频中,您将了解如何对 SELECT 语句的结果集进行排序。
视频:本节含 SAP 官方视频(视频 ID
1_dp1fdf52),需在 learning.sap.com 在线观看。
试用:ORDER BY
创建实施接口 IF_OO_ADT_CLASSRUN 的新全局类。
将以下代码片段复制到方法 if_oo_adt_classrun~main() 的实施部分:
SELECT FROM /dmo/flight
FIELDS carrier_id,
connection_id,
flight_date,
seats_max - seats_occupied AS seats
WHERE carrier_id     = 'AA'
AND plane_type_id  = 'A320-200'
*       ORDER BY seats_max - seats_occupied DESCENDING,
*                flight_date                ASCENDING
INTO TABLE @DATA(result).
out->write(
EXPORTING
data   = result
name   = 'RESULT'
).
选择 CTRL + F3 激活类,然后选择 F9 将其作为控制台应用执行。
分析控制台输出。
使用 ORDER BY 附加项移除行中的星号 (*),然后再次激活。
再次执行 并查看控制台输出的排序顺序如何更改。
使用 ORDER BY 附加功能进行导航。更改排序方向,按其他字段或表达式对结果进行排序以熟悉语法。
唯一结果集
附加项 DISTINCT 允许您从 SELECT 语句的结果集中删除重复项。附加必须放在字段列表第一个元素的前面。
观看此视频,了解如何操作。
视频:本节含 SAP 官方视频(视频 ID
1_0ipn4c81),需在 learning.sap.com 在线观看。
试用:SELECT DISTINCT
创建实施接口 IF_OO_ADT_CLASSRUN 的新全局类。
将以下代码片段复制到方法 if_oo_adt_classrun~main() 的实施部分:
SELECT FROM /dmo/connection
FIELDS
*           DISTINCT
airport_from_id,
distance_unit
ORDER BY airport_from_id
INTO TABLE @DATA(result).
out->write(
EXPORTING
data   = result
name   = 'RESULT'
).
选择 CTRL + F3 激活类,然后选择 F9 将其作为控制台应用执行。
分析控制台输出。
移除带有 DISTINCT 附加项的行中的星号 (*),然后再次激活。
再次执行 并查看控制台输出如何更改。
集合函数
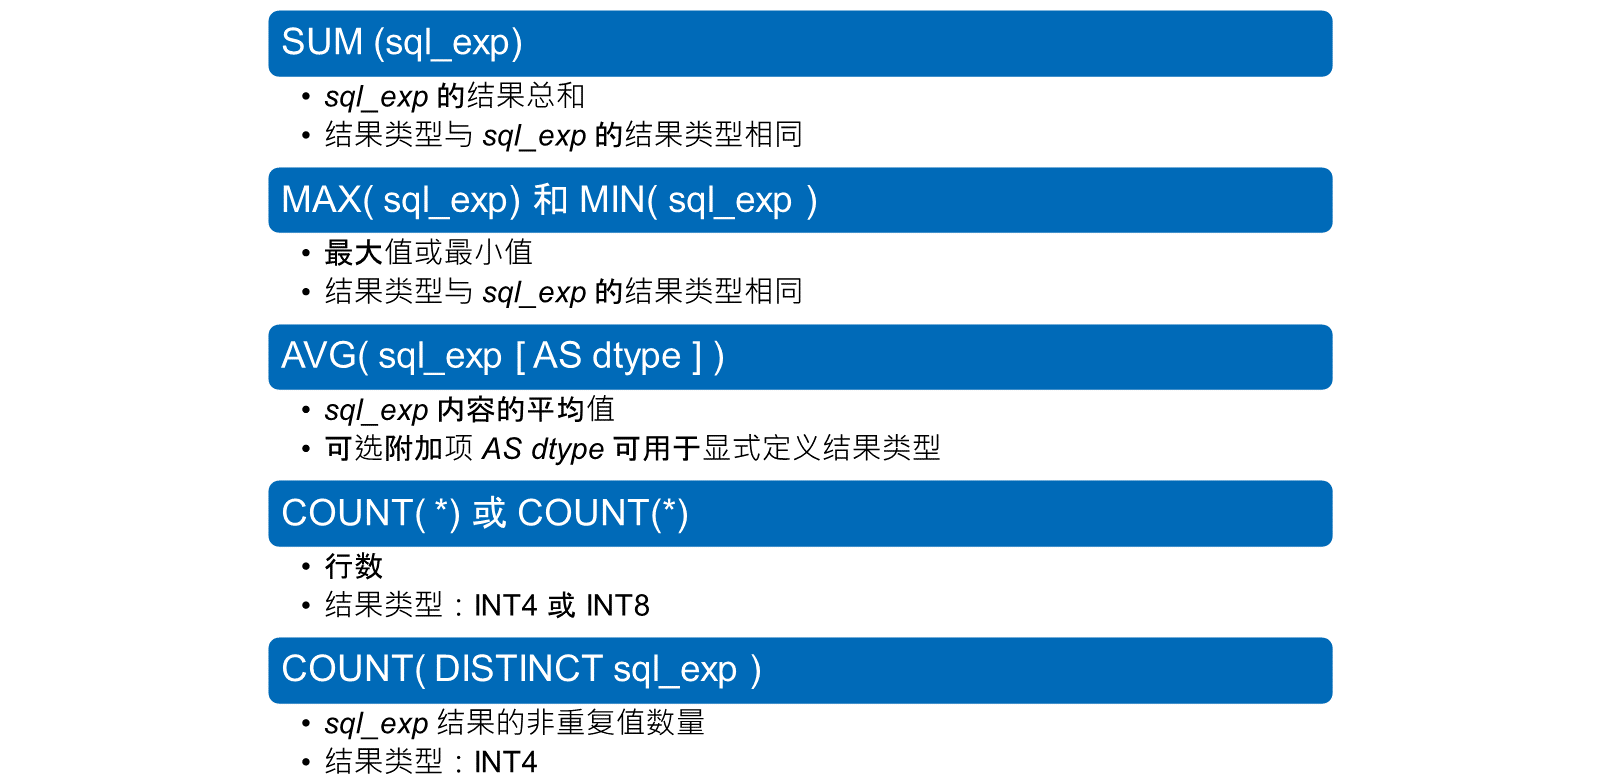
集合表达式通过对结果集的多行调用集合函数,从 sql_expression (sql_exp) 计算单个值。
一些重要的聚合函数包括:
SUM( sql_exp) 确定行集中 SQL 表达式 sql_exp 的结果总和。结果集的数据类型是 SQL 表达式的类型。SQL 表达式 sql_exp 的结果类型必须是数值类型。
MIN( sql_exp) 和 MAX( sql_exp ) 确定行集中 SQL 表达式 sql_exp 结果的最大值或最小值。结果的数据类型是 SQL 表达式的结果类型。 SQL 表达式 sql_exp 的结果必须是数值类型。如果为表达式指定了单个列,则此列也可以具有任何数据类型。
AVG( sql_exp [ AS dtype ] ) 确定行集中 SQL 表达式 sql_exp 内容的平均值。十进制浮点数结果的隐式数据类型是相应的数据类型(DECFLOAT16 或 DECFLOAT34 或 DF16_DEC 或 DF34_DEC),否则为 FLTP 类型,或由附加项 AS 数据类型确定。
COUNT( ) 或 COUNT() 这两个拼写具有相同的含义,并生成行集中的行数。大多数情况下,结果类型为 INT4。如果 COUNT( ) 或 COUNT() 是字段列表中的唯一元素,则结果类型为 INT8。
COUNT( DISTINCT sql_exp ) 确定行集中 SQL 表达式 sql_exp 结果的非重复值数量。结果的数据类型为 INT4。
仅字段清单中的聚合功能
如果 SELECT 语句的字段列表仅包含集合函数,则结果集始终仅包含一行。请注意,如果聚合基于空数据集,也是如此。
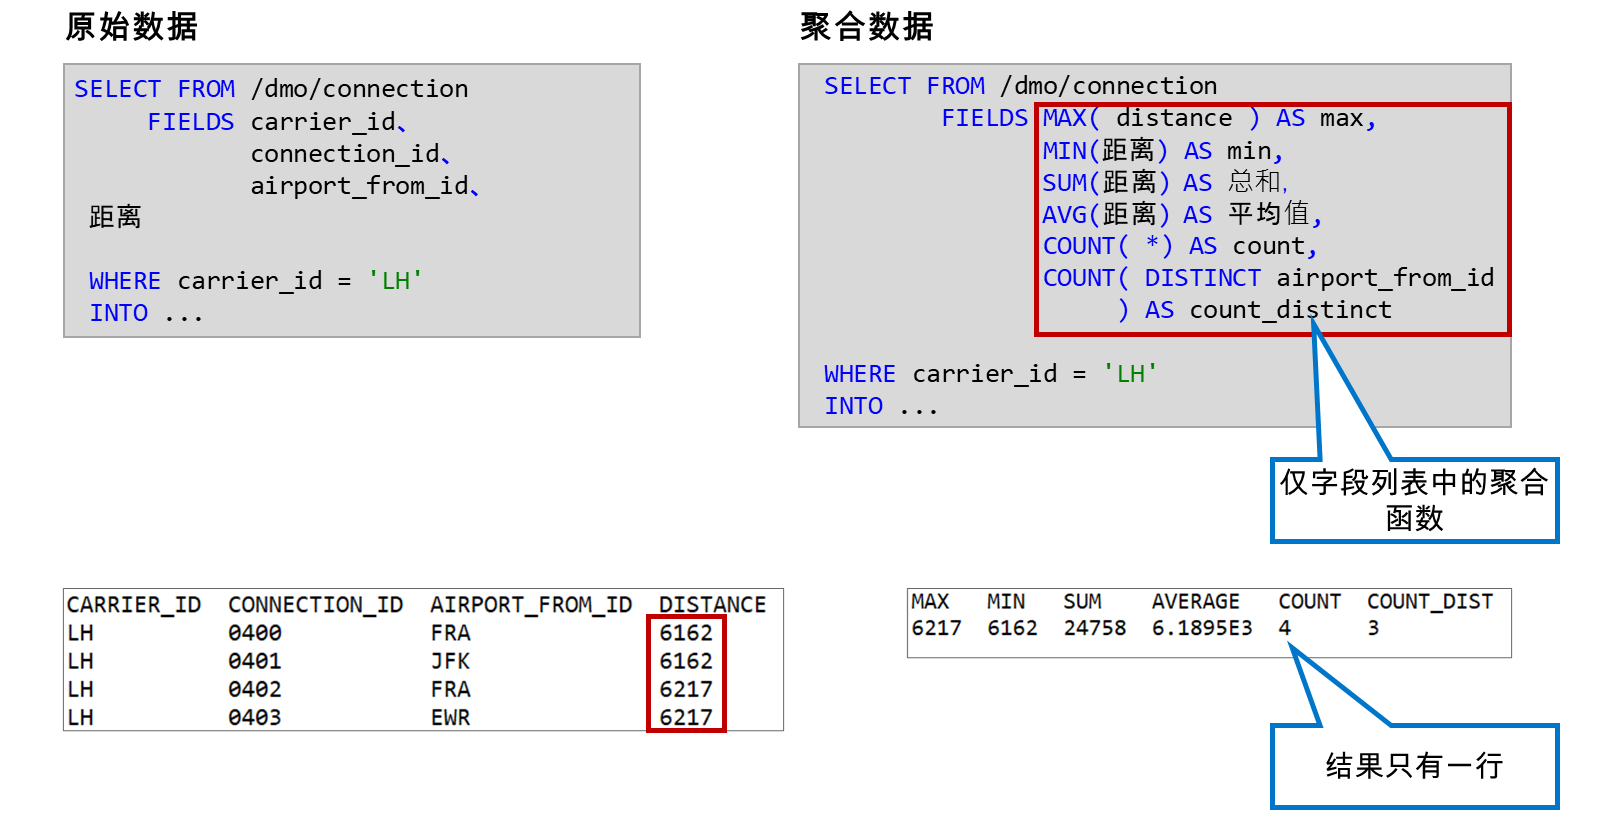
在我们的示例中,左侧的 SELECT 语句说明了右侧 SELECT 中的聚合所基于的数据集。
您可以看到 DISTANCE 列中的最大值为 6217,而最小值为 6162。总行数为 4,列 AIRPORT_FROM_ID 包含 3 个非重复值(值 'FRA' 出现两次)。
试用:聚合函数
创建实施接口 IF_OO_ADT_CLASSRUN 的新全局类。
将以下代码片段复制到方法 if_oo_adt_classrun~main() 的实施部分:
SELECT FROM /dmo/connection
FIELDS carrier_id,
connection_id,
airport_from_id,
distance
WHERE carrier_id = 'LH'
INTO TABLE @DATA(result_raw).
out->write(
EXPORTING
data   = result_raw
name   = 'RESULT_RAW'
).
*********************************************************************
SELECT FROM /dmo/connection
FIELDS MAX( distance ) AS max,
MIN( distance ) AS min,
SUM( distance ) AS sum,
AVG( distance ) AS average,
COUNT( * ) AS count,
COUNT( DISTINCT airport_from_id ) AS count_dist
WHERE carrier_id = 'LH'
INTO TABLE @DATA(result_aggregate).
out->write(
EXPORTING
data   = result_aggregate
name   = 'RESULT_AGGREGATED'
).
选择 CTRL + F3 激活类,然后选择 F9 将其作为控制台应用执行。
分析控制台输出。
GROUP BY 附加项
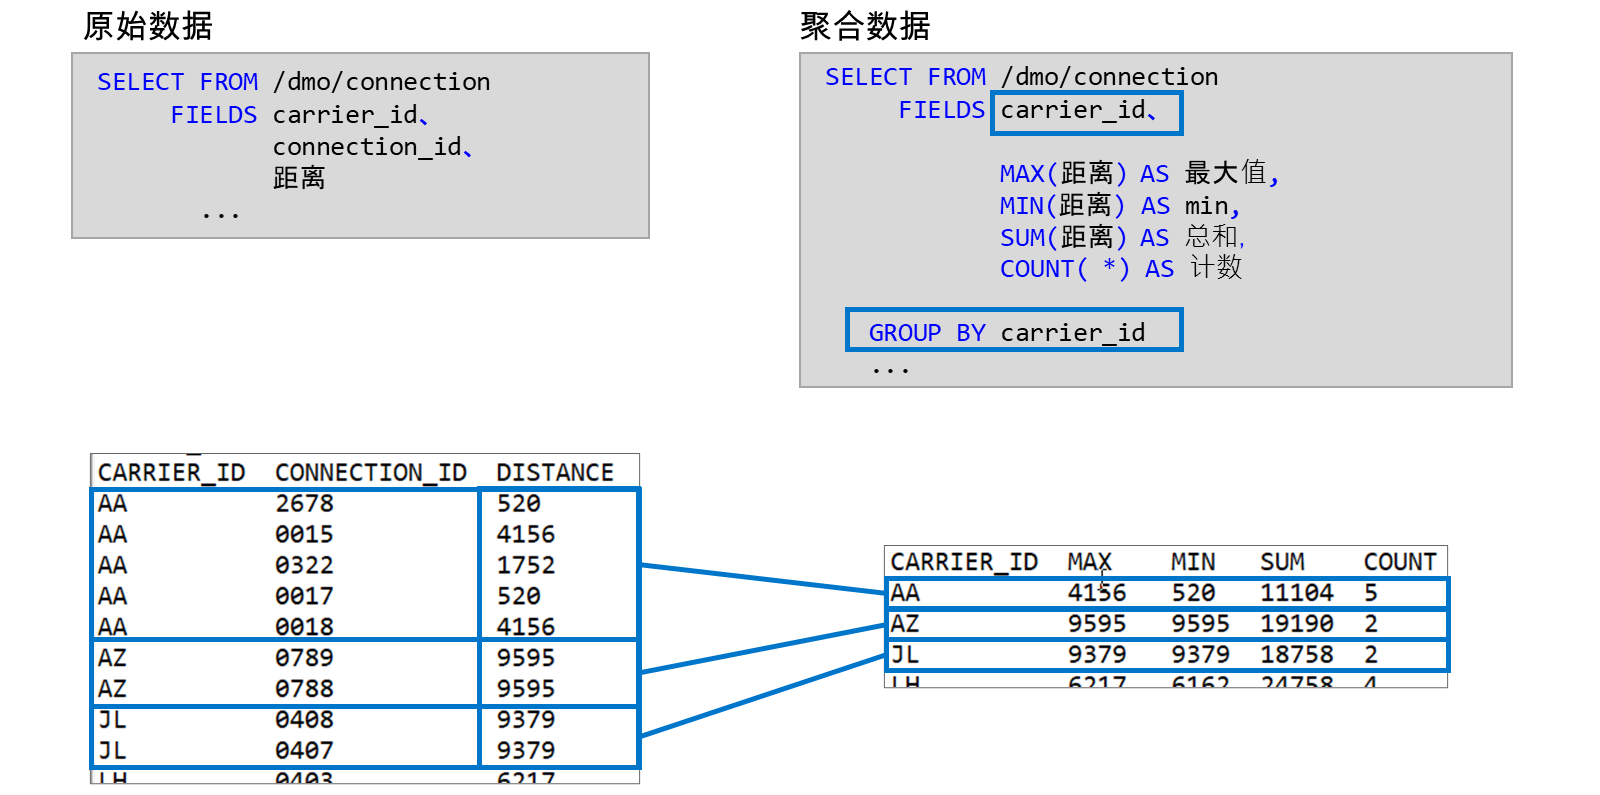
如果 SELECT 语句的字段列表包含集合函数和其它元素(如列、表达式等)的混合,则 SQL 的语法需要 GROUP BY 子句。GROUP BY 子句必须列出聚合之外的字段列表中显示的所有列。
在右侧的 SELECT 语句中,字段列表中使用两列:CARRIER_ID 和 DISTANCE。列 DISTANCE 只显示为集合函数的输入,因此在 GROUP BY 之后不是必需的。但列 CARRIER_ID 在聚合函数之外使用,因此必须在 GROUP BY 之后列出。
GROUP BY 的影响可以在 SELECT 语句的结果中看到。执行聚合的数据集分为在 GROUP BY - 字段中具有相同值的子集(组)。每个组在最终结果集中都有相应的一行。针对每个组分别对集合表达式求值。
例如,CARRIER_ID = 'AA' 的行包含 COUNT = 5 和 MAX = 4156,因为 CARRIER_ID = 'AA' 的子集包含 5 行,而此子集中距离的最大值为 4156。
试用:GROUP BY
创建实施接口 IF_OO_ADT_CLASSRUN 的新全局类。
将以下代码片段复制到方法 if_oo_adt_classrun~main() 的实施部分:
SELECT FROM /dmo/connection
FIELDS
*            carrier_id,
MAX( distance ) AS max,
MIN( distance ) AS min,
SUM( distance ) AS sum,
COUNT( * ) AS count
*     GROUP BY carrier_id
INTO TABLE @DATA(result).
out->write(
EXPORTING
data   = result
name   = 'RESULT'
).
选择 CTRL + F3 激活类,然后选择 F9 将其作为控制台应用执行。
分析控制台输出。
移除带有关键字 FIELDS 的行(字段名称为 carrier_id 的行)后行中的星号 (*)。请注意语法错误,告知您字段 CARRIER_ID 在 GROUP BY 子句中缺失。
从带有 GROUP BY 附加的行中移除星号 (*),然后再次激活。
再次执行 并查看控制台输出如何更改。
检索排序和聚合数据
在本练习中,按日期对航班进行排序,并计算数据库中航班的平均占用率。
模板:
/LRN/CL_S4D401_DBS_FUNCTIONS(全局类)
解决方案:
/LRN/CL_S4D401_DBS_AGGREGATE(全局类)
任务 1: 复制模板(可选)
复制模板类 /LRN/CL_S4D401_DBS_FUNCTIONS。如果已完成上一练习,则可以跳过此任务并继续编辑类 ZCL_##_SOLUTION。
步骤
将类
/LRN/CL_S4D401_DBS_FUNCTIONS复制到您自己的包中的类(建议名称:ZCL_##_SOLUTION,其中 ## 代表组编号)。在项目浏览器中,右键单击类
/LRN/CL_S4D401_DBS_FUNCTIONS以打开上下文菜单。从上下文菜单中,选择复制....
在包字段中输入包的名称。在名称字段中,输入
ZCL_##_SOLUTION,其中 ## 代表组编号。选择下一步。
确认传输请求并选择完成。
激活复制。
按
Ctrl + F3激活类。
任务 2: 排序数据
在局部类 LCL_PASSENGER_FLIGHT 中,调整方法 GET_FLIGHTS_BY_CARRIER 的实施。添加合适的指令,以按升序检索按航班日期排序的航班列表。然后在本地类 LCL_CARGO_FLIGHT 中执行相同操作。
步骤
在局部类
LCL_PASSENGER_FLIGHT中,导航至方法GET_FLIGHTS_BY_CARRIER的实施。照常执行该步骤。
调整 SELECT 语句以确保数据库返回按航班日期升序排序的结果。
在 INTO 子句之前添加 ORDER BY 子句。
如下调整代码:
SELECT
FROM /lrn/passflight
FIELDS carrier_id, connection_id, flight_date,
plane_type_id, seats_max, seats_occupied,
seats_max - seats_occupied AS seats_free,
currency_conversion(
amount             = price,
source_currency    = currency_code,
target_currency    = @currency,
exchange_rate_date = flight_date,
on_error           =
@sql_currency_conversion=>c_on_error-set_to_null
) AS price,
@currency AS currency_code
WHERE carrier_id = @i_carrier_id
ORDER BY flight_date ASCENDING
INTO TABLE @flights_buffer.
导航到本地类
LCL_CARGO_FLIGHT中的方法GET_FLIGHTS_BY_CARRIER。照常执行该步骤。
调整 SELECT 语句以确保数据库返回按航班日期升序排序的结果。
在 INTO 子句之前添加 ORDER BY 子句。
如下调整代码:
SELECT
FROM /lrn/cargoflight
FIELDS carrier_id, connection_id, flight_date,
plane_type_id, maximum_load, actual_load, load_unit,
airport_from_id, airport_to_id, departure_time, arrival_time
WHERE carrier_id = @i_carrier_id
ORDER BY flight_date ASCENDING
INTO CORRESPONDING FIELDS OF TABLE @flights_buffer.
任务 3: 使用聚合函数
在局部类 LCL_CARRIER 中,调整方法 GET_AVERAGE_FREE_SEATS 的实施。使用数据库表 /LRN/PASSFLIGHT 中的 SELECT 进行计算,而不是计算所有乘客航班循环中的结果。
步骤
在局部类
LCL_CARRIER中,导航到方法GET_AVERAGE_FREE_SEATS的实施。照常执行该步骤。
删除或注释方法实施的源代码。
标记语句
METHOD get_average_free_seats.和ENDMETHOD.之间的代码,然后按Ctrl + <。现在,实施一个 SELECT 语句,该语句检索当前航空公司(存储在
carrier_id属性中)的可用座位和乘客航班总数。将结果存储在内联声明的数据对象中(建议名称:聚合)。添加以下代码:
SELECT FROM /lrn/passflight
FIELDS SUM( seats_max - seats_occupied ) AS sum,
COUNT(*) AS count
WHERE carrier_id = @carrier_id
INTO @DATA(aggregates).
在 SELECT 语句之后,计算两个集合的比率,并将结果指派给返回参数
r_result。如下调整代码:
SELECT FROM /lrn/passflight
FIELDS SUM( seats_max - seats_occupied ) AS sum,
COUNT(*) AS count
WHERE carrier_id = @carrier_id
INTO @DATA(aggregates).
r_result = aggregates-sum / aggregates-count.
注意
可以通过以下代码实现 GET_AVERAGE_FREE_SEATS 方法的更简要实施:
abap SELECT FROM /lrn/passflight FIELDS CAST( AVG( seats_max - seats_occupied ) AS INT4 ) WHERE carrier_id = @carrier_id INTO @r_result.
以控制台应用形式激活并测试全局类。
按
Ctrl + F3。按
F9。