使用附加数据加载设置和功能
学习目标
描述故事的其他数据加载设置和功能如何影响性能。
始终初始化功能
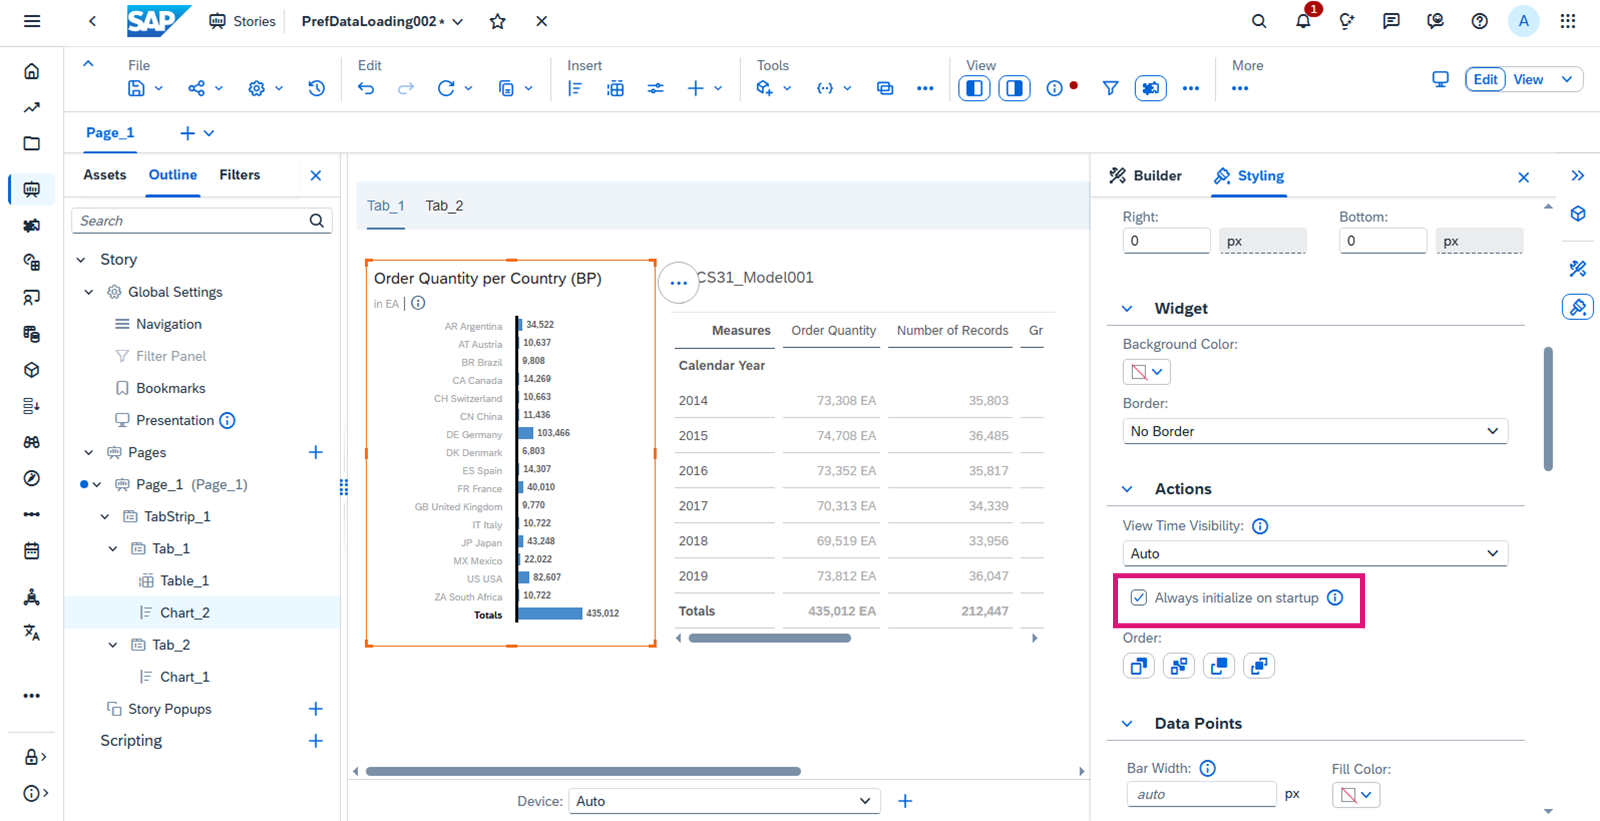
如果将"视口加载"或"后台加载"设置为故事的"加载优化设置",则可以使用"始终在启动时初始化"功能影响故事的性能。
如果在微件的"样式设置"面板中将微件操作设置为"始终在启动时初始化",则作为初始渲染阶段的一部分,该微件将使用所有可见微件进行初始化。在处理脚本时和完成后台加载之前访问微件的情况下,这可能会提高性能。
限制
如果对嵌入在容器中的微件使用此功能,请确保容器本身在运行时可见,或者已为容器启用*"始终在启动时初始化"*。
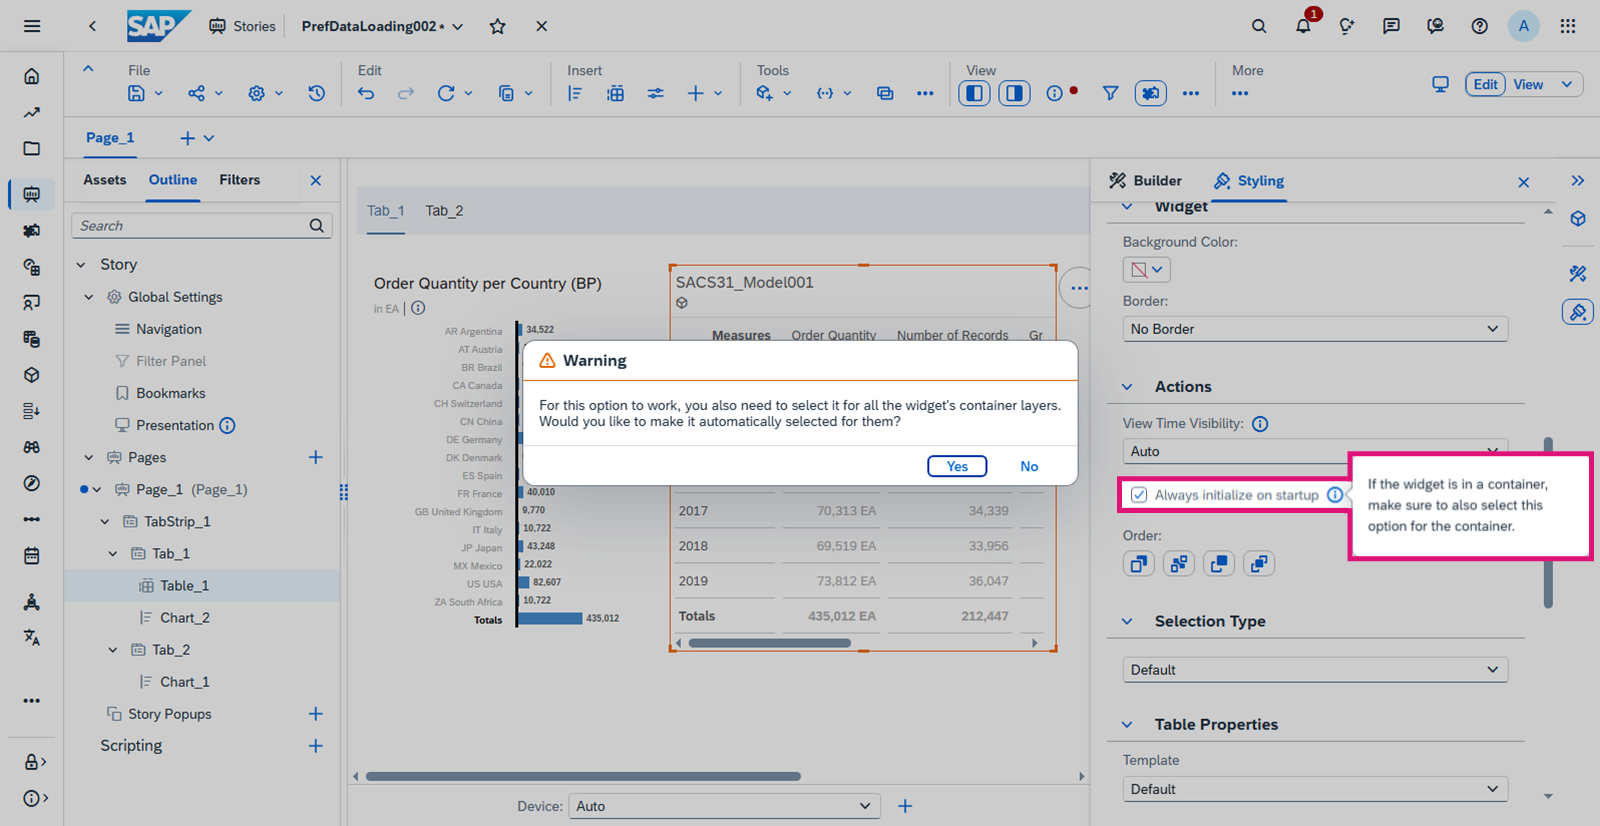
"始终在启动时初始化"不适用于弹出窗口中的微件。要使用此选项,请将微件从弹出窗口移动到画布。
如果该微件用作数据池,并且在运行时始终不可见,则最佳实践是将此微件直接放在画布上,而不是将其嵌入容器中。
查询定义和模型元数据缓存
保存故事后,将为所有用户公开缓存其第一页查询定义(含所需模型元数据)。这样可以避免额外的往返请求(例如加载模型元数据),从而提高初始加载性能。
当用户打开故事时,会检查现有公共缓存是否有效。更改相关模型(包括计划模型中的版本更改)时,缓存将变为无效。如果公共缓存有效,则将使用缓存。如果不是,将发出单独的请求以获取当前元数据。然后,此新获取的元数据将替换旧缓存。
缓存不能用于具有脚本事件所引用数据源的微件。
阻止使用高速缓存的脚本示例:
Chart.getDataSource().setDimensionFilter() 或者
Chart.getDataSource().getResultset()
本课末尾的附录中提供了阻止使用缓存的 API 的完整列表。
书签缓存
使用书签时,存在额外的公共缓存对象,用于存储查询定义和模型元数据。
对于初始故事创建(首次保存故事),以下逻辑适用:
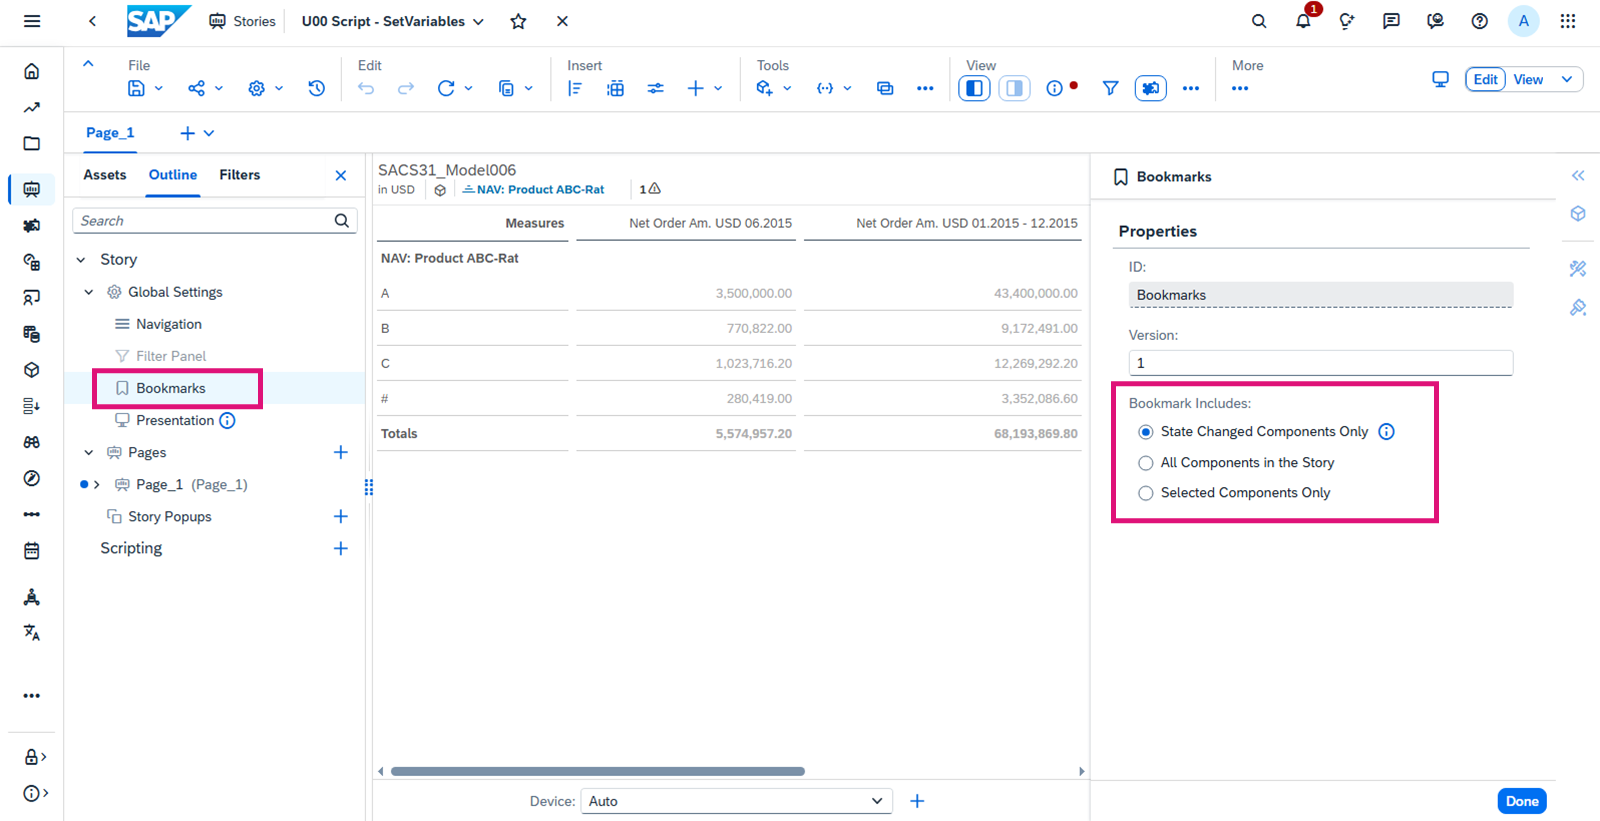
如果书签范围配置为" 仅状态更改的部件 "(默认选项)或 "故事中的所有部件 ",则在保存故事时创建缓存。
如果将书签范围配置为 仅所选组件 ,则会在第一个用户查看故事时创建缓存。
对于现有故事的任何更改(重新保存故事),以下逻辑适用:
任何现有书签缓存都将被移除。
第一个用户查看故事时,将生成公共缓存。
使用 bookmarkset.apply() 脚本 API 加载书签不会使用或生成书签缓存。
附录
阻止系统使用查询定义和元数据缓存的图表相关 API |
阻止系统使用查询定义和元数据缓存的表相关 API |
|---|---|
|
|
查询设置
缺省设置
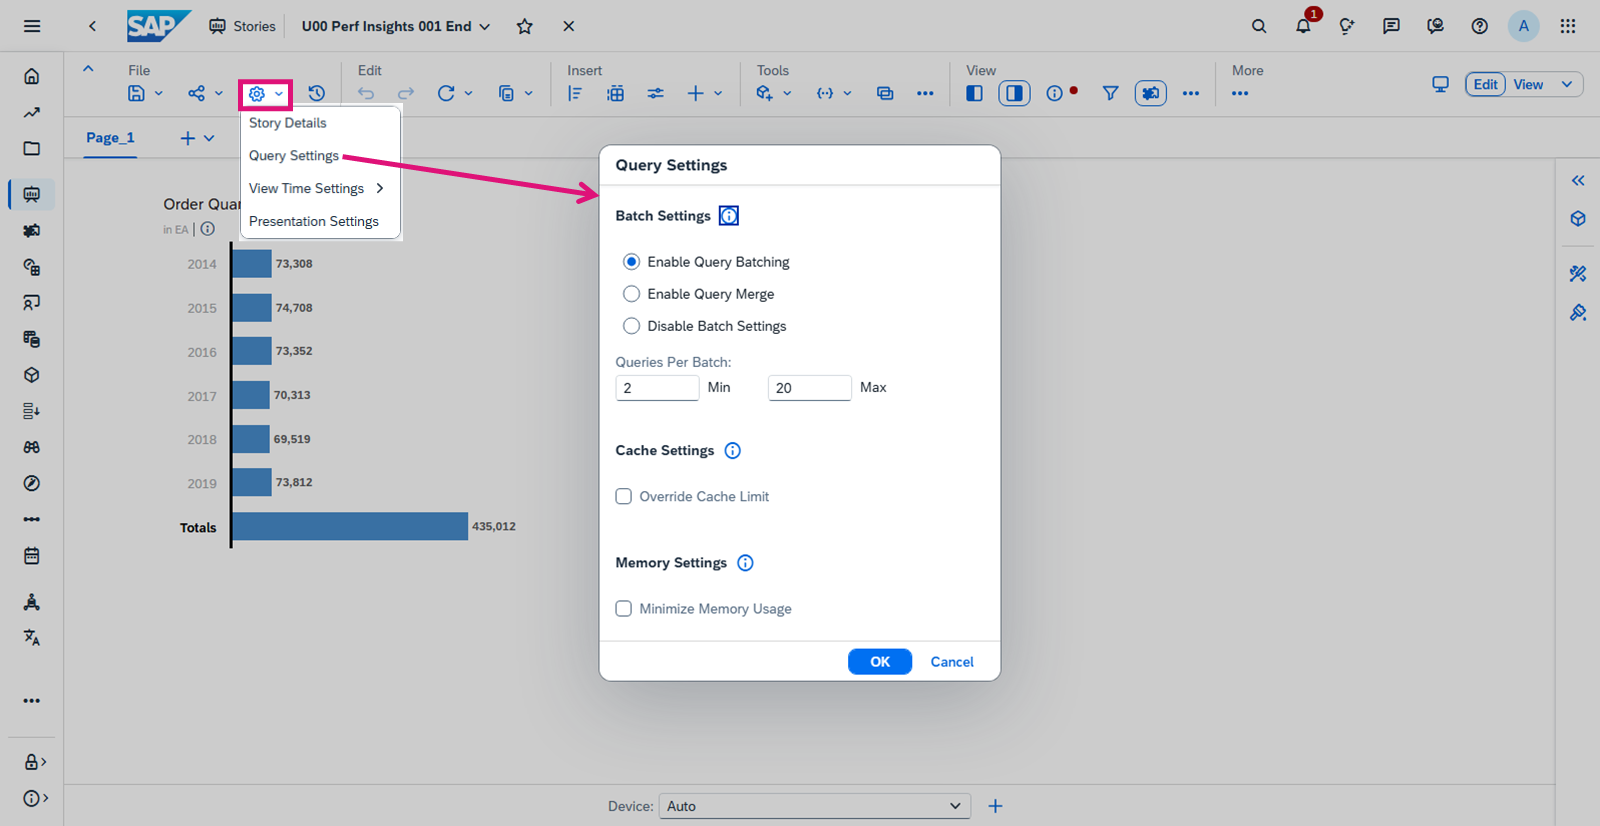
"查询设置"中的默认值设计为最适合大多数 SAP Analytics Cloud 故事。因此,我们建议保留缺省值,如下所示。
批处理设置
批处理设置仅与以下数据源相关:
SAP Analytics Cloud 导入模型
SAP Datasphere 实时模型
SAP HANA 实时模型
如果要从其他连接访问数据,则与此设置无关。
在批处理设置部分,可以使用以下选项:
启用查询批处理
启用查询合并
您可以启用两个选项之一或禁用这两个选项。
选择启用查询批处理后,针对同一模型的各种查询将合并为一个由单个分析对象组成的批次,并作为单个 HTTP 请求一起发送。在服务器上,使用线程将分析调用作为隔离查询进行处理。
根据源系统中的特定设置,例如每个请求已分配资源数量的限制,您可以考虑减少每批次查询数的上限。
当结果集具有不同的度量但维/向下钻取级别相同时,选择启用查询合并会合并同一模型的请求。在启用此设置的情况下保存故事时,包含可以合并的查询的微件会以相同的颜色着色,以便你查看可以合并的内容。如果你拥有大量具有匹配结果集并同时使用数据渲染的微件,此设置只能对数据加载性能产生积极影响。
缓存设置
此设置中引用的高速缓存是为每个用户和每个会话创建的高速缓存。
当用户打开故事并在故事页面中导航时,最多会在浏览器中本地缓存 10 个页面及其微件。系统默认值为 150,但可以在*"系统*→""管理"中更改。当用户导航回他们已查看并在缓存中可用的页面时,将使用此缓存,这意味着页面打开速度更快。如果启用了"覆盖高速缓存限制",则会高速缓存更多微件。但是,由于这会使用更多的浏览器内存,因此它可以通过减慢其速度来影响用户与故事的交互。
例如,与数据加载优化设置相比,此设置的目的是加快故事的初始开始时间。此设置仅以故事页面导航性能为目标,而不是故事的初始加载时间。