区分监督式学习和无监督式学习
学习目标
区分监督学习和无监督学习方法
监督式学习使用标记的训练数据集,而无监督学习没有目标变量。无监督学习算法试图在没有人工监督或指令的情况下学习数据的内在结构。在无监督学习下,为算法提供未加标签的输入数据,用于查找数据集内的模式。
监督学习和无监督学习是机器学习的主要方法。受监督的机器学习适用于分类和回归任务,例如天气预报、预测库存价格、欺诈检测、客户流失预测等。另一方面,无监督学习在没有人工监督的情况下从数据中学习,并经常用于探索性数据分析和群集活动,例如异常检测、大数据可视化。
监督式学习建模侧重于学习输入和输出数据项之间的关系。例如,在给定输入数据的情况下,分类尝试预测目标变量的分类值,而回归尝试了解独立变量和相关变量之间的关系。
相反,对于无监督学习,没有标签,只有描述此类块组的数据属性,即功能。无监督学习支持发现数据集中的模式。例如,聚类活动将数据拆分为相似实体的集合。
总之,监督学习和无监督学习之间的主要区别在于模型的训练方式以及提供给算法的训练数据集类型。
无需
监督式学习培训数据集
监督式学习算法在带标签的数据集上训练,即数据集具有"目标变量"。
在标记的数据集内,数据集中的每个实例都附带一个标签或表示正确输出的"目标变量"。此标签由监督式学习算法使用,以学习将输入映射到所需输出的函数。
监督式学习算法根据数据集进行训练,其中同时提供了输入功能和正确的输出(标签)。模型将学习预测输入数据的输出。另一方面,无监督学习算法使用未标记的数据,并尝试在不事先了解结果的情况下识别固有模式或分组。这两种学习的训练过程的持续时间和复杂性可能因数据集大小、可用计算资源等因素而异。
加利福尼亚开放数据门户上提供的加利福尼亚住房数据集 (https://data.ca.gov/dataset) 用作以下段落中的参考。
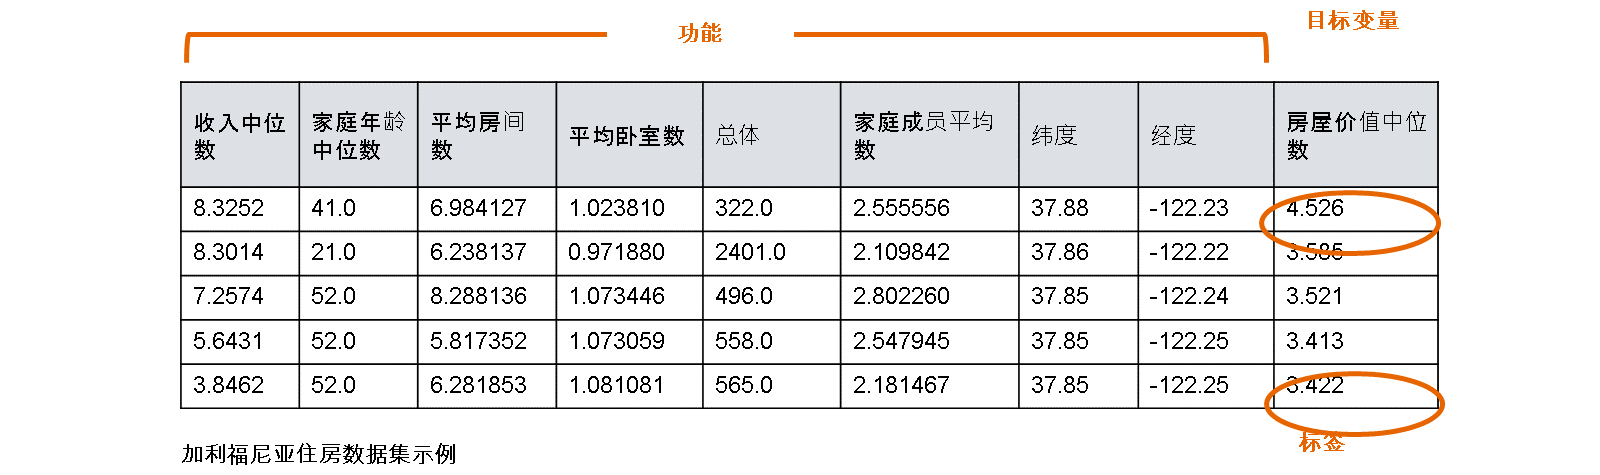
下表说明了监督式学习任务的示例输入数据集,旨在训练模型以预测加利福尼亚地区的"中间房价"。换句话说,"目标变量"为"中间房源值"。
这些列也称为"功能"。此类功能是有助于预测"目标变量"的数据属性。直观地说,"中间房龄"、"每户平均房间数"和"每户平均卧室数"是影响其价值的房屋的特征。最后,"功能"和"标签"是用于受监管模型训练的输入数据。
无需
此数据集派生自 1990 年美国人口普查,每一行代表一个人口普查块组。块组是美国人口普查局为其发布样本数据的最小地理单元(块组的人口通常为 600 到 3,000 人)。
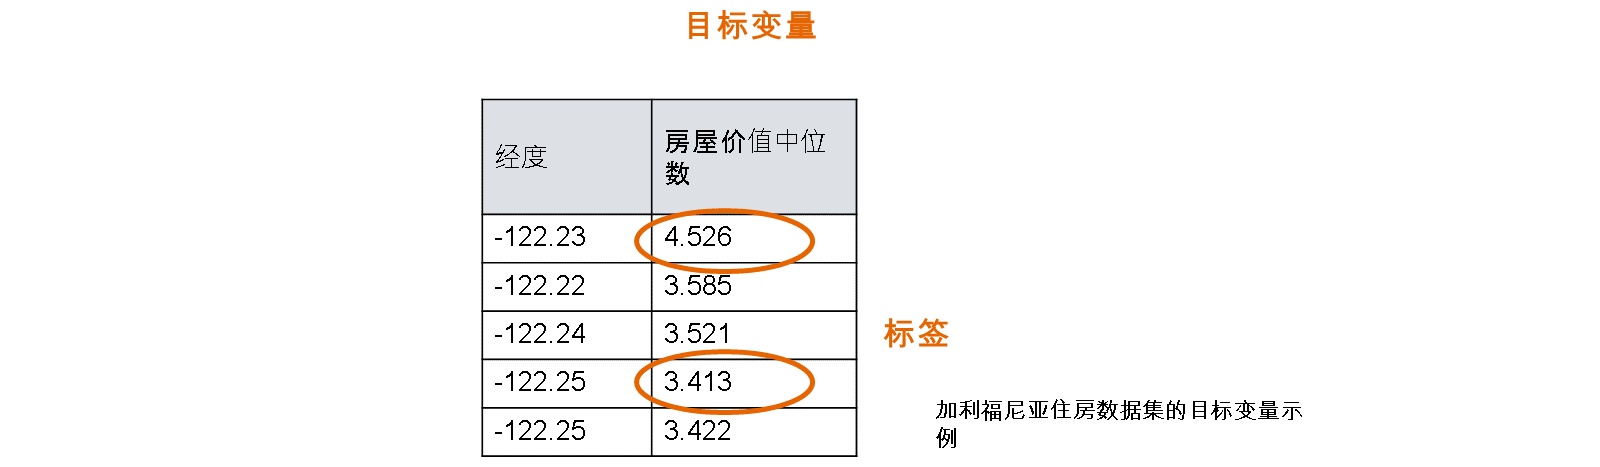
例如,值"4.526"和"3.585"是连续"目标变量"的标签,这意味着变量可以采用最小值和最大值之间的任何值。
每一行都是模型将从中学习到的观测对象或示例。
无需
监督式学习方法 - 模型预测
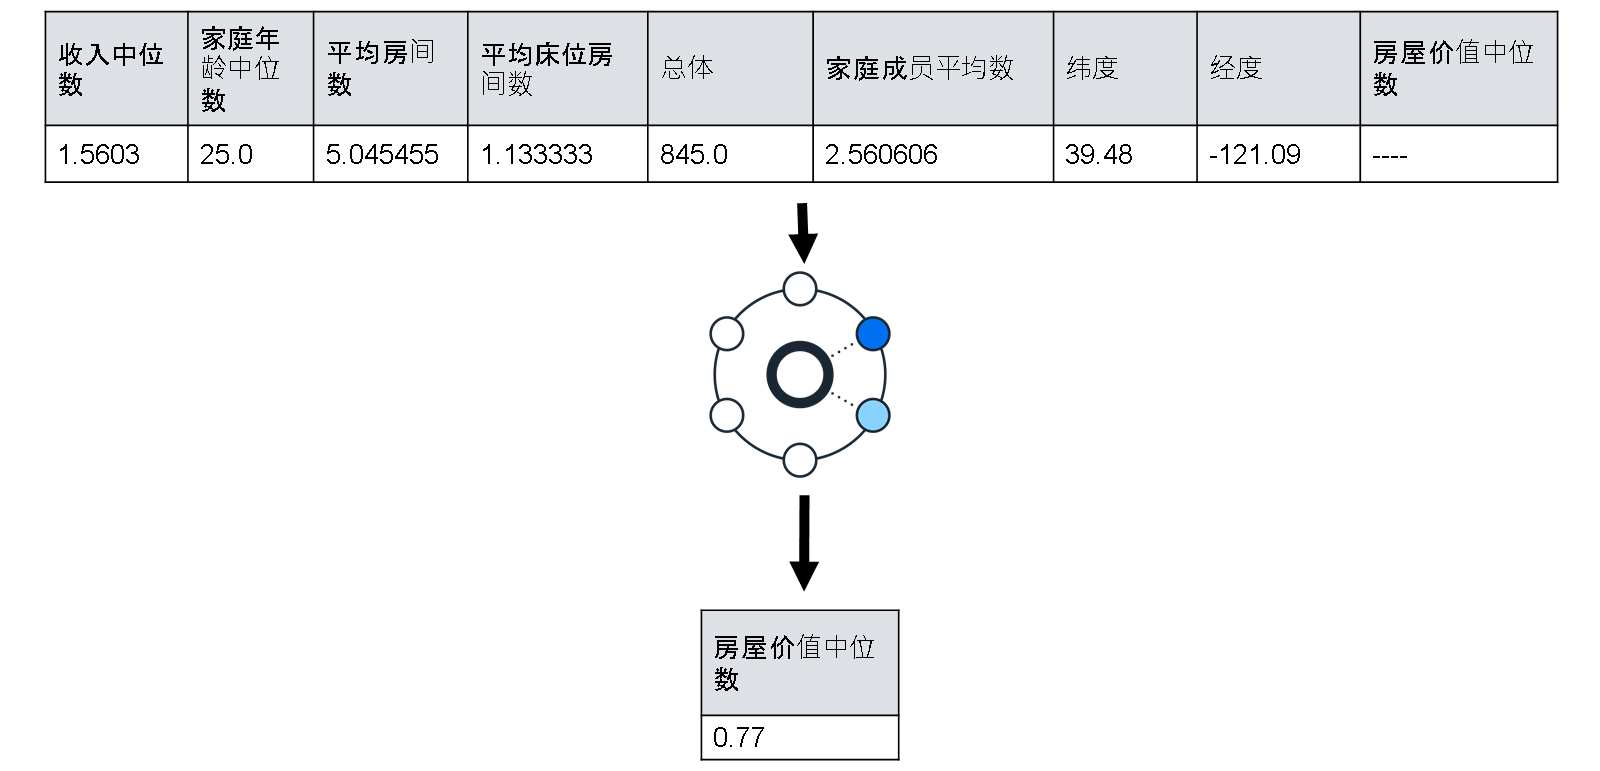
模型训练完成后,可以为模型提供新的输入数据。
在此场景中,冻结组用作输入。
请注意,块组是美国人口普查局为其发布样本数据的最小地理单元(一个块组通常有 600 到 3000 人的人口)。
功能作为表中的输入提供,模型提供预测:"中间房源值"。
无需
无监督学习培训数据集
对于无监督学习,数据集没有标签,但具有描述此类块组的数据属性,即"功能"。无监督学习支持发现数据集中的模式。例如,聚类活动将数据拆分为相似实体的集合。
无监督学习可用于识别不同种类的住房市场。
下表显示了人口普查块,由聚类算法使用,以根据人口普查块组的相似度生成地区分组。例如,一个类别可以是高"中间收入"且平均房间数至少为 5 的住房市场。
加州住房数据集 - 人口普查区块
收入中位数 |
家庭年龄中位数 |
平均房间数 |
平均卧室数 |
总体 |
家庭成员平均数 |
纬度 |
经度 |
房屋价值中位数 |
|---|---|---|---|---|---|---|---|---|
15.001 |
32.0 |
8.845041 |
1.035124 |
1318.0 |
2.723140 |
37.44 |
-122.22 |
5.00001 |
15.001 |
43.0 |
5.687500 |
0.750000 |
58.0 |
3.625000 |
37.46 |
-121.87 |
5.00001 |
15.001 |
52.0 |
7.994475 |
1.027624 |
483.0 |
2.668508 |
37.79 |
-122.44 |
5.00001 |
15.001 |
17.0 |
8.520376 |
1.021944 |
1011.0 |
3.169279 |
32.99 |
-117.23 |
5.00001 |
15.001 |
27.0 |
7.651923 |
0.980769 |
1351.0 |
2.598077 |
34.10 |
-118.40 |
5.00001 |
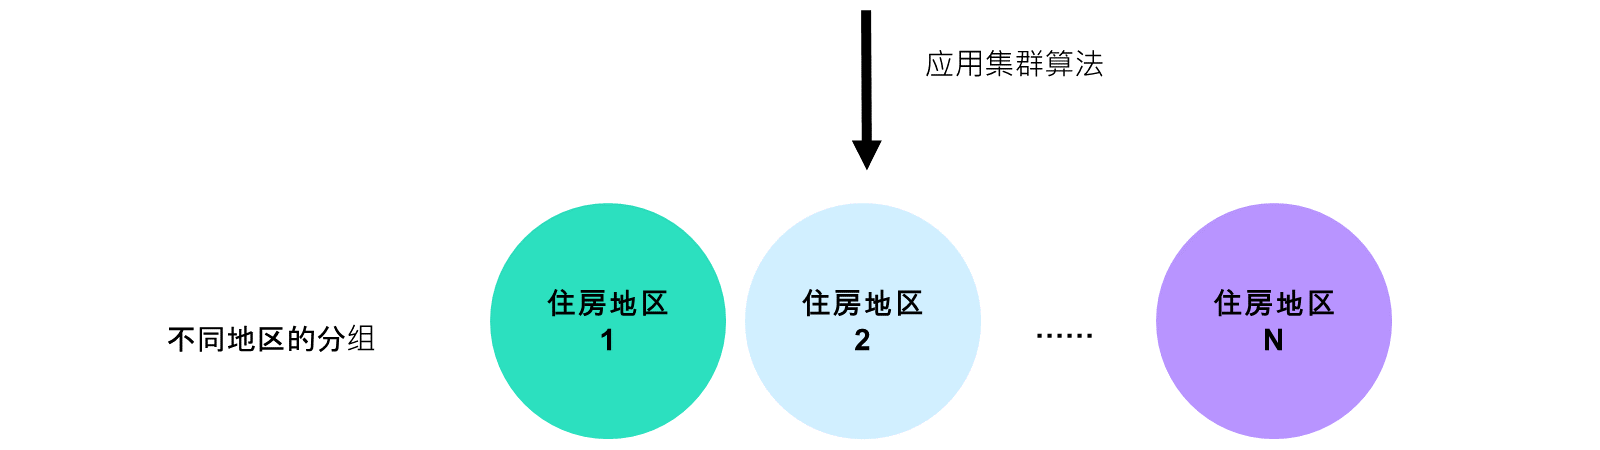
值得注意的是,这些类别是通过无监督学习过程产生的,而不是预先确定的。从集群结果中获得的洞察力对于家庭买主和房产投资者来说是有价值的。
无需
无监管学习方法 - 模型预测
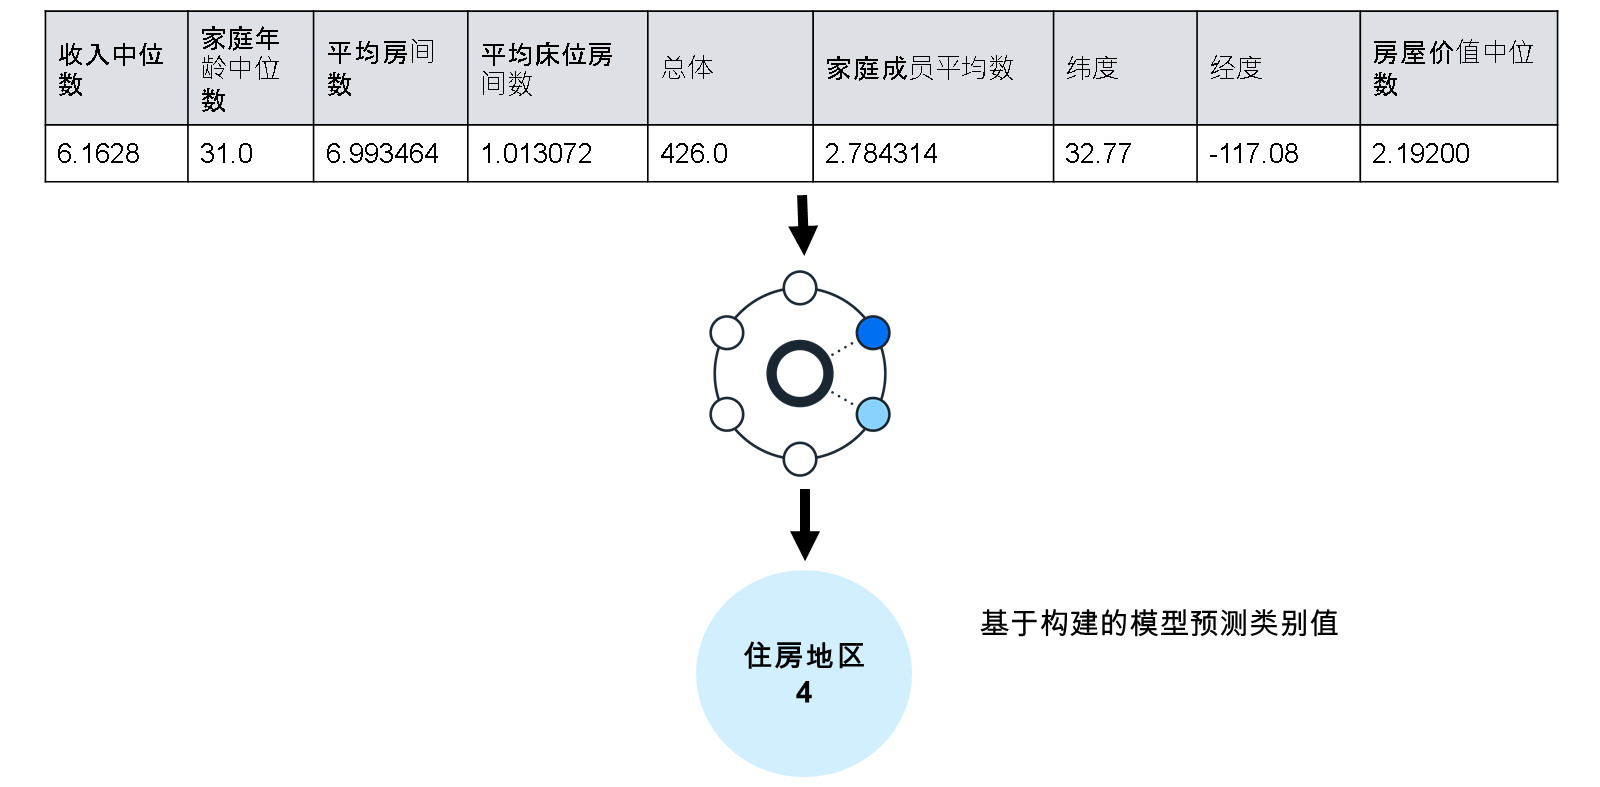
模型训练完成后,可用于进行预测。因此,通过使用训练后的模型,您可以预测给定输入块组的最佳拟合,如下所示。
无需
无监督学习方法
另一方面,无监督学习始终可以用来发现未标记数据集中的模式。数据标签可以是劳动密集型任务,可能并不总是可能的。此外,您可能甚至不知道数据集可以拆分成的有意义类别或组。
例如,在加利福尼亚发现有意义的住房区域集群可以帮助家庭买家和财产投资者更好地了解加利福尼亚的住房市场。
通过识别这些模式,无监督学习可以提供宝贵的见解,否则将难以获得。