使用 SAP Cloud SDK for AI 评估提示
学习目标
使用 SDK 中的函数对更大的数据集评估提示。
在上一课学习开发和优化提示之后,下一个关键步骤是确保其质量和可靠性。在本课中,我们将探讨如何使用 SAP Cloud SDK for AI 为您的提示建立系统化的评估框架。您将学习自动化评估 LLM 的输出,为生成式 AI 应用的持续改进设定关键基线。
使用 SAP Cloud SDK for AI 评估提示
您已成功开发了一个提示,以 JSON 格式为客户消息分配紧急程度、情感和类别。然而,对于这家设施解决方案公司而言,这些输出的准确性非常重要,因为它们直接影响面向客户的关键应用和运营决策。
为保证这种准确性,跨各种场景对提示进行自动化且一致的评估至关重要,以确保可靠性和效率。这正是使用 SAP Cloud SDK for AI 实现的自定义评估函数不可或缺之处。
SAP Cloud SDK for AI 为提示评估提供了关键优势:
可靠的测试: 它跨各种场景自动化提示测试,确保结果一致且高效。
衡量性能: 它提供客观指标(例如相关性、连贯性、流畅度),以定量评估回复质量。
定制化评估: 它允许您创建满足特定需求的自定义评估器,从而实现更精确、更相关的评估。
可扩展的结果: 它支持大规模评估,使在大型数据集上测试提示变得更加容易。
实现评估函数
导入包。
from tqdm.auto import tqdm
import time
class RateLimitedIterator:
def __init__(self, iterable, max_iterations_per_minute):
self._iterable = iter(iterable)
self._max_iterations_per_minute = max_iterations_per_minute
self._min_interval = 1.0 / (max_iterations_per_minute / 60.)
self._last_yield_time = None
def __iter__(self):
return self
def __next__(self):
current_time = time.time()
if self._last_yield_time is not None:
elapsed_time = current_time - self._last_yield_time
if elapsed_time < self._min_interval:
time.sleep(self._min_interval - elapsed_time)
self._last_yield_time = time.time()
return next(self._iterable)
这段代码定义了一个 "RateLimitedIterator" 类,用于控制遍历可迭代对象的速率。通过指定每分钟的最大迭代次数,它确保迭代过程遵循既定速度,避免触及速率限制。它使用 "tqdm" 库进行进度可视化,使用 "time" 模块进行时序控制。 2. 定义评估函数。
def evaluation(mail: Dict[str, str], extract_func: Callable, _print=True, **kwargs):
response = extract_func(input=mail["message"], _print=_print, **kwargs)
result = {
"is_valid_json": False,
"correct_categories": False,
"correct_sentiment": False,
"correct_urgency": False,
}
try:
pred = json.loads(response)
except json.JSONDecodeError:
result["is_valid_json"] = False
else:
result["is_valid_json"] = True
result["correct_categories"] = 1 - (len(set(mail["ground_truth"]["categories"]) ^ set(pred["categories"])) / len(categories))
result["correct_sentiment"] = pred["sentiment"] == mail["ground_truth"]["sentiment"]
result["correct_urgency"] = pred["urgency"] == mail["ground_truth"]["urgency"]
return result
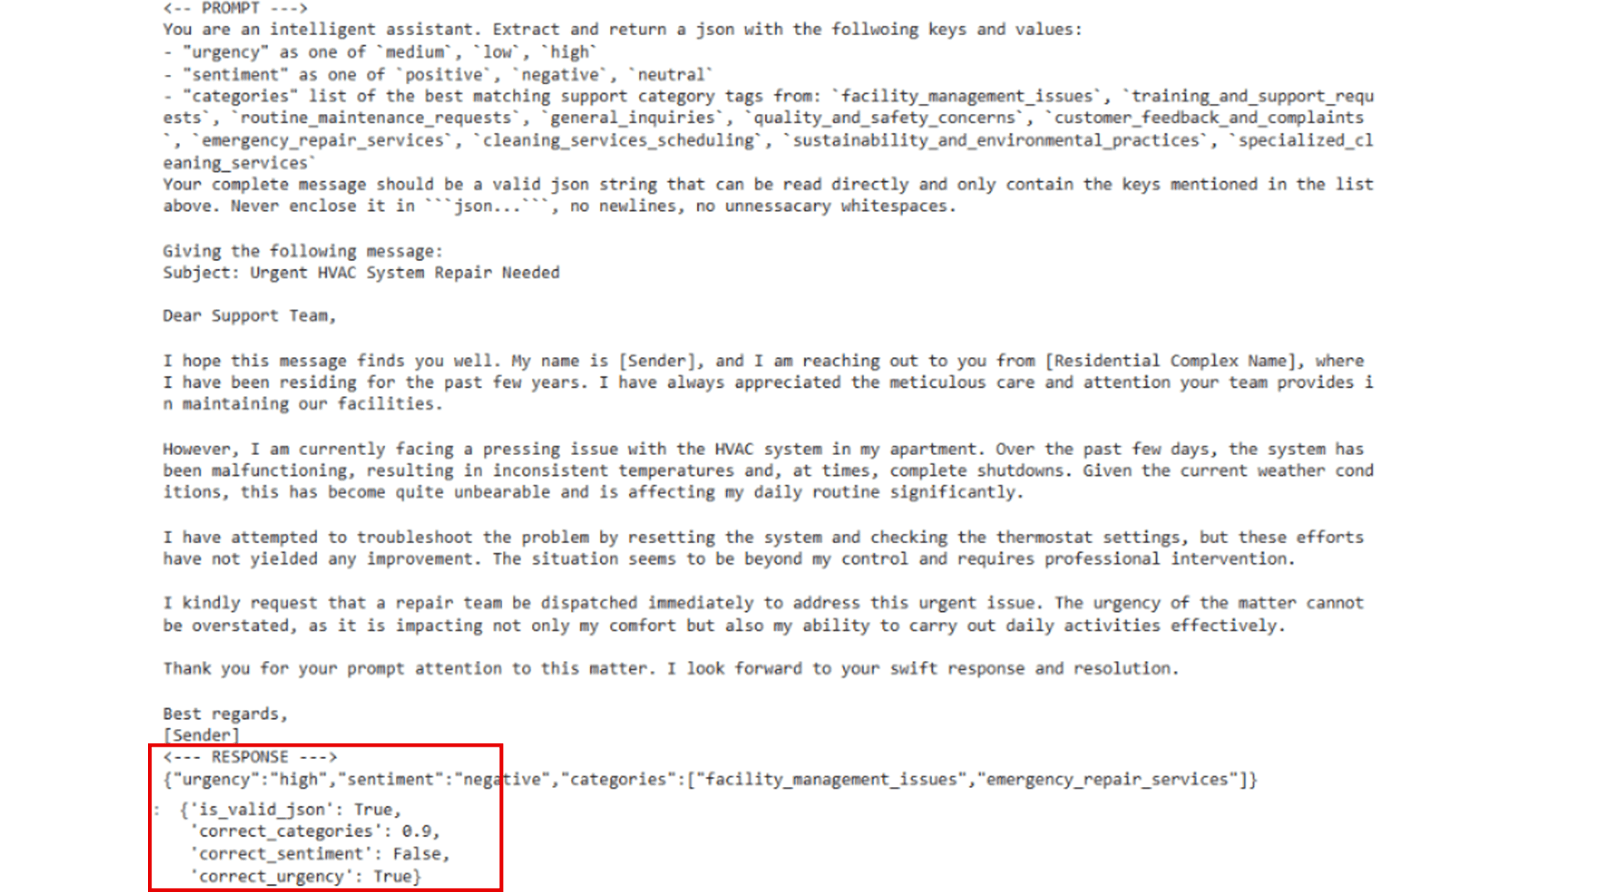
evaluation(mail, f_8)
这段代码评估某个处理电子邮件消息的函数所做的预测。它使用提供的提取函数分析电子邮件内容,并将结果与预定义的基准真值数据进行比较,检查 JSON 是否有效以及类别、情感和紧急程度是否正确。这确保提取函数准确且一致地执行。 最后一句话评估了我们之前开发的组合提示函数。 您可以看到,评估显示除情感外所有预测都正确。 3. 针对大量邮件实现一个评估函数,以支持大规模评估,使在大型数据集上测试提示更加容易。
from tqdm.auto import tqdm
def transpose_list_of_dicts(list_of_dicts):
keys = list_of_dicts[0].keys()
transposed_dict = {key: [] for key in keys}
for d in list_of_dicts:
for key, value in d.items():
transposed_dict[key].append(value)
return transposed_dict
def evalulation_full_dataset(dataset, func, rate_limit=100, _print=False, **kwargs):
results = [evaluation(mail, func, _print=_print, **kwargs) for mail in tqdm(RateLimitedIterator(dataset, rate_limit), total=len(dataset))]
results = transpose_list_of_dicts(results)
n = len(dataset)
for k, v in results.items():
results[k] = sum(v) / len(dataset)
return results
def pretty_print_table(data):
# Get all row names (outer dict keys)
row_names = list(data.keys())
# Get all column names (inner dict keys)
if row_names:
column_names = list(data[row_names[0]].keys())
else:
column_names = []
# Calculate column widths
column_widths = [max(len(str(column_name)), max(len(f"{data[row][column_name]:.2f}") for row in row_names)) for column_name in column_names]
row_name_width = max(len(str(row_name)) for row_name in row_names)
# Print header
header = f"{'':>{row_name_width}} " + " ".join([f"{column_name:>{width}}" for column_name, width in zip(column_names, column_widths)])
print(header)
print("=" * len(header))
# Print rows
for row_name in row_names:
row = f"{row_name:>{row_name_width}} " + " ".join([f"{data[row_name][column_name]:>{width}.1%}" for column_name, width in zip(column_names, column_widths)])
print(row)
overall_result = {}
这段代码现在对整个数据集执行评估,通过带速率限制的函数评估每个条目,转置结果以便更好地聚合,然后以表格格式美观地打印最终评估指标。它使用 "tqdm" 库显示进度条,使跟踪处理状态更加容易。整个流程确保处理简化高效,结果清晰呈现。 4. 将最后一个函数添加到最终组合函数中。
overall_result["basic--llama3.1-70b"] = evalulation_full_dataset(test_set_small, f_8)
pretty_print_table(overall_result)
您可以得到以下输出:
0%|          | 0/20 [00:00<?, ?it/s]
is_valid_json correct_categories correct_sentiment correct_urgency
======================================================================================
basic--llama3.1-70b        100.0%              83.5%             30.0%           70.0%
您可以看到基础提示的结果。当您使用不同的输入示例重新运行代码时,输出差异显著。这为进一步提高提示准确性和相关性设定了基线。
到目前为止,在这个学习旅程中的关键收获是:我们可以创建一个基础提示,然后在数据集上评估该提示,为进一步增强设定基线。
本课小结
开发提示只是解决业务问题的一部分;严格且自动化的评估对于企业级生成式 AI 至关重要。通过利用 SAP Cloud SDK for AI,您可以实现自定义评估函数,以一致地衡量提示性能、验证输出质量(如 JSON 格式和提取实体的准确性),并在数据集上大规模应用这些评估。这种系统化方法让您能够建立清晰的基线,并迭代增强提示以满足关键业务需求。
本课其余配图
本课其余配图
本课其余配图
本课其余配图