分析生成式 AI 中枢中的文档接地
学习目标
分析 SAP HANA 向量引擎与文档接地。
集成专有数据以提供准确且具备上下文感知能力的响应,对于在企业解决方案中有效利用生成式 AI 十分重要。本单元聚焦 SAP 生成式 AI 中枢中的文档接地,这是将大语言模型(LLM)与业务数据结合时实现高精度和高可靠性的关键技术。
在本课中,你将了解 SAP HANA 向量引擎以及文档接地背后的核心原理。我们将首先延续设施管理的实践场景,以说明接地能够有效应对的真实业务挑战。这将为在编排服务中实施这些强大技术奠定基础,我们将在下一课中深入探讨。
场景:设施管理优化
Facility Solutions 公司为住宅和商业物业提供全面的设施管理、维护和清洁服务。其使命是打造安全、高效且维护得无可挑剔的环境,让客户能够专注于核心业务活动。该公司服务的市场多样,包括豪华住宅小区、独栋住宅,以及办公楼、零售场所、工业设施和教育机构等商业客户。
业务挑战:
该公司每天收到数千封电子邮件,内容涵盖客户请求、投诉和一般咨询。人工处理这些邮件(包括将数据传输到内部应用、分类和排定任务优先级)耗时、易错,并且经常导致关键客户需求被延迟处理。
此前的 AI 增强:
该公司此前利用生成式 AI 和提示工程来改进从客户邮件中提取信息的效果。这使他们能够针对特定任务查询 AI 模型,从而获得更准确的响应,并提升对客户请求和投诉进行分类和排定优先级的效率。
不断演变的挑战与生成式 AI 中枢解决方案:
尽管此前已取得进展,该公司在电子邮件管理方面仍面临重大障碍,需要更深入的集成与智能:
信息的结构化接地: 确保提取出的邮件信息以结构化格式接地以供内部应用使用,对于准确的分类和优先级排序至关重要。例如,维修请求需要将细节锚定在公司的系统中。生成式 AI 中枢通过 文档接地技术、 利用 SAP HANA 向量数据库 来存储和检索结构化信息,从而促进这一点。
借助嵌入实现上下文理解: 做出明智的决策需要更深入地理解邮件的上下文和语义。例如,识别客户不满的细微差别对于有效解决问题至关重要。生成式 AI 中枢的 嵌入模型 可以通过捕捉这一上下文来增强分类和优先级排序,从而实现更及时、更恰当的响应。
通过应对这些不断演变的挑战,该公司旨在进一步简化邮件分类和优先级排序、显著减少人工工作量,并提升其设施管理服务的整体效率与准确性。在本单元中,我们将看到生成式 AI 中枢如何实现这些解决方案。
向量嵌入
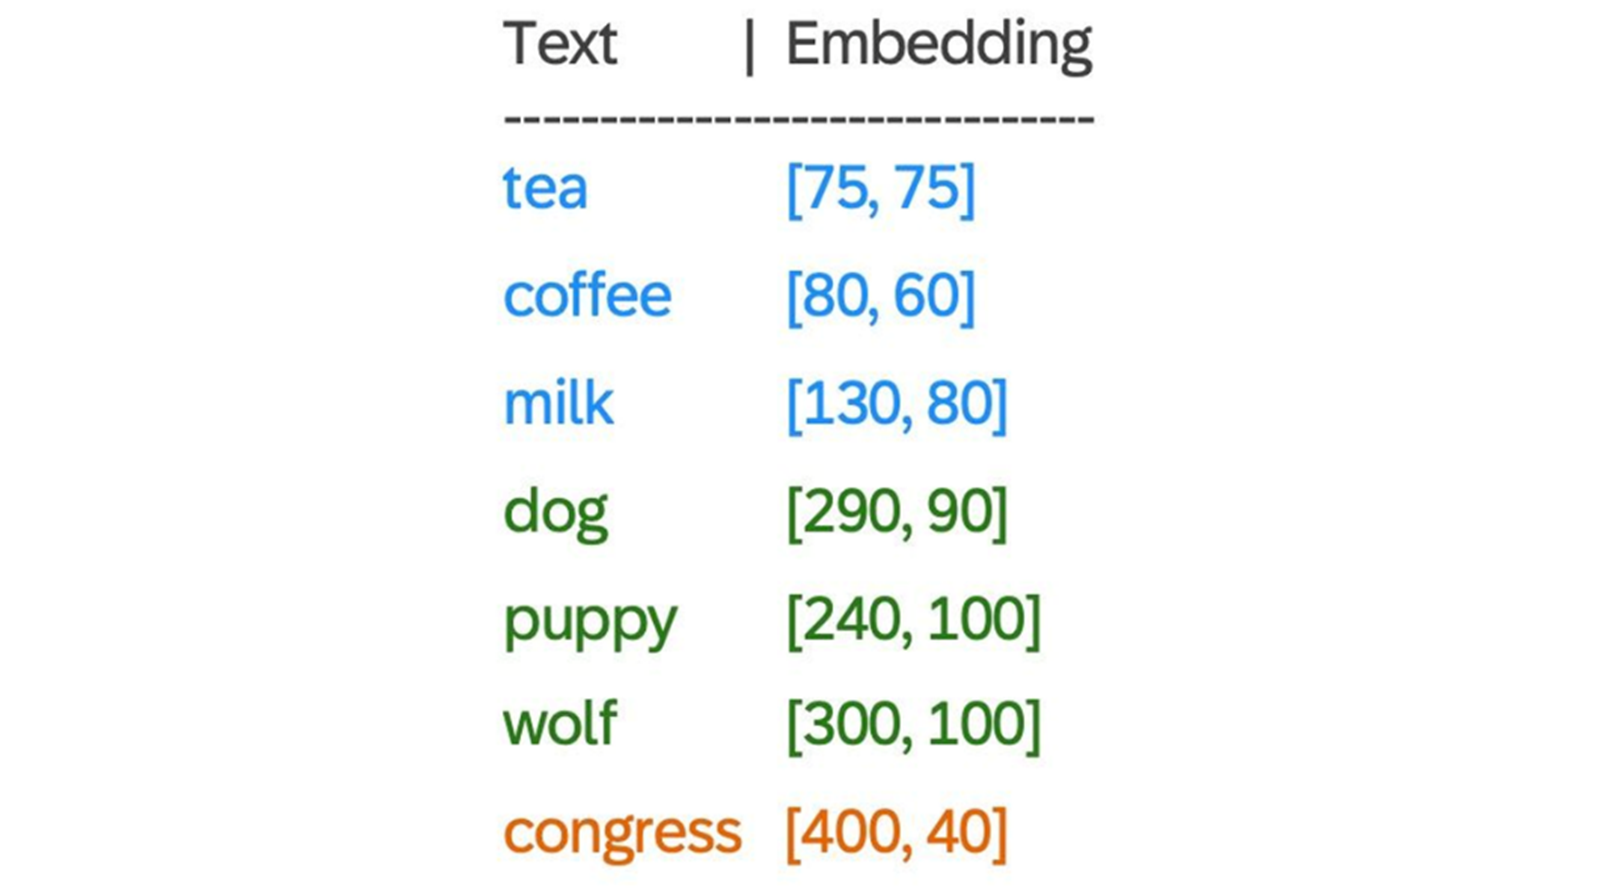
在生成式 AI 中,向量是一种编码对象特征的数学表示,通常是一个数字列表。嵌入就是这种从数据中学习得到的向量表示,它捕捉文本、图像或客户记录等对象的本质属性、语义关系和上下文含义。这些嵌入使机器能够以有意义的方式分析、比较和推理数据。
在 SAP HANA 向量引擎中,向量嵌入特指文本、图像或音频等各种数据类型的这类数值表示。文本嵌入模型是负责将文本转换为这类数值嵌入的模型。随后,这些表示会在 SAP HANA Cloud 的向量引擎中被高效存储和管理,该引擎是其多模态处理能力的关键组成部分。
该向量引擎支持对高维向量进行高效存储、检索和分析。这反过来又为语义搜索和检索增强生成(RAG)等高级应用提供支持。将向量嵌入与其他数据类型集成,有助于开发智能数据应用和自动化决策流程。
SAP HANA 向量引擎
SAP HANA 向量引擎是 SAP HANA Cloud 的核心特性,使你能够直接与业务数据一起存储、处理和分析高维向量,例如文本嵌入。该引擎是 SAP HANA Cloud 多模态处理能力不可或缺的一部分,支持与关系型、图、空间和文档数据的无缝集成。
SAP HANA 向量引擎的主要功能包括:
高效的向量管理: 它存储和管理数值向量嵌入,这些嵌入表示文本、图像或音频等各种数据类型。
高级 AI 应用: 它支持语义搜索和 RAG 等复杂应用,这些应用能有效地将 LLM 与业务数据和上下文结合起来。
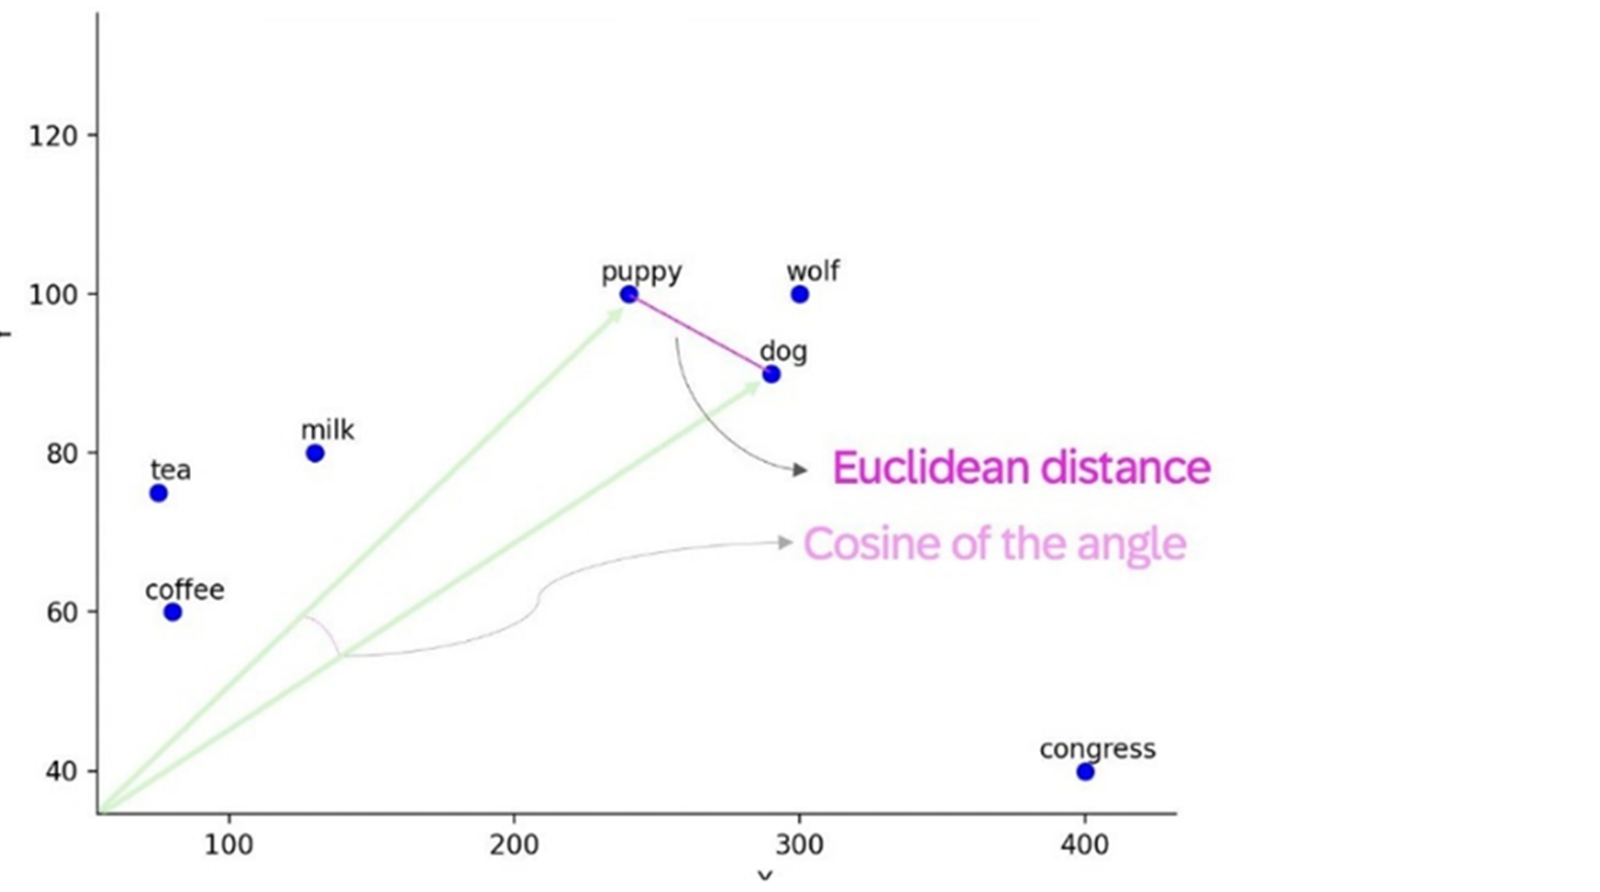
强大的向量搜索: 该引擎支持直接通过 SQL 进行高效的向量搜索,利用 L2DISTANCE() 和 COSINE_SIMILARITY() 等专用函数。
L2DISTANCE(): 该函数计算两个向量之间的欧几里得距离,常用于在高维空间中测量直线距离,以支持聚类和最近邻搜索等任务。
COSINE_SIMILARITY(): 该函数计算两个向量之间夹角的余弦值,表示它们的方向相似度。它广泛用于文本分析和信息检索,以确定文档或嵌入之间的语义相似度。
这些函数支持高效的向量搜索,并且可以与 SAP HANA Cloud 中的其他 SQL 操作无缝集成。该引擎通过应用向量表示中捕捉的语义含义,促进上下文感知的响应和自动化决策。
总体而言,SAP HANA 向量引擎增强了智能数据应用提供详细、具备上下文感知能力响应的能力,显著提升了 SAP HANA Cloud 中数据处理的整体效率与可扩展性。
生成式 AI 中枢中的文档接地
文档接地是一个复杂的过程,它将 LLM 与先进的信息检索技术相结合,以提升 AI 响应的质量和准确性。它无需为在公司的专有数据上训练或微调 LLM 而付出大量时间、复杂性和成本;相反,接地利用你组织可信的知识来源(例如人力资源政策手册)直接补充 LLM 的内部知识库,使模型更加准确和可靠。
在 SAP 生成式 AI 中枢中,嵌入模型在实现这一接地过程方面发挥着基础性且独特的作用。与生成式模型不同,嵌入模型本身不产生文本或答案。相反,它们是专门的 AI 组件(如文本嵌入模型),旨在将原始数据(例如文档分块或用户查询)转换为数值向量表示。这些向量捕捉数据的语义含义,使其在计算上可理解且可比较。这一能力对于实施 RAG 以及提升 AI 响应的上下文相关性和准确性至关重要。
该系统建立在若干相互关联的关键组件之上:
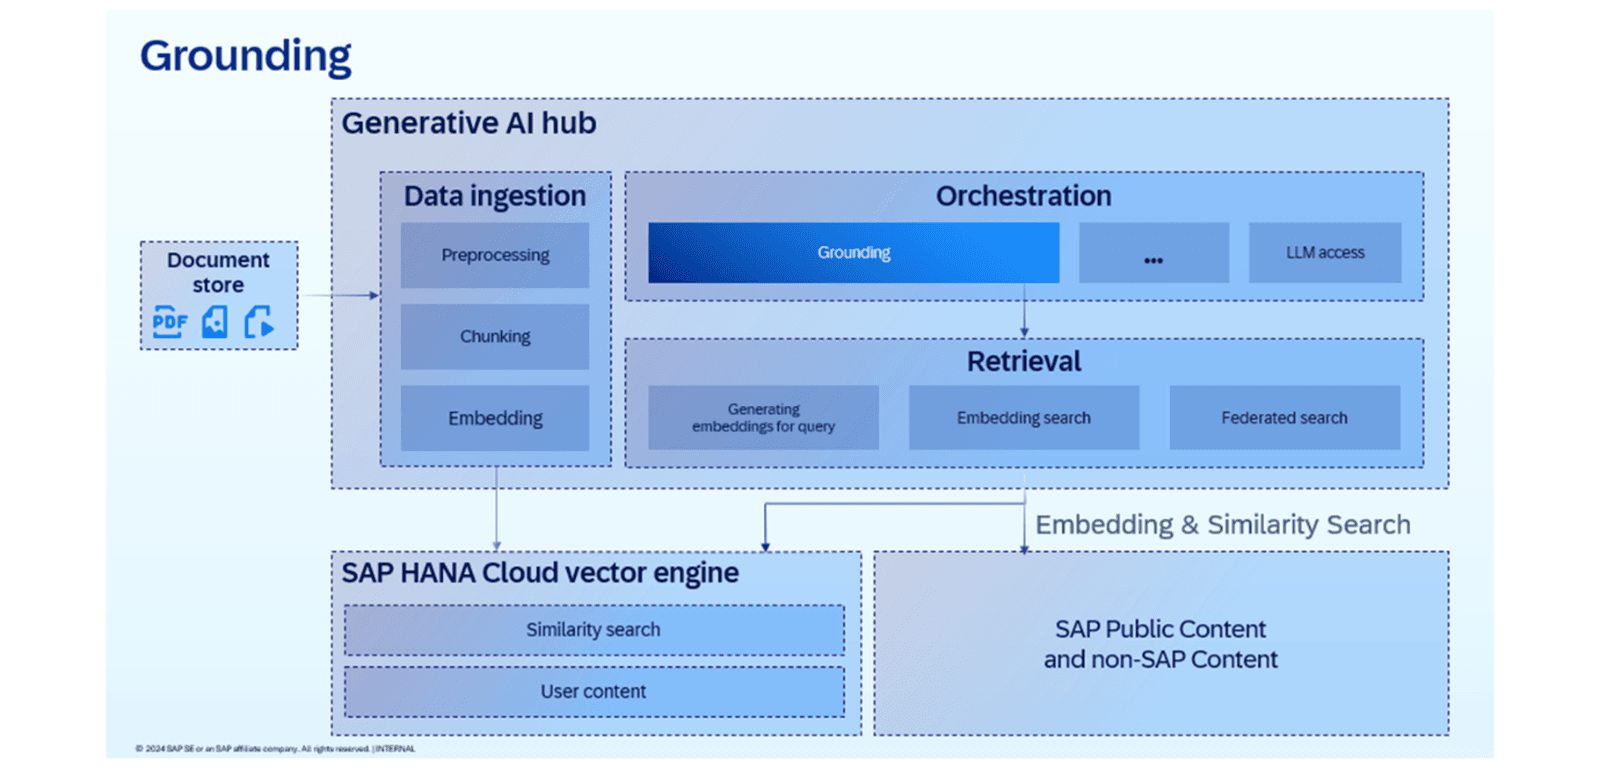
文档存储:这个集中式知识库存放各种文档类型(例如 PDF 和文本文件)。
生成式 AI 中枢:该中枢充当中央协调者,管理整个信息处理与检索过程。它编排三个主要阶段:
数据摄取:传入的文档被预处理、切分为更小的分块,并使用嵌入模型转换为数值向量嵌入。
编排:该阶段管理整体工作流,包括接地过程以及与 LLM 的交互。
检索:通过嵌入和联合搜索(跨多个数据源)检索相关信息。查询嵌入会被动态生成,以支持高效的相似度搜索。
SAP HANA Cloud 向量引擎:该组件为基于生成的嵌入执行相似度搜索提供基础基础设施,有效地存储用户提供的内容。
嵌入与相似度搜索:这一关键功能将检索阶段与 SAP 和非 SAP 内容源连接起来,根据查询嵌入与文档嵌入之间的相似度匹配信息。
从本质上讲,该系统摄取文档,将其转换为可搜索的格式,然后智能地使用嵌入和联合搜索技术,根据用户查询检索最相关的信息。这最终促成 LLM 生成更健壮、更有依据的文本。
本课小结
本课介绍了文档接地作为一种关键技术,它通过将 LLM 与外部可信知识源连接来增强生成式 AI 的响应。我们探讨了一个设施管理场景,以说明接地所应对的业务挑战,随后深入研究了向量嵌入和 SAP HANA 向量引擎等基础概念。你了解了生成式 AI 中枢如何编排这一过程,利用这些组件交付准确、上下文相关且可靠的 AI 输出,为你进行实际实施做好了准备。
本课其余配图