描述 SAP HANA 在 SAP BW/4HANA 中的作用
学习目标
描述 SAP HANA 如何为 SAP BW/4HANA 提供强大动力
利用最新技术
SAP HANA 是一个高性能的内存数据库。SAP HANA 包含许多功能,可确保 SAP 和非 SAP 应用程序以最高速度运行。
SAP HANA 为 SAP BW/4HANA 提供强大动力,并带来两项关键收益:
数据加载和报表的高性能
存储海量数据
让我们从性能开始:
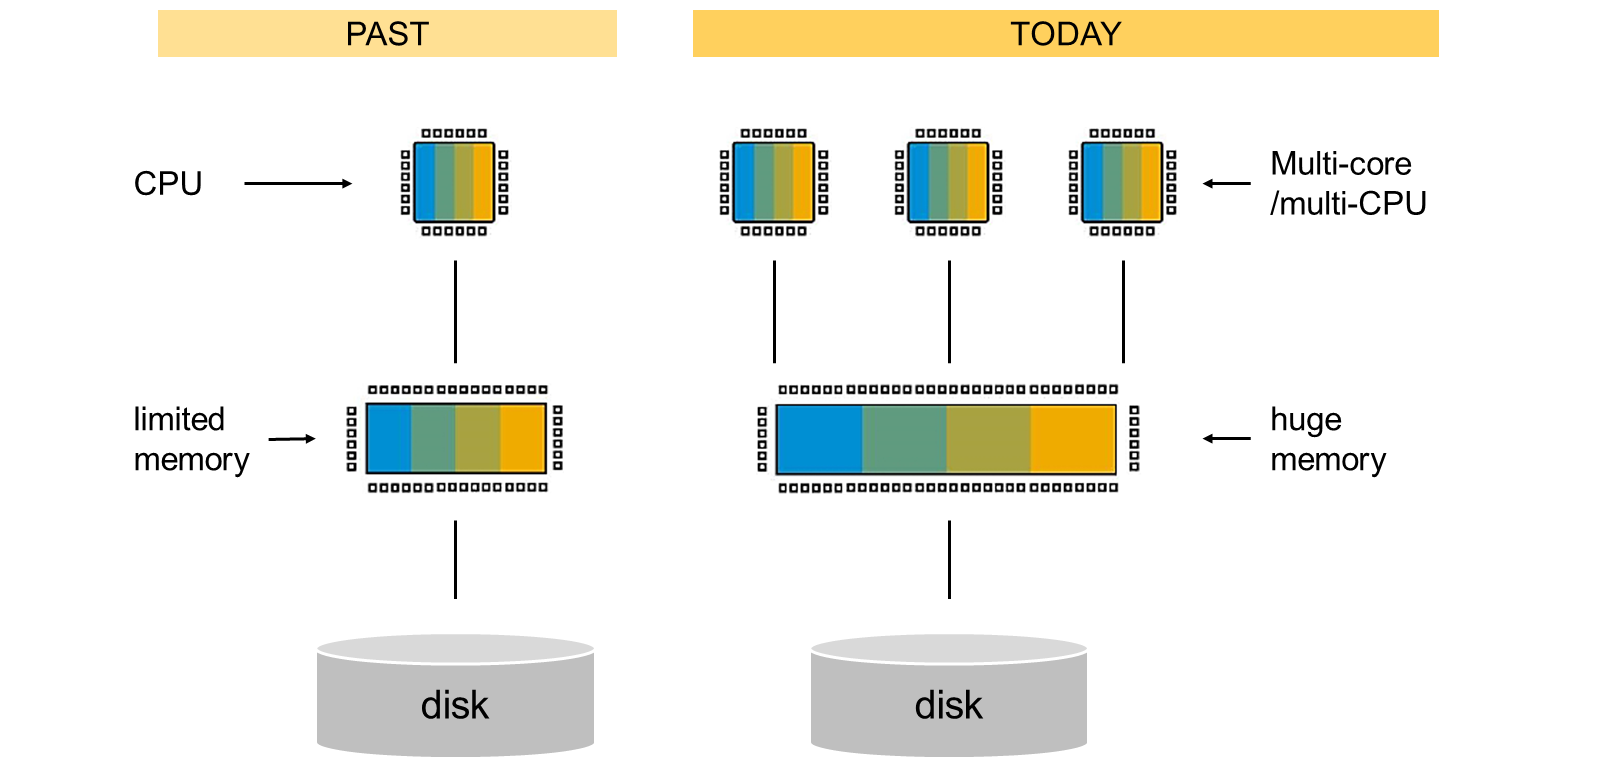
我们能够使用的计算能力比以往任何时候都更强大。近年来,我们看到内存容量急剧增长。
此外,CPU 性能继续以惊人的速度提升。我们现在拥有高速多核 CPU,它们能够承担复杂任务并将其拆分,从而可以并行处理,提供令人难以置信的响应时间。这意味着即使是最复杂的分析任务(例如预测分析),其响应时间也可以实时完成。因此,凭借巨大的内存和更快的多核 CPU,我们现在能够使用大量的计算能力。
许多数据库依赖磁盘进行数据存储,但 SAP HANA 使用非常大的内存进行数据存储。
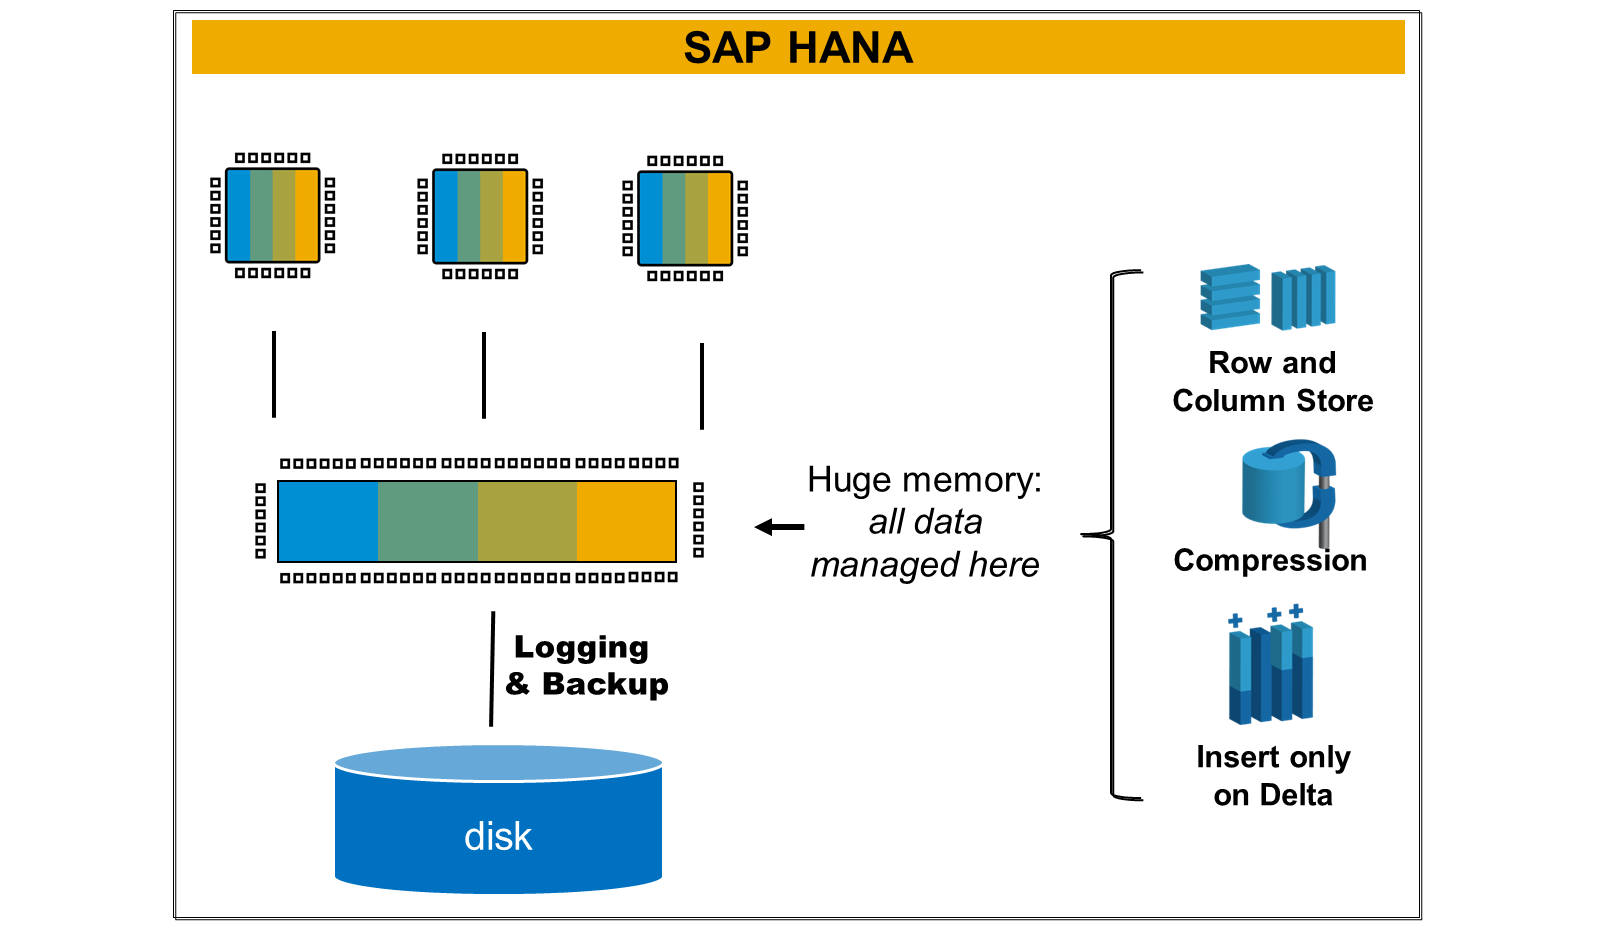
SAP HANA 是为在使用多核处理器和巨大内存的最新硬件上运行而构建的。SAP HANA 的强大能力直接影响 SAP BW/4HANA 的性能。通过利用众多 CPU 上的多个核心,数据加载更快,查询以非常高的速度运行。
SAP HANA 数据库的概念
SAP HANA 数据库的三个主要特性如下:
行存储和列存储
列存储的压缩
仅在增量上插入
1. 行存储和列存储
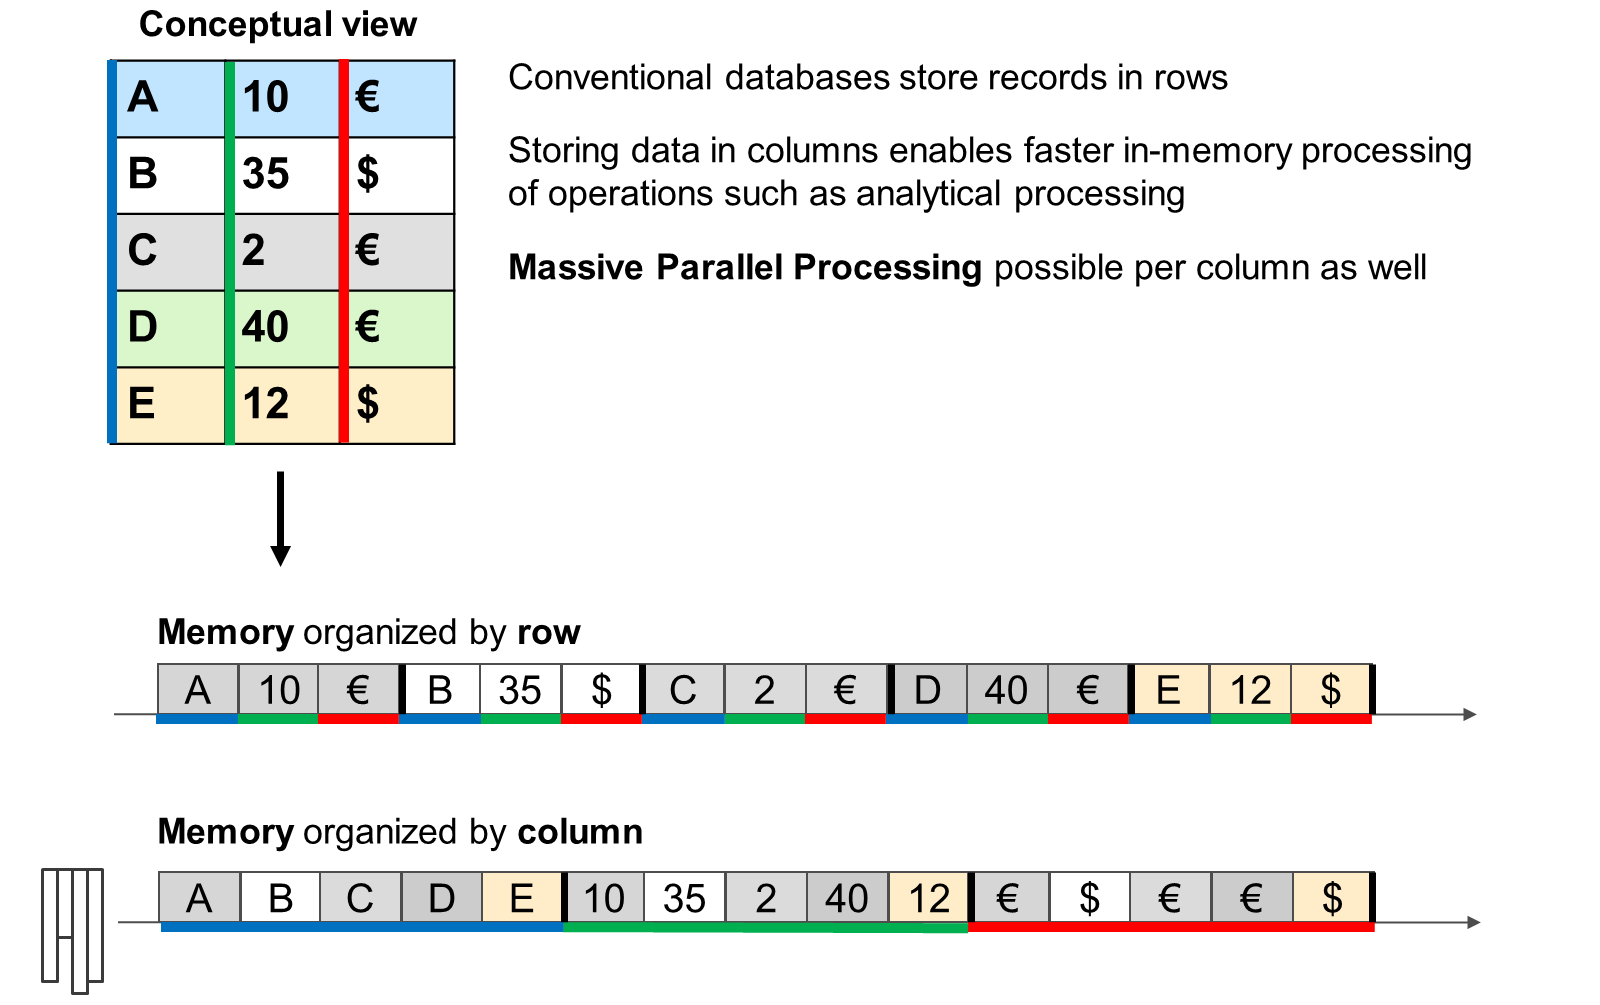
SAP HANA 支持大多数数据库中常见的传统行表架构,但也支持列表。列表对于分析用例是最优的。数据仓库,尤其是查询功能,是列表的理想用例。SAP BW/4HANA 使用列表。
使用列表而不是行表(尤其是在查询数据时)有一个非常好的理由。典型的查询通常只请求表中的少数几列。对行表的查询会处理表的所有列,即使是那些您在查询中未请求的列。但对列表的查询只处理所请求的列。仅处理所请求的列可以提高查询性能。
当 SAP 系统迁移到 SAP HANA 时,SAP 表会自动迁移到最适合的存储类型。此逻辑由 SAP 定义。
所有表的绝大多数(>90%)存放在列存储中。
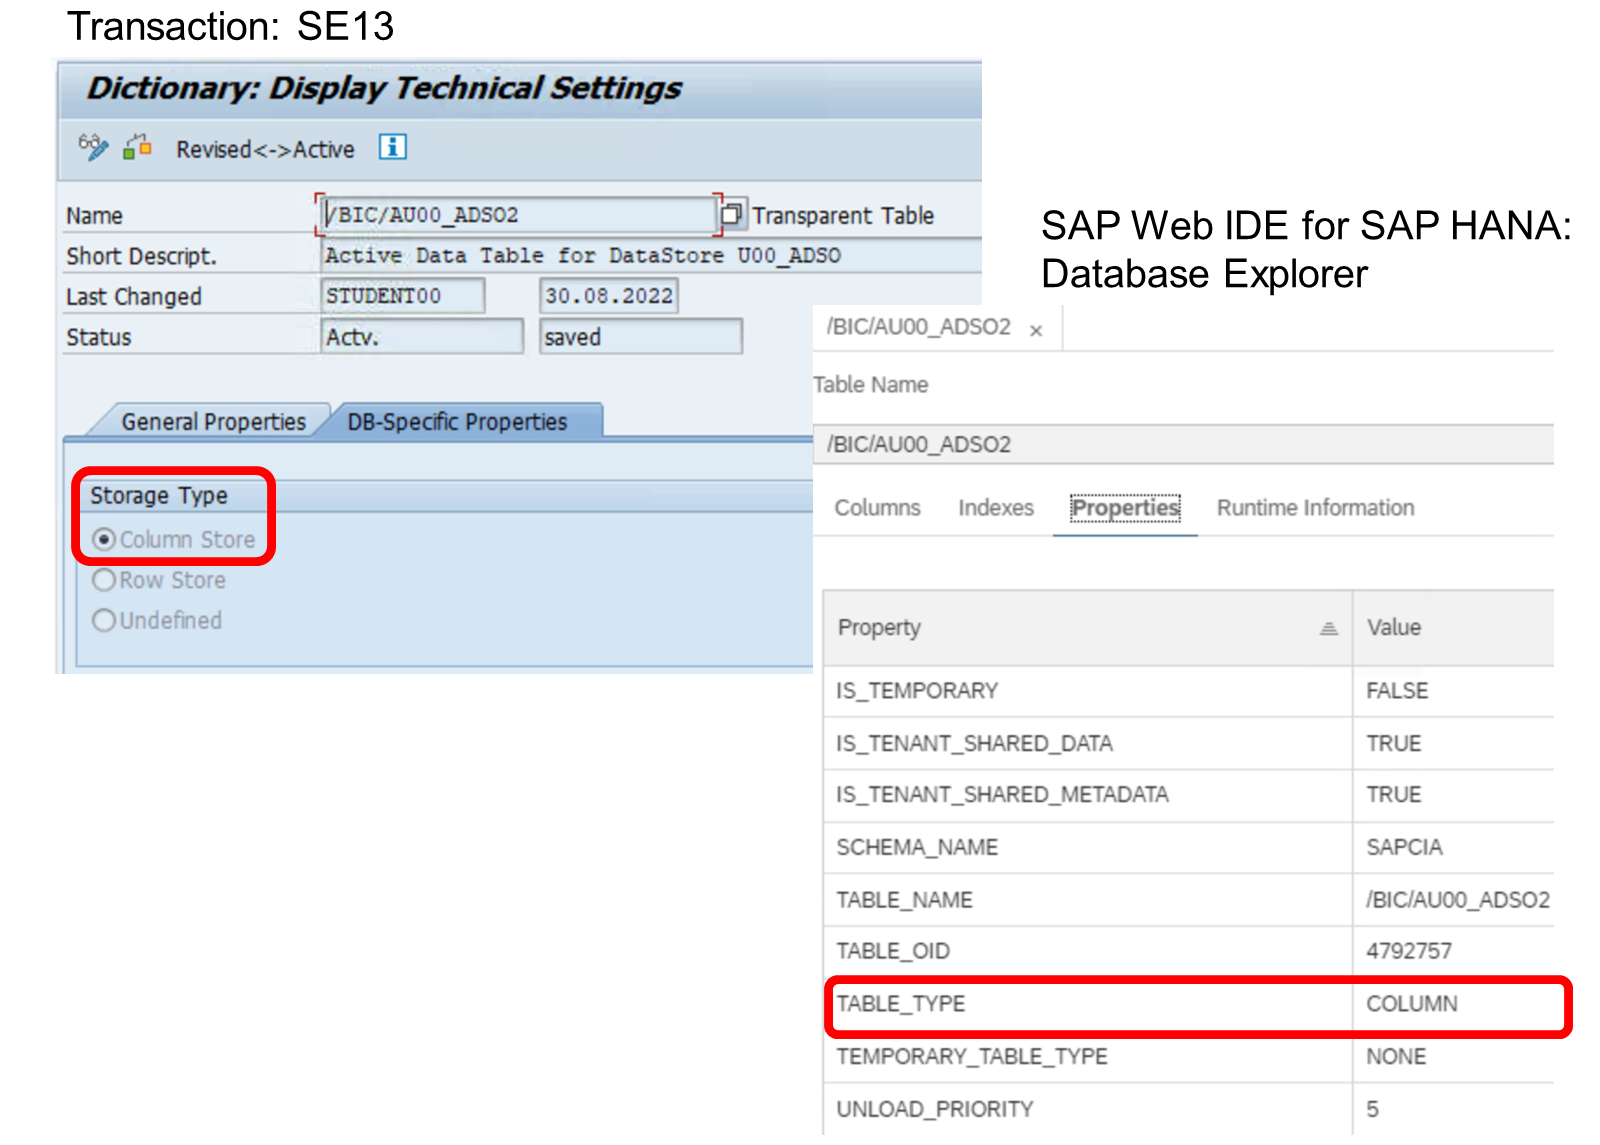
SAP BW/4HANA 数据模型的表全部位于列存储中。此信息可以通过 SAP BW/4HANA 的 ABAP 数据字典 在每个表的技术设置中(事务 SE13)访问,也可以在 SAP HANA 的 SAP Web IDE(集成开发环境) 的数据库浏览器中访问 。您将在本学习路径的后续部分使用此环境。
2. 列存储的压缩
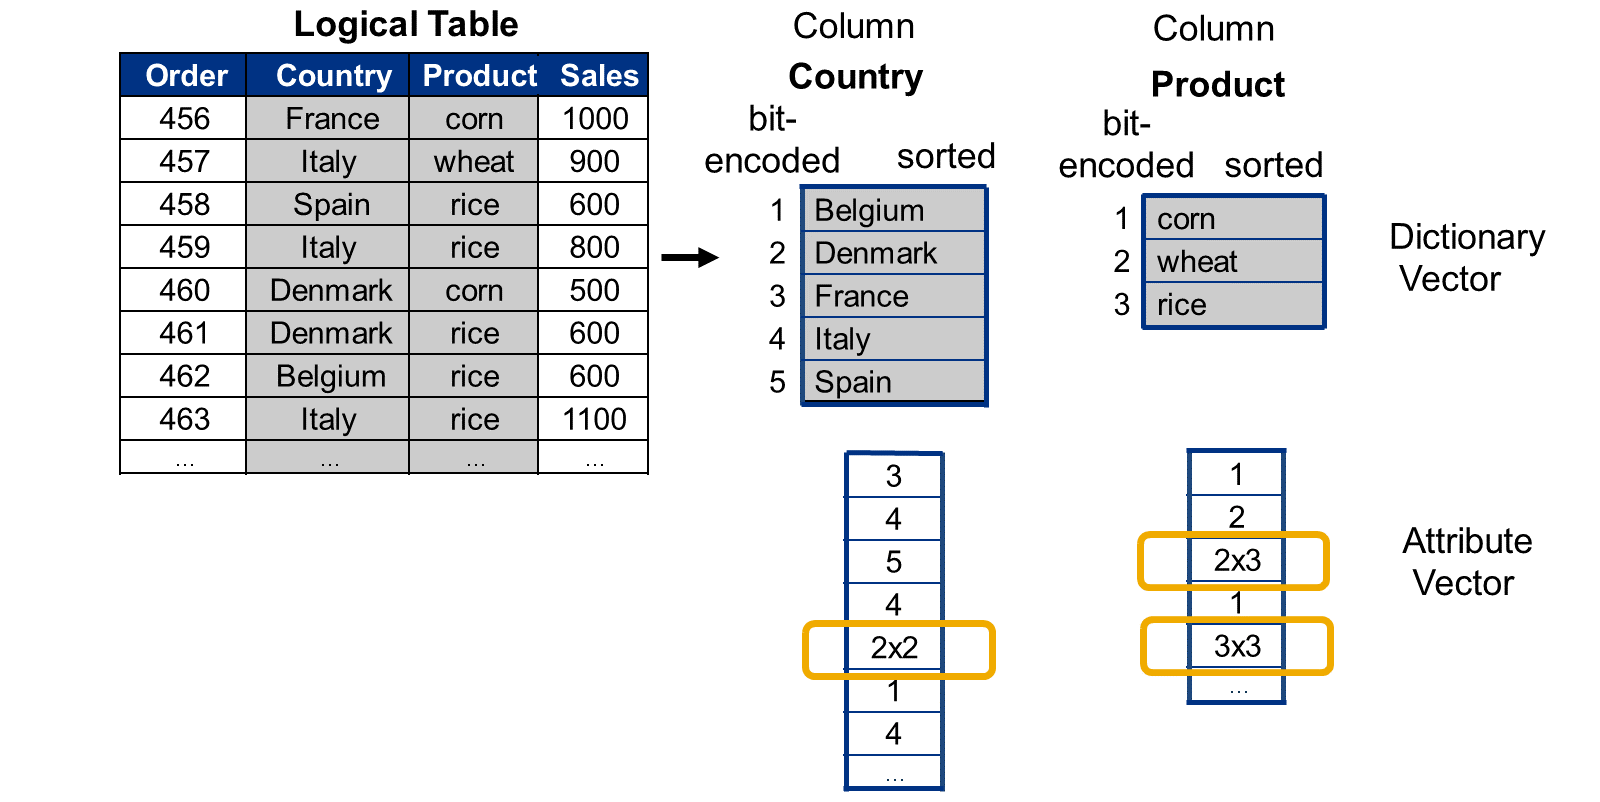
使用列表的另一项额外好处是表中的数据会自动压缩。在列的字典向量(Dictionary Vector)中,值经过排序并进行位编码。在列的属性向量(Attribute Vector)中,值的位置被表示出来,并在值重复时进行压缩。数据压缩大幅缩减表的占用空间,最多可减少 90%。这意味着与行存储相比,我们可以在 SAP BW/4HANA 中容纳更多数据。
3. 仅在增量上插入
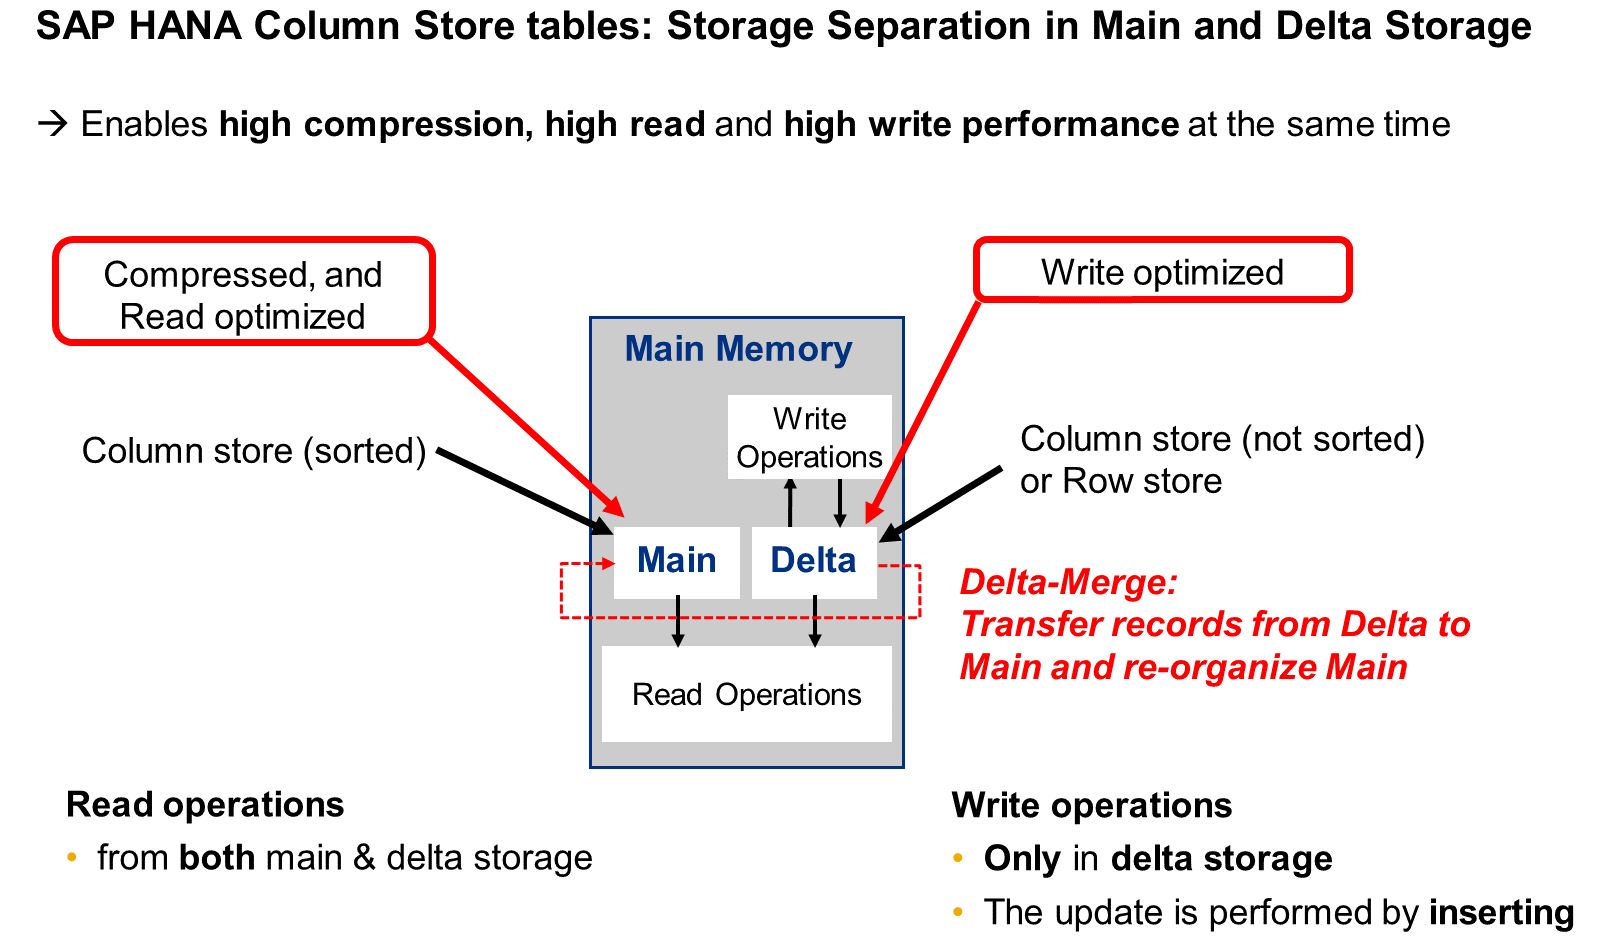
列存储使用高效的压缩算法,有助于将所有相关应用程序数据保留在内存中。将数据更新和插入到已排序的列表是一项代价高昂的操作,因为必须重新生成排序顺序,因此每次都要重组整个表。
为此,SAP 将这些表分为主存储(读优化、已排序列)和增量存储(写优化、未排序列或行)。所有更改都进入这个称为增量存储的独立区域。
有一项定期数据库活动会将增量存储合并到主存储中。此活动称为增量合并(Delta Merge)。
Note
更多详细信息请参阅以下来源:
SAP note 2000003: FAQ SAP HANA
SAP note 2222277: FAQ SAP HANA Column Store and Row Store
SAP note 2112604: FAQ SAP HANA Compression
SAP note 2057046: FAQ SAP HANA Delta Merge
SAP HANA Product page https://www.sap.com/products/technology-platform/hana.html
Blog: The secret of SAP HANA – Pssst! Don't tell anyone! https://community.sap.com/t5/technology-blogs-by-sap/the-secret-of-sap-hana-pssst-don-t-tell-anyone/ba-p/13445334
软件优化
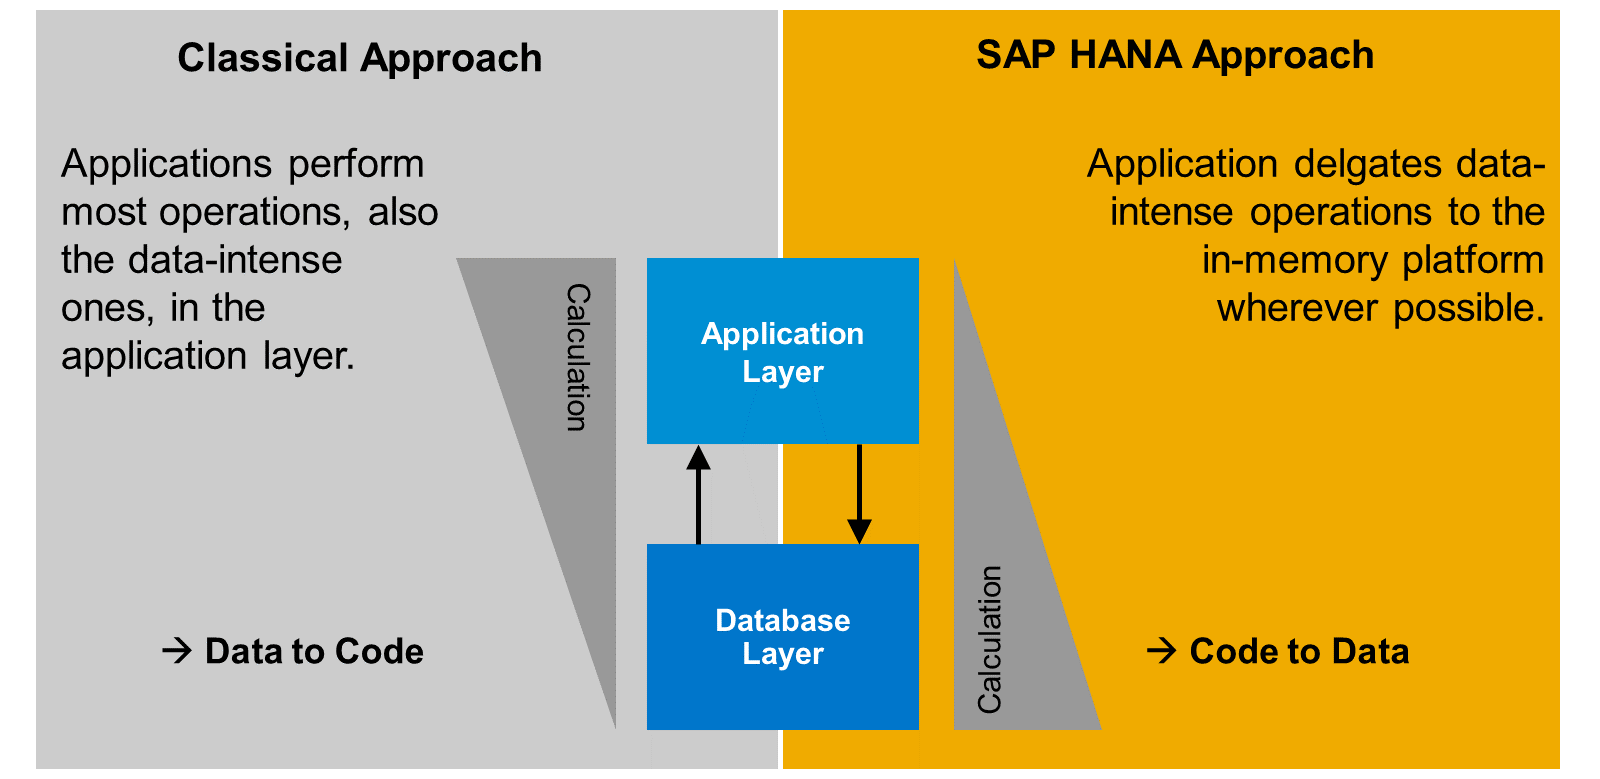
在 SAP HANA 之前,三层架构(数据层、应用层和表示层)会从数据库读取数据,然后在其内存中处理数据,再将结果写回数据库或发送到表示层。考虑到当前业务软件、传感器和社交网络产生的海量数据,这一概念是有问题的。您还必须快速评估数据量并在移动平台上交付结果。旧的范式已不再可行。
内存技术将所有数据存储在内存中。现代计算机系统拥有许多计算核心,提供令人印象深刻的性能。因此,显然应该移动指令而不是数据。基于 SAP HANA,您可以将数据密集型处理逻辑从应用层转移到数据层,并在数据层中执行该过程。
SAP HANA 随附不同的引擎来处理计算逻辑和执行编程代码。它提供了一个绝佳的机会,可以将数据密集型计算从 SAP ABAP 应用层下推到 SAP HANA 数据库中。
为此,SAP ABAP 已经过优化,以利用 SAP HANA 的高级内存特性。这一过程始于 SAP NetWeaver 7.3,并将在未来于 SAP BW/4HANA 的 ABAP 堆栈中持续增强。这些增强减少了应用层与数据库层之间的数据传输,并实现了资源的高效利用。
应用层更多地侧重于编排和默认触发数据库内的处理(例如数据存储对象(高级)的请求激活、压缩、重新建模、选择性删除、请求管理、数据分层等),或者提供用户界面以使用 SAP HANA SQL Script 而非 SAP ABAP 开发客户特定逻辑(例如转换的开始/结束/字段/专家例程)。最终,复杂逻辑可以快速处理,从而提升性能。
与 SAP HANA 相关的软件创新的主要概念可以概括如下:
将逻辑带到数据存储所在之处。
将代码从应用层下推到数据库层。
先计算,然后只移动结果。
SAP BW/4HANA 中数据密集型计算的示例包括:
加载和转换数据
数据管理(数据存储对象(高级)数据的激活)
查询处理(OLAP)
计划
SAP HANA 扩展 SAP BW/4HANA 的功能
应用程序的底层技术通常对应用程序的开发人员和用户不可见。SAP HANA 在 SAP BW/4HANA 中扮演着非常重要的支撑角色;不仅提供高性能和海量数据存储,还提供附加功能。
具体而言,SAP BW/4HANA 有两个关键功能领域由 SAP HANA 扩展:
数据建模
数据获取
视频:本节含 SAP 官方视频(视频 ID
1_g4n5v7zl),需在 learning.sap.com 在线观看。
将 SAP HANA 数据模型与 SAP BW/4HANA 数据模型相结合,汇聚了两个建模环境的强大能力。
强大的内存数据模型使用一种称为计算视图的建模对象直接在 SAP HANA 中构建。计算视图使用图形化工具构建,包含 SAP BW/4HANA 中的许多建模特性。但是,也有许多 SAP BW/4HANA 中不具备的附加特性。这些包括高级排名函数、生成数据交集,以及将自定义 SQL 代码嵌入数据模型。
SAP HANA 提供到任何平台上任何类型数据源的连接器。SAP BW/4HANA 利用这一能力来访问任何数据,用于提取和加载,或用于直接访问远程源。
本课其余配图
本课其余配图
本课其余配图
本课其余配图