应用分类、回归和时间序列分析
学习目标
确定应用分类、回归和时间序列分析技术的用例
本课介绍 SAP HANA 的三种关键机器学习方法:回归、分类和时间序列分析。
这些方法可用于各种场景,例如:
回归:根据模型特征和市场趋势预测汽车价格的有效性。
分类:有助于预测客户行为,包括客户流失、欺诈检测和采购模式。
时间序列分析:根据历史数据预测未来销售、需求、成本和其他指标的理想选择。
无需
线性回归:房屋价格作为房屋居住面积的函数(尺寸)
线性回归是最广为人知的统计技术之一。了解它对于欣赏各种基于线性回归模型(如"广义线性模型")的开发至关重要。
线性回归有助于发现输入和输出数值变量之间的线性关系(即直线关系),使其成为预测和统计建模的常用技术。
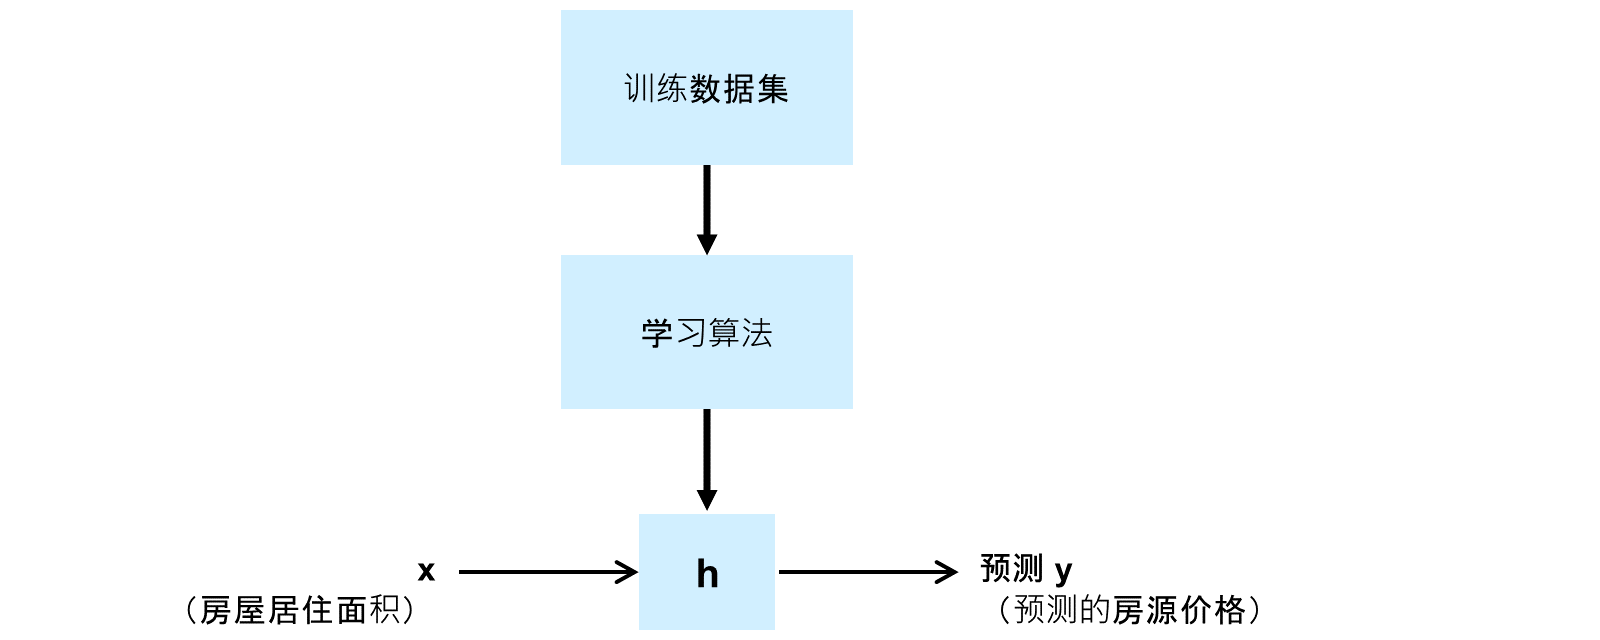
在显示的图中,变量 'x' 表示房屋居住区的值集,而变量 'y' 表示房子的价格。
变量"y"的连续值由"h"预测:将"x"的值映射到"y"的函数。
为简单起见,该图仅说明了房屋的一个数据属性,即居住区。在这种情况下,预测器变量 'x' 是连续的。
无需
回归:从数据训练简单模型
与上图类似,下图显示了 x 轴上的输入变量(房屋居住区域)和 y 轴上的输出变量(房源价格)。
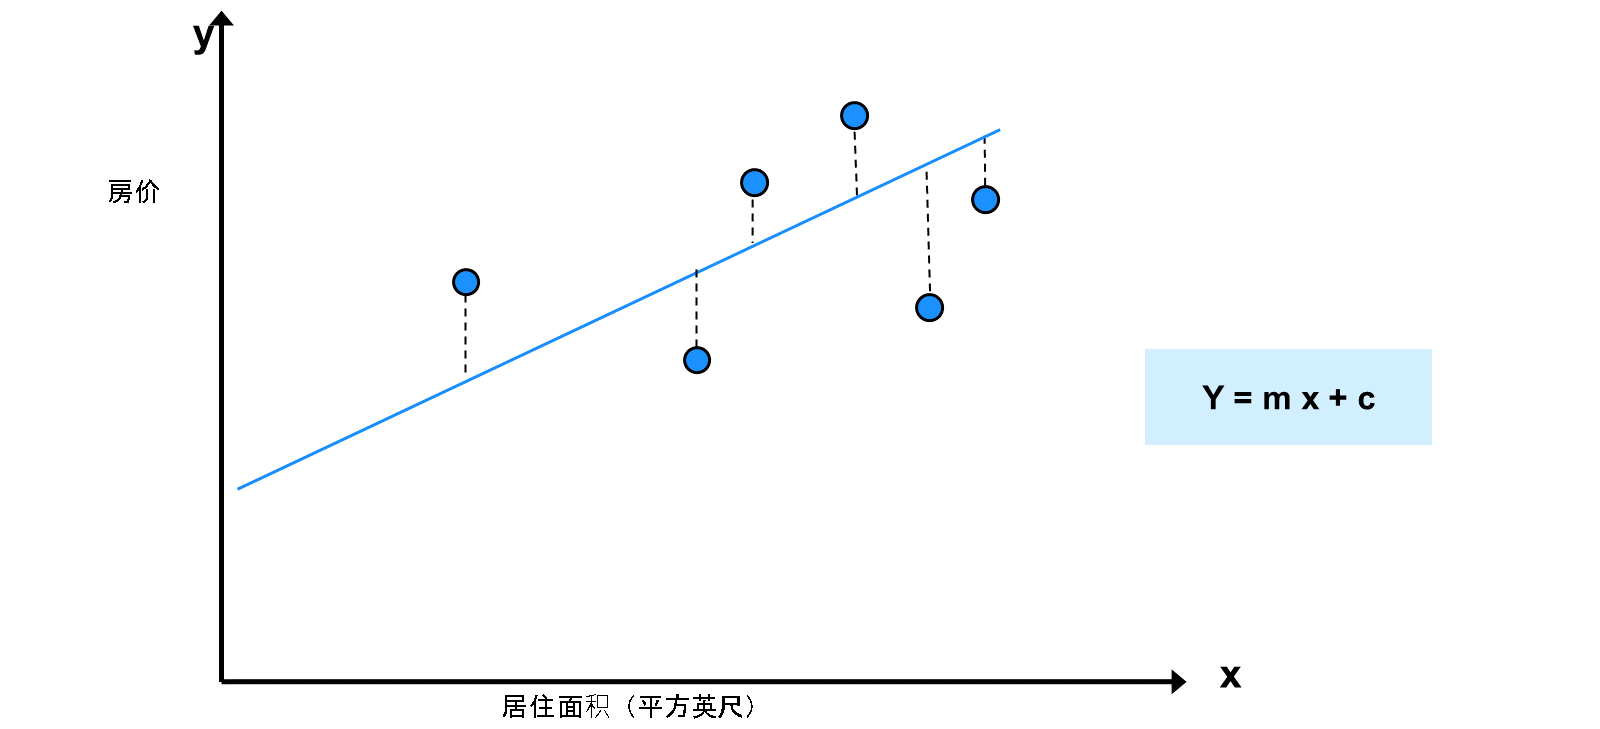
目标是构建 一个以房屋居住面积为投入的模式,并预测房价。图中的数据点表示来自数据集的观测项。通过将线条拟合到这些数据点,将创建模型。该线的方程是 Y = m x + c,其中 'm' 是线的斜率,'c' 是 y 截距,即线跨越 y 轴的点。
无需
回归 - 模型的性能测量:均方误差 (MSE) 或 L2 损失
接下来,必须评估模型与数据集的匹配程度,该数据集由损失概念确定。损失计算预测值与真值之间的差异(基本事实)。
均方误差 (MSE) 或 L2 损失是一个损失函数,用于计算 'rant-in' 给定的预测与 'yi' 给定的实际样本值之间的平方差平均值。
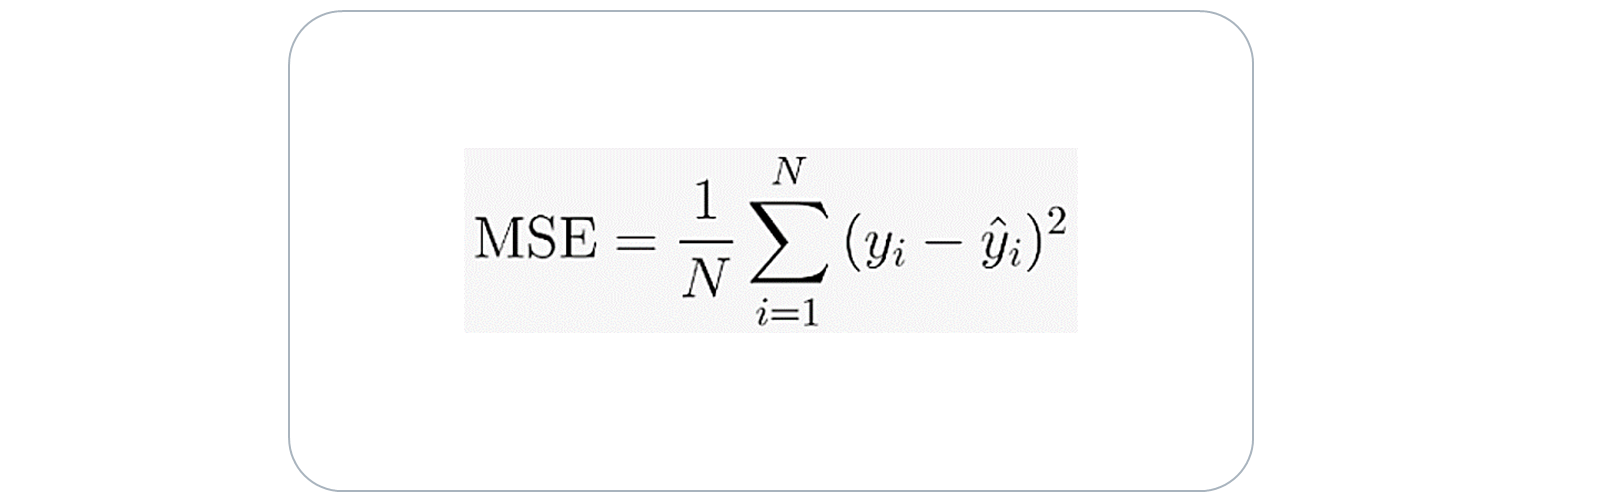
MSE = 均方误差
N = 数据点数
yi = 观测值
rei = 预测值
无需
什么是分类?
分类是一种基本的机器学习技术,旨在将输入数据组织到不同的类中。例如,下图说明了分类模型如何确定传入消息是否属于 SPAM 或收件箱(非 SPAM)类别。
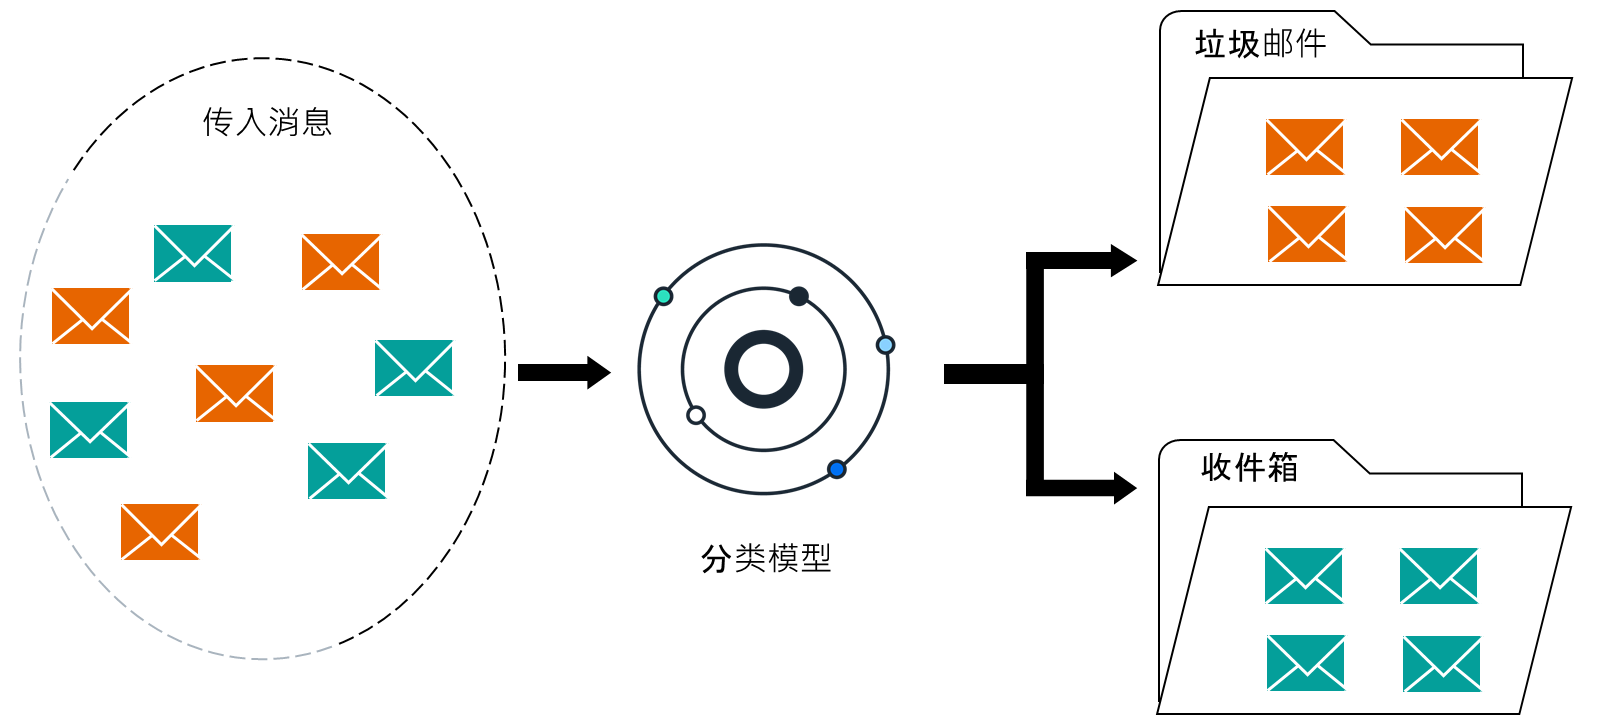
在分类过程中,模型使用"训练子集"功能进行训练,然后使用"测试子集"功能进行评估。
分类和回归任务之间的显著区别在于其输出变量。分类处理离散目标变量时,回归任务涉及连续输出变量,如先前部分中所述。
无需
时间序列分析
时间序列数据是收集的关于不同时间点的主题的数据。例如,按年计算的国家出口、特定公司在一段时间内的销售额,或每分钟服用的人血压。以不同时间间隔连续捕获的任何数据都是时间序列数据的类型。
例如,下图说明了英国每年平均温度,以摄氏度计,可追溯到 1800 年至今。数据来源于 Met 办公室或气象局 had-UK 网格数据集。meet办公室是英国的全国天气和气候服务。
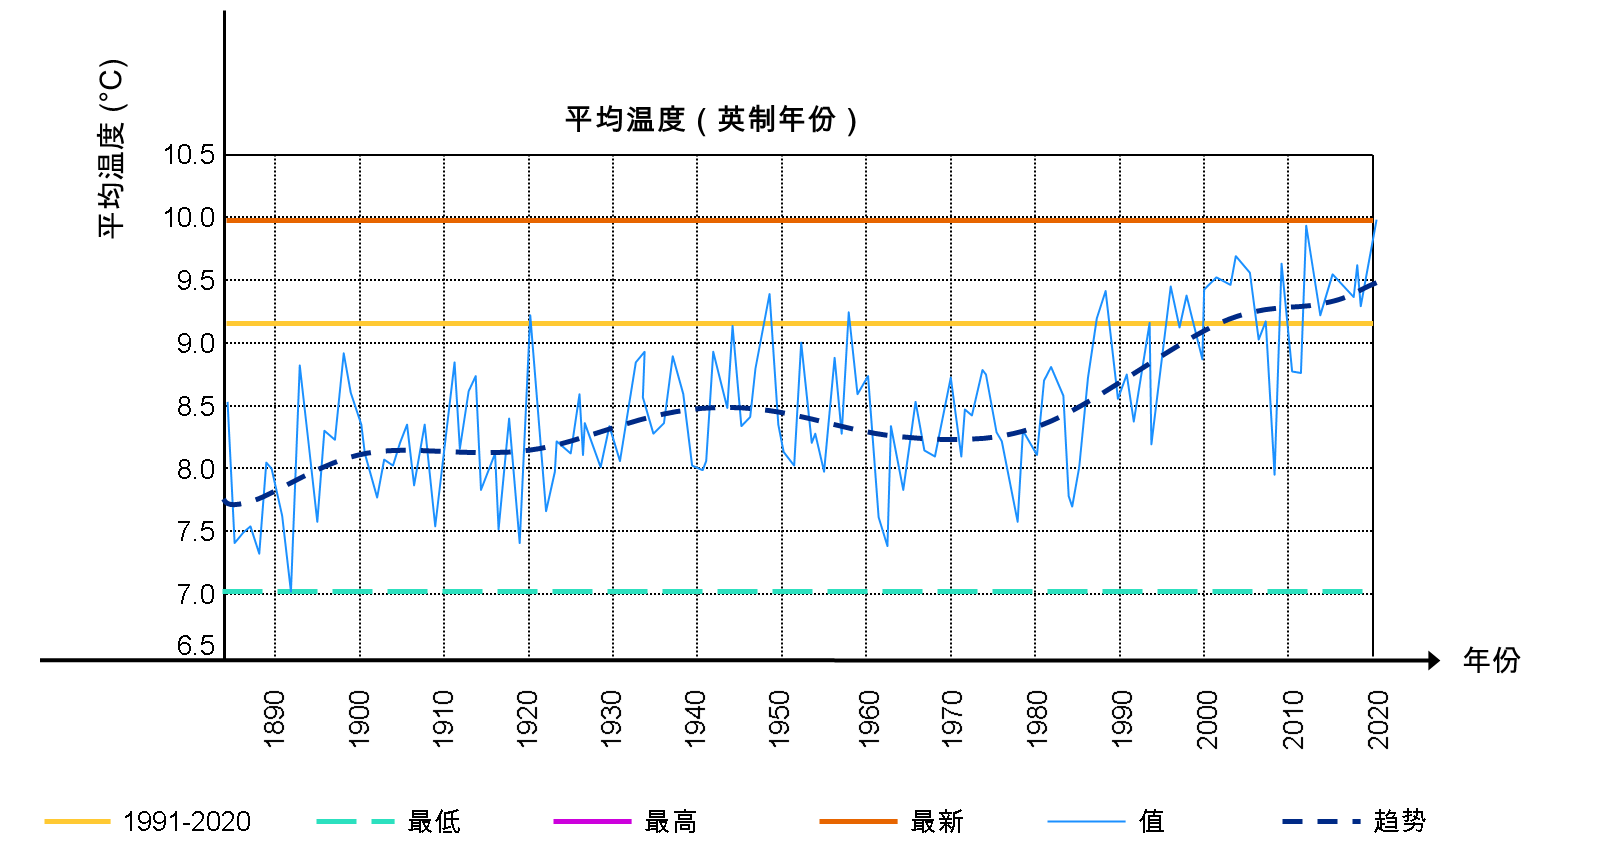
参照 Met 办公室新闻团队的博客(https://blog.metoffice.gov.uk/2023/07/14/how-have-daily-temperatures-shifted-in-the-uks-changing-climate/),您可以发现,利用 30 年的气象平均周期,显示英国在最近期间(1991-2020)与前一期间(1961-1990)的平均平均温度相比增加了近 1 摄氏度。这个历史时间序列数据揭示了长期回暖趋势。
无需
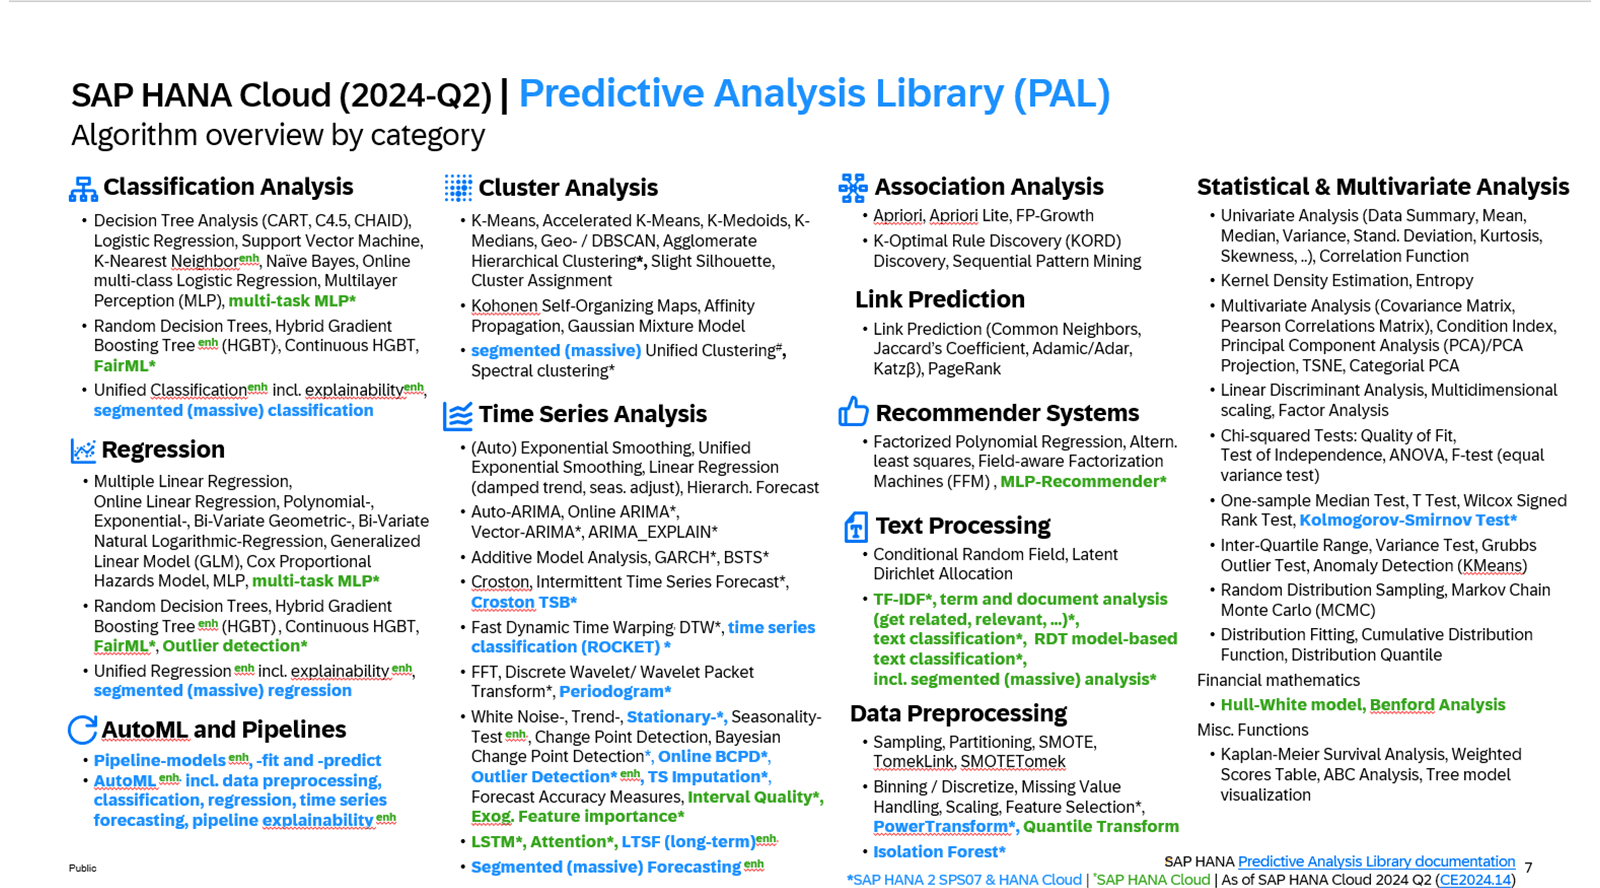
SAP HANA 中的算法概览
SAP HANA 在分类、回归和时间序列分析等类别中实施了各种算法。
分类的典型算法包括:决策树分析(CART、C4.5、CHAID)、逻辑回归、支持向量机、K-最近的邻居、朴素贝叶斯、混淆矩阵、AUC、在线多类逻辑回归等。
而对于回归,典型算法包括:多元线性回归和在线线性回归等。
最常见的时间序列分析算法包括:(自动)指数平滑法、统一指数平滑法、线性回归(阻尼趋势、海洋调整)、层次结构预测等。
有关更多详细信息,请参阅机器学习信息图 | SAP Help Portal