探索编排服务的用例
学习目标
通过实际用例展示编排工作流的价值。
本课从理论走向实践。我们将探索几个编排工作流,展示其特定的步骤序列如何将强大的 LLM 转变为真正可靠、合规且集成的企业资产。您将了解这些服务如何在结构化但高度可适配的流水线中协同工作,以交付稳健的 AI 解决方案。
编排工作流
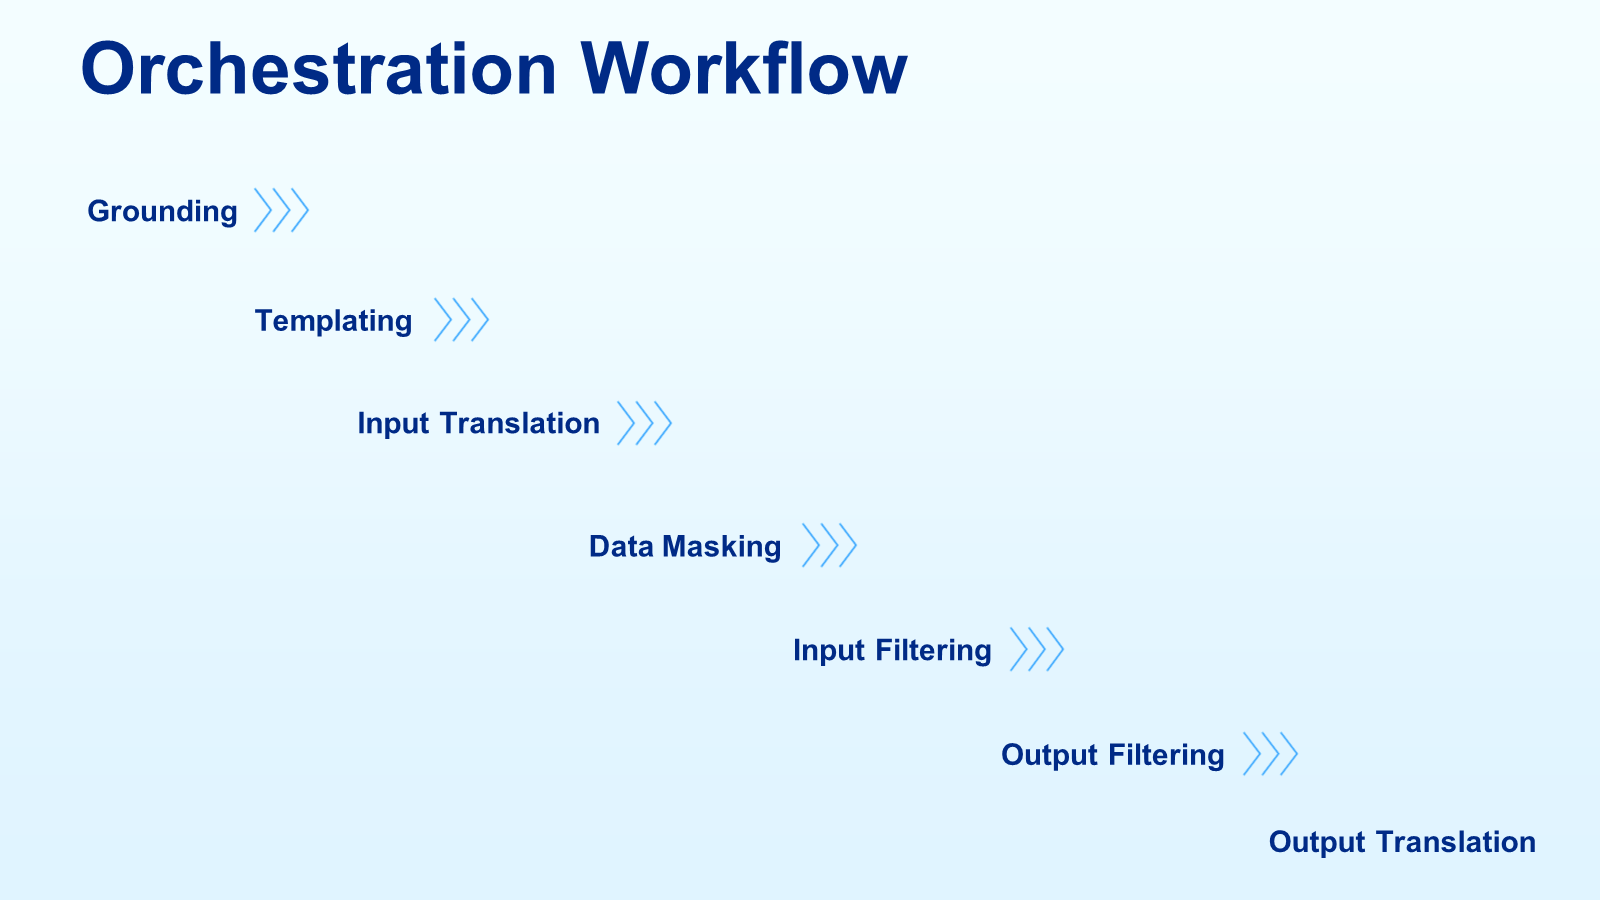
当编排服务的各项功能按特定顺序协同工作时,其效果最佳。单次 API 调用即可触发一个复杂的多步骤流程,为 LLM 准备数据并保护输出。标准工作流的结构如下:
用户输入: 初始查询或数据,通常来自最终用户或上游应用程序。
锚定(Grounding): 基于用户输入,系统从指定的企业数据仓库中搜索并检索相关的、事实性的、最新的信息。这些仓库的示例包括 SAP Help Portal、内部文档、主数据等。这确保 LLM 的回答基于事实。
模板化(Templating): 检索到的锚定数据、原始用户输入以及预定义的系统指令(其中可包含 LLM 角色设定和响应生成规则)会使用预配置的模板组合成一个完整的提示。
输入掩码(Input Masking): 这一关键步骤会扫描模板化后的提示,查找个人可识别信息 (PII) 或其他敏感数据(例如电子邮件、姓名、地址、电话号码)并对其进行假名化处理。这确保敏感数据不会直接暴露给 LLM。
输入过滤: 随后,被掩码处理的提示会由内容安全服务(例如 Azure Content Safety)扫描,以发现任何有害、有毒或不当的内容,然后再发送给 LLM。
输入翻译: 如果主 LLM 处理的语言与用户输入的语言不同,则整个经过过滤和掩码处理的提示会被翻译为 LLM 的工作语言,例如从德语翻译为英语。
LLM 处理: 经过充分准备、安全、掩码、过滤和翻译的提示被发送到选定的 LLM,由其处理该输入并生成响应(通常以其工作语言,例如英语)。
输出过滤: LLM 生成的响应会由内容安全服务扫描,以发现任何有害、有毒或不当的内容,然后再返回给用户或下游应用程序。
输出翻译: 如果原始用户输入使用不同语言,则最终安全的 LLM 响应会被翻译回用户的母语,例如从英语翻译为德语。
虽然编排模块的顺序是预先确定的,以确保稳健的安全性、数据完整性和合规性,但每个模块的配置和激活都高度灵活,并可根据您的具体用例定制。这意味着您可以控制模块是否激活、如何运行以及使用哪些参数,从而使工作流既可靠又可适配。
例如,您可以配置严格的输入过滤但较宽松的输出过滤,或者根据所处理的数据为掩码指定不同的 PII 实体。这种固定结构与动态配置之间的平衡正是该服务强大之处。
用例 1:自动化技术支持响应
在此用例中,您将看到一个针对特定需求定制的工作流的详细示例。
业务问题: 一位客户提交了一份德语技术支持工单,请求帮助在 SAP Signavio Process Manager 中配置通知,并附上了其电子邮件地址。支持系统需要提供准确且符合策略的响应,保护敏感的客户数据,并无缝处理语言障碍。如果无法自动给出完整答案,则应为人工坐席总结该问题。
编排工作流的实际运行: 支持系统收到一封电子邮件,从而使用客户的德语消息触发此工作流。
用户输入: 德语支持问题:"Betreff: Unterstützung benötigt. Nachricht: Hallo, ich benötige Unterstützung mit SAP Signavio. Insbesondere möchte ich Benachrichtigungen im SAP Signavio Process Manager konfigurieren. Bitte kontaktieren Sie mich mit unter Jane.Janeson@gmx.net."
锚定: 系统使用德语用户输入中的关键词,如 "SAP Signavio Process Manager"、"Benachrichtigungen",来查询官方的 help.sap.com 文档。检索到关于配置通知的相关文章,作为该问题或问题上下文的上下文。
模板化: 填充一个预定义的提示模板。其中包含系统指令:"You are a helpful support assistant. First, check if the provided context answers the issue. If yes, provide an email answer based only on the context. If no, summarize the issue (sentiment, key theme, contact) for a human support team." 该模板还包含原始德语支持问题和检索到的英语(或混合语言)锚定上下文。
输入掩码: 掩码模块在模板化后的提示中识别出 "Jane.Janeson@gmx.net" 并对其进行假名化(例如,将其替换为 [profile-email])。
输入过滤: 过滤模块扫描此掩码后的提示,以发现原始反馈中可能存在的任何有害或不当内容;此过滤可以配置为 'relaxed' 以降低其严格程度并允许更广泛的输入。当设置为 relaxed 时,系统对原本可能被标记的内容有更高的容忍度,通常是为了避免阻止合法的业务特定术语。
输入翻译: 此模块将德语文本翻译为英语,以便 LLM 更好地处理。
LLM 处理: LLM(例如 gpt-5)接收完全准备好的、安全且已掩码的英语提示。它根据锚定的 HR 政策分析反馈,并生成英语的摘要和主题分析。
输出过滤: filtering.output 模块扫描 LLM 生成的英语摘要,以确保其不包含有毒语言、偏见或不当建议。
输出翻译: 英语输出被翻译回德语,供用户使用。
实现的业务价值:
确保匿名性与合规性: 敏感的 PII 被掩码,内容被过滤,符合 HR 数据隐私政策。
快速生成洞察: 快速从大量反馈中识别趋势和问题,使 HR 能够更快响应。
基于锚定的分析: LLM 的分析以实际公司政策为依据,使其相关且可执行。
翻译: LLM 的输入和 LLM 的输出都经过翻译,以获得最佳用户体验。
效率: 自动化了劳动密集型的审查流程,使 HR 专业人员能够专注于战略举措。
成本优化: 通过省略不必要的翻译步骤,工作流减少了处理时间和相关成本。
用例 2:内部 HR 反馈分析
在此用例中,您将看到如何在不使用某些可选模块的情况下创建编排工作流。这是简化复杂工作流并使其适应特定业务需求所必需的。
业务问题: 内部人力资源部门定期通过调查表单收集员工反馈。这些表单通常以英语提交。HR 团队需要分析反馈中的常见主题、情绪以及潜在的政策违规,但必须严格确保员工匿名并过滤掉任何不当内容。最终摘要和分析需要为英语,以供内部报告使用。
编排工作流的实际运行: 一位 HR 分析师上传一批英语反馈表单,从而触发工作流。
用户输入: 员工反馈表单。
锚定: 系统使用反馈中的关键词(例如 "benefits"、"work-life balance")从 HR 知识库中搜索并检索相关的公司 HR 政策和内部最佳实践文档。这为 LLM 的分析提供了关键上下文。
模板化: 填充一个预定义的提示模板。其中包含系统指令:"You are an HR analyst. Summarize the key themes, sentiment, and actionable insights from the employee feedback. Ensure anonymity and highlight any potential policy violations (based on the provided HR policies). Make sure the output is concise and objective." 该模板整合了员工反馈和检索到的 HR 政策。
输入掩码: 掩码模块扫描模板化后的提示,查找可能被无意包含在反馈中的任何身份识别信息(例如员工姓名、ID,以及在此上下文中被视为敏感的特定部门名称)并对其进行假名化。
输入过滤: 过滤模块扫描此掩码后的提示,以发现原始反馈中可能存在的任何有害或不当内容;此过滤可以配置为 'relaxed' 以降低其严格程度并允许更广泛的输入。当设置为 relaxed 时,系统对原本可能被标记的内容有更高的容忍度,通常是为了避免阻止合法的业务特定术语。
输入翻译: (此模块未配置,或在此用例中被有效跳过)。由于用户输入已经是英语,且 LLM 以英语处理,因此不需要翻译。
LLM 处理: LLM(例如 gpt-5)接收完全准备好的、安全且已掩码的英语提示。它根据锚定的 HR 政策分析反馈,并生成英语的摘要和主题分析。
输出过滤: filtering.output 模块扫描 LLM 生成的英语摘要,以确保其不包含有毒语言、偏见或不当建议。
输出翻译: (此模块未配置,或在此用例中被有效跳过)。由于期望的输出是英语,因此不需要翻译回其他语言。
实现的业务价值:
确保匿名性与合规性: 敏感的 PII 被掩码,内容被过滤,符合 HR 数据隐私政策。
快速生成洞察: 此过程快速从大量反馈中识别趋势和问题,使 HR 能够更快响应。
基于锚定的分析: LLM 的分析以实际公司政策为依据,使其相关且可执行。
效率: 自动化了劳动密集型的审查流程,使 HR 专业人员能够专注于战略举措。
成本优化: 通过省略不必要的翻译步骤,工作流减少了处理时间和相关成本。
设计和部署编排工作流
对于开发人员来说,重要的是要理解这些复杂工作流是如何被高效定义和执行的。
统一的 API 和 SDK: 开发人员使用 SAP Cloud SDK for AI 定义编排模板,该模板是一个 JSON 文件,用于指定服务的顺序。这种模板化方法是平衡工作流固定逻辑顺序与动态的、特定于用例的配置的关键,使开发人员能够针对其独特需求精确定义每个步骤的运行方式。
单次 API 调用: 模板部署后,整个多步骤工作流可以通过一次统一的 API 调用执行。应用程序只需将初始查询发送到编排服务端点,该服务在内部管理整个事件链。这抽象掉了调用多个不同服务并在它们之间处理数据的复杂性。
这种方法极大地简化了开发、确保了一致性,并支持快速部署和修改复杂的 AI 驱动业务流程。
本课小结
您现在已通过遵循 SAP 官方工作流的实际示例,看到了编排服务的切实价值。您已理解,从锚定开始是企业级准确性的关键,而内容过滤和数据掩码等后处理步骤对于安全性和合规性至关重要。
这种内在结构提供了企业级的可靠性和可预测性,而每个模块内的配置确保工作流可以精确地适配各种业务问题。通过对这些服务进行排序,您可以将通用 LLM 转变为专门化、数据驱动且高度安全的业务工具,从而构建复杂且值得信赖的 AI 解决方案。
本课其余配图
本课其余配图
本课其余配图
本课其余配图