使用 SAP HANA 数据框架浏览数据
学习目标
使用 SAP HANA 数据框架进行数据处理。
使用 SAP HANA 数据框架的数据处理
本部分介绍如何使用 SAP HANA 数据框架在 SAP HANA Cloud 中管理和操作数据。预加载到 SAP HANA Cloud 中的 California 外壳数据集用作进一步说明此概念的示例 [1]。
使用 Python 创建 HANA 数据框架
SAP HANA 数据框架提供了一种在不包含任何物理数据的情况下查看 SAP HANA 中存储的数据的方法。HANA-ML 使用 SAP HANA DataFrame 作为训练和评分的输入。
SAP HANA DataFrame 隐藏基础 SQL 语句,为用户提供到 SAP HANA 数据的 Python 接口。
要使用 SAP HANA DataFrame,首先从 hana_ml.dataframe.ConnectionContext 类(到 SAP HANA 的连接)[2] 创建对象,然后使用库中提供的方法创建 SAP HANA DataFrame。
SAP HANA 数据框架仅在连接打开时可用,并且在连接关闭后不可访问。有关可用类和功能的完整文档,请参阅 [3]。
参考
[1] California 外壳数据集
从指定表中选择数据
方法 ConnectionContext.table() 返回表示指定表(即 "california_housing")及其相关模式(即 "ML_DEMO" [1])的 DataFrame。然后,我们显示支持 DataFrame 的 SQL 查询。
为了检查数据集,将显示 DataFrame 的列名称及其数据类型。
hdf = conn.table("california_housing", schema="ML_DEMO")
print(hdf.select_statement)
输出:
**SELECT * FROM "ML_DEMO"。"california_housing"**
print(hdf.columns)
输出:
**\['MedInc', 'HouseAge', 'AveRooms', 'AveBedrms', 'Population', 'AveOccup', 'Latitude', 'Longitude', 'Target'\]**
print(hdf.dtypes())
输出:
**[('MedInc', 'DOUBLE', 15, 15, 15, 0), ('HouseAge', 'DOUBLE', 'DOUBLE', 15, 15, 15, 0), ('AveRooms', 15, 15, 15'), ('AveBedrms', 'DOUBLE', 15', DOUBLE, 15', DOUBLE, 15', 15', DOUBE, 0)**
参考
[1] SAP hana_ml.dataframe - ConnectionContext.table()
根据给定,显示 SAP DataFrame 的前五个观测对象,然后方法 DataFrame.collect() 将当前 DataFrame 复制到新的 Python Pandas DataFrame [1]
#Only the use of the collect method, transfers data or result sets from SAP HANA to Python
hdf.head(5).collect()
**输出:**
MedInc |
家庭年龄 |
AveRooms |
AveBedrms |
群体 |
AveOccup |
纬度 |
经度 |
目标 |
|
|---|---|---|---|---|---|---|---|---|---|
0 |
1.24 |
52.0 |
2.92 |
0.91 |
396.0 |
4.65 |
37.80 |
-122.27 |
5.00 |
1 |
1.16 |
52.0 |
2.43 |
0.94 |
1349.0 |
5.39 |
37.87 |
-122.25 |
5.00 |
2 |
7.85 |
52.0 |
7.79 |
1.05 |
517.0 |
2.41 |
37.86 |
-122.24 |
5.00 |
3 |
9.39 |
52.0 |
7.51 |
0.95 |
1366.0 |
2.75 |
37.85 |
-122.24 |
5.00 |
4 |
7.87 |
52.0 |
8.28 |
1.04 |
947.0 |
2.62 |
37.83 |
-122.23 |
5.00 |
参考
分析数据属性
数据操作和分析在数据科学领域至关重要。SAP 类方法 DataFrame.describe() 返回包含数据属性或列 [1] 的各种统计信息的 DataFrame。
此类描述性统计信息包括汇总数据集分布的中心趋势、分散和形状的统计信息。这有助于以有意义的方式组织和呈现数据。
例如,标记为数字 3 的行(如下所示)显示"AveBedrms"列的统计信息。此列表示每个家庭的平均卧室数量。你将注意到数据集的其余列有"20,640"个观测对象。它没有空值,其平均值为 '1.09';但是,它可以获取最小值为 '0.33' 到最大值 '34.06' 的值。有趣的是,中间值为 '1.04' [4]。您应该记住,中间值代表数据集的中间值。
hdf.describe().collect()
列 |
计数 |
唯一 |
空值 |
平均值 |
Std |
最小值 |
最大 |
中间值 |
25_percent_cont |
25_percent_disc |
50_percent_cont |
50_percent_disc |
75_percent_cont |
75_percent_disc |
|
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
0 |
MedInc |
20640 |
12928 |
0 |
3.87 |
1.89 |
0.49 |
15.00 |
3.53 |
2.56 |
2.56 |
3.53 |
3.53 |
4.74 |
4.74 |
1 |
家庭年龄 |
20640 |
52 |
0 |
28.63 |
12.58 |
1.00 |
52.00 |
29.00 |
18.00 |
18.00 |
29.00 |
29.00 |
37.00 |
37.00 |
2 |
AveRooms |
20640 |
19392 |
0 |
5.42 |
2.47 |
0.84 |
141.90 |
5.22 |
4.44 |
4.44 |
5.22 |
5.22 |
6.05 |
6.05 |
3 |
AveBedrms |
20640 |
14233 |
0 |
1.09 |
0.47 |
0.33 |
34.06 |
1.04 |
1.00 |
1.00 |
1.04 |
1.04 |
1.09 |
1.09 |
4 |
群体 |
20640 |
3888 |
0 |
1425.47 |
1132.46 |
3.00 |
35682.00 |
1166.00 |
787.00 |
787.00 |
1166.00 |
1166.00 |
1725.00 |
1725.00 |
5 |
AveOccup |
20640 |
18841 |
0 |
3.07 |
10.38 |
0.69 |
1243.33 |
2.81 |
2.42 |
2.42 |
2.81 |
2.81 |
3.28 |
3.28 |
6 |
纬度 |
20640 |
862 |
0 |
35.63 |
2.13 |
32.54 |
41.95 |
34.26 |
33.93 |
33.93 |
34.26 |
34.26 |
37.71 |
37.71 |
7 |
经度 |
20640 |
844 |
0 |
-119.56 |
2.00 |
-124.35 |
-114.31 |
-118.49 |
-121.80 |
-121.80 |
-118.49 |
-118.49 |
-118.01 |
-118.01 |
8 |
目标 |
20640 |
3842 |
0 |
2.068 |
1.15 |
0.14 |
5.00 |
1.79 |
1.19 |
1.19 |
1.79 |
1.79 |
2.64 |
2.64 |
参考
[1] SAP 方法 hana_ml.dataframe - DataFrame.describe()
[2] 统计信息:中值
SAP HANA 数据框架过滤
可以选择符合给定条件的行。
例如,以下代码选择"总体"大于 '300' 的行的子集。然后显示前五行,以确认所有"总体"值均超过 '300'。
hdf_filter=hdf.filter('"Population">300')
print(hdf_filter.select_statement)
输出:
**SELECT * FROM (SELECT * FROM "ML_DEMO"."california_housing") AS "DT_258" WHERE "Population">300**
hdf_filter.head(5).collect()
MedInc |
家庭年龄 |
AveRooms |
AveBedrms |
群体 |
AveOccup |
纬度 |
经度 |
目标 |
|
|---|---|---|---|---|---|---|---|---|---|
0 |
1.24 |
52.0 |
2.92 |
0.91 |
396.0 |
4.65 |
37.80 |
-122.27 |
5.00 |
1 |
1.16 |
52.0 |
2.43 |
0.94 |
1349.0 |
5.39 |
37.87 |
-122.25 |
5.00 |
2 |
7.85 |
52.0 |
7.79 |
1.05 |
517.0 |
2.41 |
37.86 |
-122.24 |
5.00 |
3 |
9.39 |
52.0 |
7.51 |
0.95 |
1366.0 |
2.75 |
37.85 |
-122.24 |
5.00 |
4 |
7.87 |
52.0 |
8.28 |
1.04 |
947.0 |
2.62 |
37.83 |
-122.23 |
5.00 |
使用 SAP HANA DataFrame 的可视化数据发掘
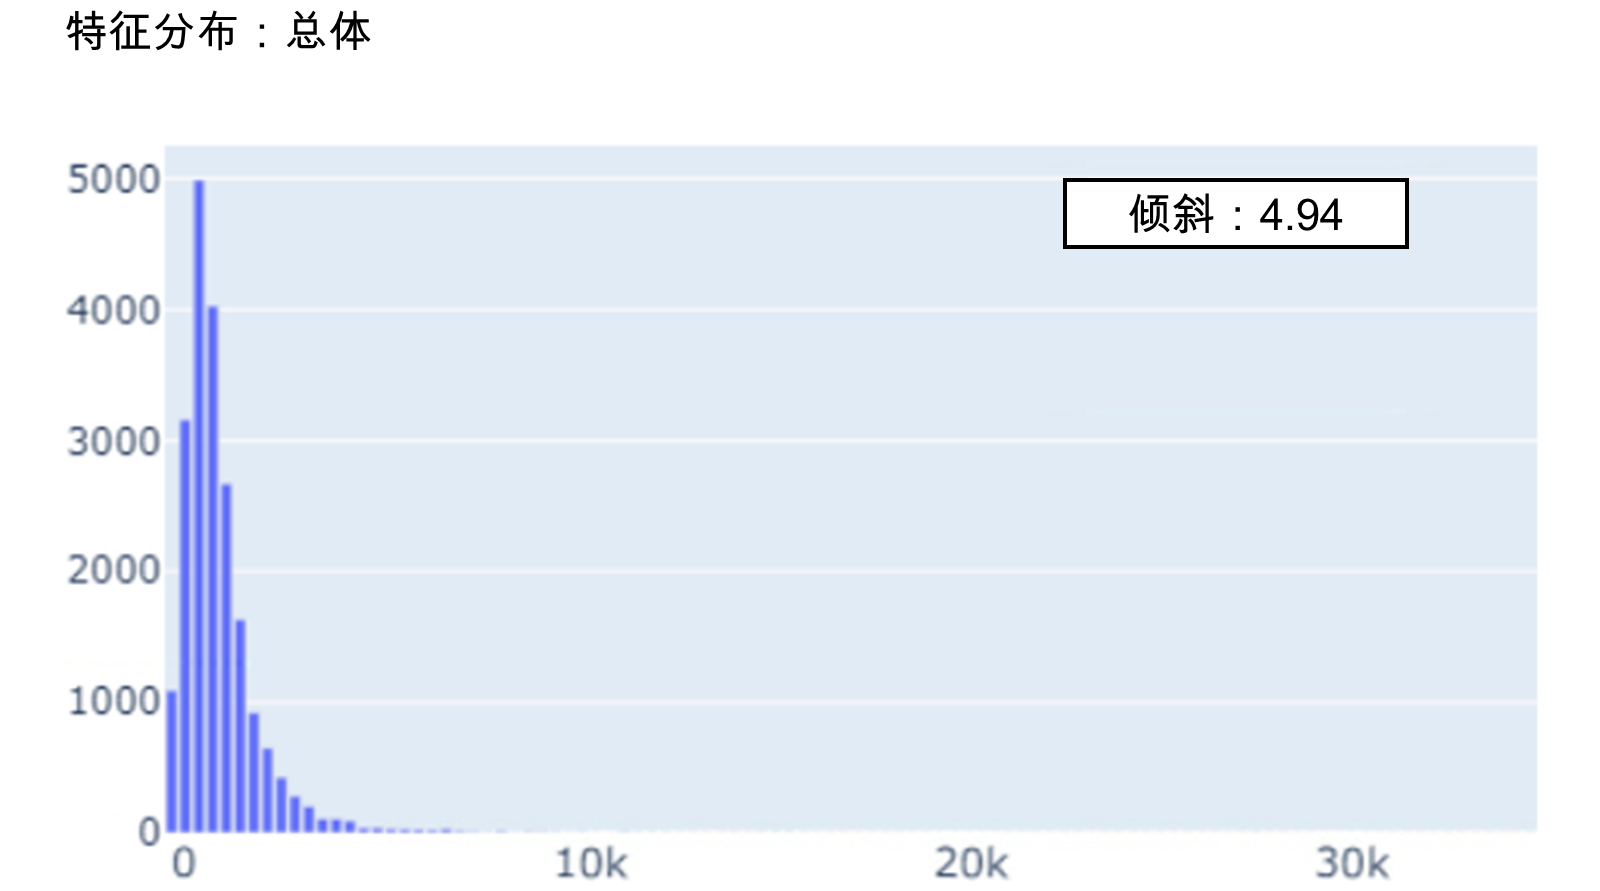
描述性统计还涉及通过图的数据的图形表示。他们可以进一步帮助可视化和解释信息。
通过使用说明性统计信息,可以汇总和共享数据集的主要属性。因此,获得对数据的更深入洞察以支持:
进一步统计分析
决策流程
可以使用 HANA 功能 [1] 可视化名为"总体"的 SAP HANA DataFrame 列的分布图。
#Exploratory Data Visualizations
from hana_ml.visualizers.eda import EDAVisualizer

start = time.time()

eda = EDAVisualizer(enable_plotly=True)
fig, trace, bin_data = eda.distribution_plot(data=hdf, debrief=True, column="Population", bins=60, x_axis_fontsize=13, x_axis_rotation=1, width=600, title="Distribution of feature: Population", height=400)
fig.show()

end = time.time()
print("Time taken to do this by getting the data from the server was: {}s".format(round(end-start, 3)))
输出:
**通过从服务器获取数据完成此操作所花费的时间是:0.08 秒**
参考
[1] SAP hana_ml.visualizers.eda - EDAVisualizer.distribution_plot
将索引添加到数据集
请注意,数据集必须具有"标识"列以将其分区为不相交子集。稍后用于派生支持执行机器学习工作流的"训练"和"测试"子集的分区算法 [1] 需要它。
确保此列包含在数据集中,如下所示。
标识 |
MedInc |
家庭年龄 |
AveRooms |
AveBedrms |
群体 |
AveOccup |
纬度 |
经度 |
目标 |
|
|---|---|---|---|---|---|---|---|---|---|---|
0 |
1 |
1.24 |
52.0 |
2.92 |
0.91 |
396.0 |
4.65 |
37.80 |
-122.27 |
5.00 |
1 |
2 |
1.16 |
52.0 |
2.43 |
0.94 |
1349.0 |
5.39 |
37.87 |
-122.25 |
5.00 |
2 |
3 |
7.85 |
52.0 |
7.79 |
1.05 |
517.0 |
2.41 |
37.86 |
-122.24 |
5.00 |
3 |
4 |
9.39 |
52.0 |
7.51 |
0.95 |
1366.0 |
2.75 |
37.85 |
-122.24 |
5.00 |
4 |
5 |
7.87 |
52.0 |
8.28 |
1.04 |
947.0 |
2.62 |
37.83 |
-122.23 |
5.00 |
参考
[1] SAP 算法 hana_ml.alithms.pal.partition - train_test_val_split。